はじめに
P-Image LoRA テキストから画像 は、Pruna AI の速度重視のテキストから画像モデル P-Image で、好きな LoRA ファイルを 1 つ読み込んだ状態で、文章のプロンプトから画像を 1 枚描きます。アスペクト比は 7 種類から選ぶか、1 辺 1440 ピクセルまでのカスタムサイズを指定できます。プラットフォームは、プロンプト、ウェイト、画像のいずれにもコンテンツフィルターを加えません。
手元の素材からモードを選ぶ
| 手元にあるもの | モード |
|---|---|
| 文章で書いた説明 | P-Image LoRA テキストから画像 |
| 変更したい画像が 1 枚以上 | P-Image LoRA 画像編集 |
主な機能とハイライト
1 枚数秒
Pruna は P-Image を速度重視で作っています。当社のテストでは、LoRA なしで 1 枚あたり 3〜5 秒ほど、LoRA ファイルを初めて取得するときはさらに数秒かかりました。
LoRA 1 つで、まったく新しいルックに
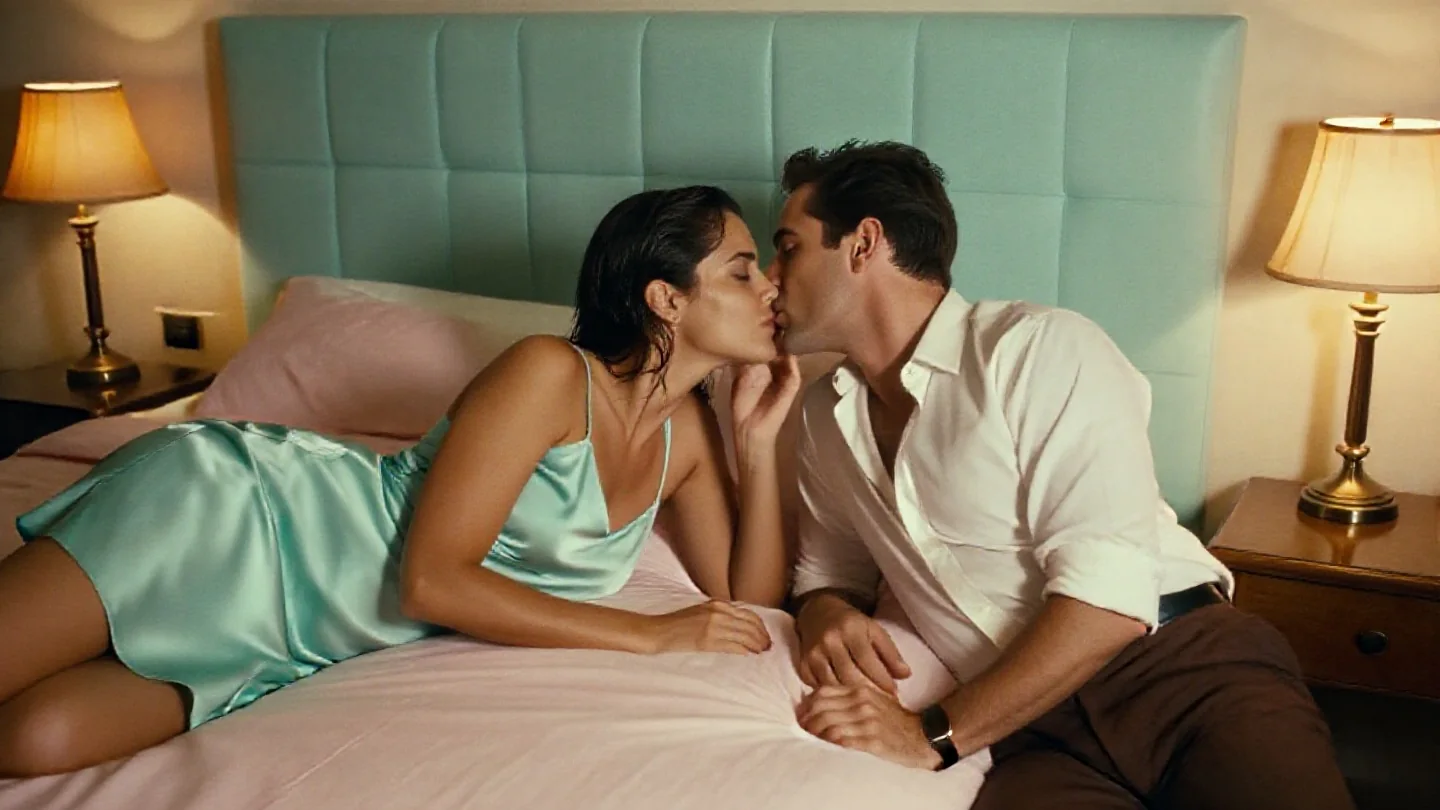
フィルム調の色合いの LoRA、フラッシュスナップ風 LoRA、色鉛筆 LoRA は、当社のテストでそれぞれ画像全体を変えました。LoRA は公開リンクから読み込まれ、事前に当社へアップロードするものはなく、ファイルが審査されることもありません。
カスタムサイズ
約 100 万画素の 7 種類の比率に加えて、幅と高さを 256 から 1440 ピクセルまで 16 刻みで指定でき、正方形のサムネイルから横長の 1440 x 608 のパノラマまで対応します。
コンテンツフィルターなし
何もフィルターされず、拒否もされません。モデルは強めまでのすべてのレベルを、女性にも男性にも書いたとおりに出力し、最大のレベルも出力します。かなり強めの依頼は、当社のテストで人体の描写の誤りを伴って出てきました。フィルターなしの LoRA が必要になるのはこの場面です。
リクエストパラメーター
| パラメーター | 必須 | 説明 |
|---|---|---|
prompt | はい | 文章で書くのが最適です。被写体、服装、場所、光、レンズを。 1 文字以上 · 5000 文字以内 |
aspect_ratio | いいえ | 約 100 万画素の 7 種類の比率です。1:1 は 1024 x 1024、16:9 は 1344 x 768、3:2 は 1216 x 832、4:3 は 1152 x 896。 |
width | いいえ | アスペクト比が custom のときだけ使われます。256 から 1440 ピクセルまで 16 刻みで、既定は 1024 です。 |
height | いいえ | アスペクト比が custom のときだけ使われます。256 から 1440 ピクセルまで 16 刻みで、既定は 1024 です。 |
loras | いいえ | {path, scale} を 1 つ。P-Image トレーナーで作った、または Z-Image Turbo 向けに学習した .safetensors ファイルへの公開の直接リンクを使います。 デフォルト値: |
output_format | いいえ | 既定は JPEG で、PNG や WebP も選べます。形式で料金は変わりません。 |
seed | いいえ | 言葉を 1 つずつ、または LoRA の strength を変えていく間、画像のセットを比べられる状態に保ちます。毎回まったく同じピクセルになることは保証しません。 |
料金
$0.006 / 枚
1 枚ごとに課金されます。アスペクト比、カスタムサイズ、出力形式、LoRA の読み込みで料金は変わりません。
ユースケース
下書きの速さでハウススタイルを
スタイル LoRA を 1 つ読み込み、トリガーワードを先頭に置いたまま、プロンプトのリストを流します。どの画像も同じルックで、1 枚ずつ数秒で返ります。
公開 LoRA を試す
何かを作り込む前に、コミュニティの LoRA を実際のプロンプトで試せます。ファイルの有無にかかわらず、1 枚の料金は同じです。
変わった判型
バナー、パノラマ、縦長のストリップを、あとから切り抜かずにピクセル指定のサイズで。
プロンプトガイドと実践のヒント
文章で書く
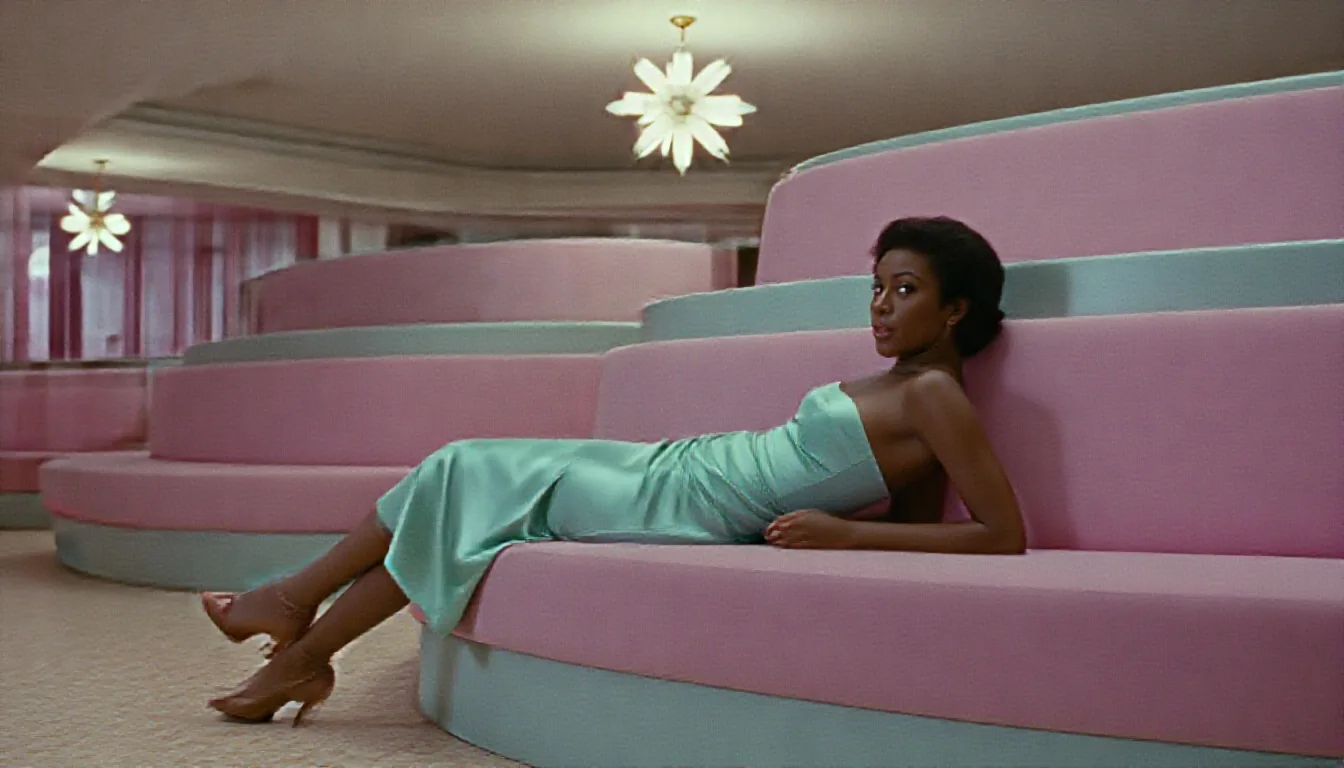
被写体、服装、場所、光、レンズを説明してください。真鍮のエレベーターの門やスターバースト型のシャンデリアといったディテールも、書いたとおりに出ました。
トリガーワードを先頭に
スタイル LoRA は、プロンプトの冒頭にトリガーがあることを前提にしています。同じ seed でファイルありとなしを比べると、LoRA 自体が何を足しているかが分かります。
strength は控えめに
0.6〜1 あたりでスタイル LoRA ははっきり出ます。当社のテストでは 2 で画像が崩れ始め、3 ではノイズになりました。負の値は LoRA のルックから離れる方向に働きますが、結果にはムラがありました。
このモデル向けの LoRA を選ぶ
P-Image トレーナーで作った LoRA と、当社のテストでは Z-Image Turbo 向けに学習したコミュニティ LoRA が読み込めました。FLUX や SDXL 系モデル向けの LoRA は、リクエストが失敗しました。
API クイックスタート
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "pruna-ai/p-image-lora/text-to-image",
  "input": {
    "aspect_ratio": "1:1",
    "output_format": "jpeg",
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
認証、完全なスキーマ、ポーリング、エラー処理は API リファレンスを参照してください。