Aller au contenu principal

daVinci-MagiHuman API

sand-ai/davinci-magihuman/image-to-video

L’image vers vidéo de daVinci-MagiHuman lance un clip de 5 à 10 secondes à partir de votre photo, avec du mouvement et une voix : placez la réplique entre guillemets dans le prompt, ou joignez votre propre audio. En 256p, 720p ou 1080p, en 16:9 ou 9:16.

À partir de $0.024/s

Atelier

Entrée

Image vers vidéo
211/5000
Décrivez ce qui se passe après la photo : ce que fait la personne et, entre guillemets, ce qu’elle dit. Avec audio_url renseigné, ne mettez pas de paroles et décrivez l’ambiance, le mouvement et la lumière. 3 caractères minimum · 5000 caractères maximum
1/1

Déposez des fichiers ou des liens de médias, collez ou parcourez · 1 fichier · 10 Mo max. · JPG · PNG · WEBP

  • 1
1 / 1 fichiers
La première image. Un lien public, téléchargeable directement ; le clip part de cette photo.
0/1

Déposez un fichier audio ou parcourez · 1 fichier · 90 Mo max. · MP3 · WAV

0 / 1 fichiers
Facultatif. Lien public vers un fichier de parole ou de chanson ; la vidéo est générée en synchronisation avec lui au lieu d’inventer une voix. Notre essai a utilisé un enregistrement de 5 secondes pour un clip de 5 secondes.
16:9 (par défaut) ou 9:16. Nos essais en image vers vidéo ont utilisé le 16:9. Le format ne change pas le prix.
influe sur le prix
256p, 720p (par défaut) ou 1080p. Les niveaux supérieurs coûtent davantage à la seconde. Le modèle génère à basse résolution et son propre étage de super-résolution produit les niveaux supérieurs ; nos essais en 720p sont revenus à environ 1358 x 678.
Duréeinflue sur le prix
De 5 à 10 secondes, 5 par défaut, facturées à la seconde. pas inférieur à 5 · pas supérieur à 10
Seed
Entier facultatif. La même seed avec les mêmes entrées donne des résultats similaires, et non garantis identiques. pas inférieur à 0 · pas supérieur à 2147483647
Filtre de sécuritéDésactivé

SpicyAPI n’applique aucun filtre de sécurité à ce modèle. Votre prompt et vos médias sont transmis tels quels, et c’est le modèle lui-même qui décide du résultat.

Nous vérifions votre compte avant d’activer l’envoi et le calcul du prix.

Sortie

Prêt pour une nouvelle exécution
Rendu d’exemple

Le modèle que vous cherchez n’est pas là ?

Dites-nous lequel ajouter et à quoi il vous servira. Les demandes vont directement à l’équipe qui décide des prochains modèles.

API VIDÉO PARLANTE

L’API daVinci-MagiHuman en un coup d’œil

Un modèle de 15 Md de paramètres qui génère ensemble l’image et la voix : une personne qui parle face caméra, à partir d’un texte ou d’une photo, en 5 à 10 secondes jusqu’à 1080p.

Paramètres
15 Md
Un seul modèle génère l’image et la bande sonore ensemble. Les poids sont ouverts sous licence Apache 2.0.
Durée du clip
5–10 s
Choisissez une durée de 5 à 10 secondes ; la valeur par défaut est 5. Nos clips sont revenus à 25 fps.
Résolution maximale
1080p
256p, 720p (par défaut) ou 1080p. Le modèle génère à basse résolution, et son propre étage de super-résolution produit les niveaux supérieurs ; les dimensions reviennent proches des valeurs nominales, par exemple environ 1904 x 1088 en 1080p.
Formats
2
Paysage 16:9 (par défaut) ou portrait 9:16, sur les deux points de terminaison. Le son et le format ne changent pas le prix.
Votre propre audio
Option
Envoyez un fichier de parole ou de chanson dans audio_url : la vidéo est générée en synchronisation avec lui, au lieu d’inventer une voix.
Langues parlées
6
Chinois (mandarin et cantonais), anglais, japonais, coréen, allemand et français, selon la liste de l’éditeur. Nous avons testé l’anglais.

Résultats

Ce que vous pouvez créer avec daVinci-MagiHuman

  • Texte vers vidéo

    Une réplique, dite sur le balcon

    Un seul prompt avec une réplique entre guillemets a donné un clip en 1080p : une femme au carré blond platine, sur un balcon de nuit, les lumières de la ville floues derrière elle. Il est revenu à environ 1904 x 1088 à 25 fps, 5,0 secondes, avec son, et notre transcription de la bande sonore correspondait à la réplique mot pour mot. Le traitement a pris environ 3 min 53 s.

    Texte vers vidéo, 1080p, 16:9, cinq secondes, avec la réplique entre guillemets prononcée sur la bande sonore.

  • Portrait

    Un clip vertical avec un rire et une réplique

    Avec le format réglé sur 9:16, un homme couvert de taches de rousseur, aux cheveux roux, dans une rue humide éclairée au néon, rit et dit sa réplique. En 720p, il est revenu à environ 726 x 1270, 5,0 secondes, et la transcription correspondait mot pour mot. Le traitement a pris environ une minute. Nous avons écrit « looks straight into the camera » plutôt que de demander un selfie.

    Texte vers vidéo en portrait, 9:16 en 720p, cinq secondes, avec la réplique entre guillemets prononcée sur la bande sonore.

  • Image vers vidéo

    Une photo qui se tourne et parle

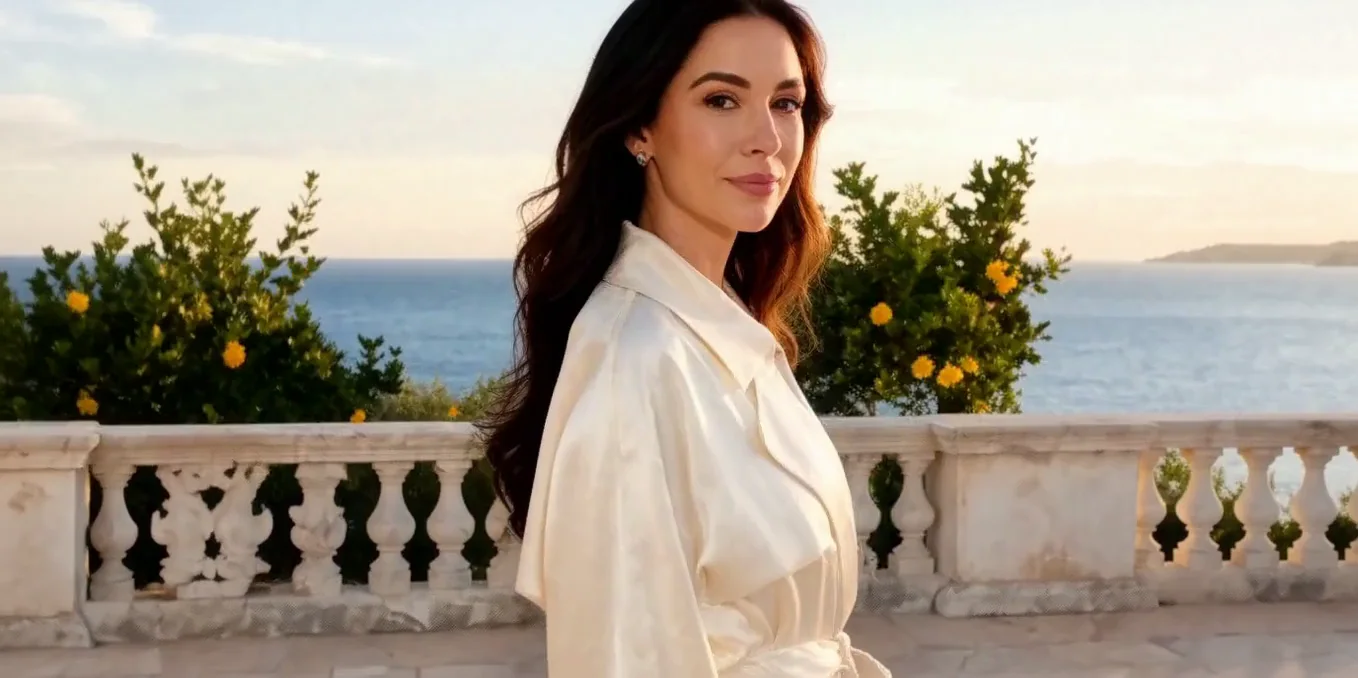
    À partir d’une image de première image et d’un prompt, sans fichier audio, elle se détourne de la mer, replace une mèche derrière l’oreille et prononce la réplique. La transcription correspondait mot pour mot. En 720p, le clip est revenu à environ 1358 x 678, 5,0 secondes, après environ 1 min 45 s.

    Image vers vidéo sans fichier audio, 16:9 en 720p, cinq secondes, avec la réplique entre guillemets prononcée sur la bande sonore.

  • Votre propre audio

    Un portrait qui suit votre enregistrement

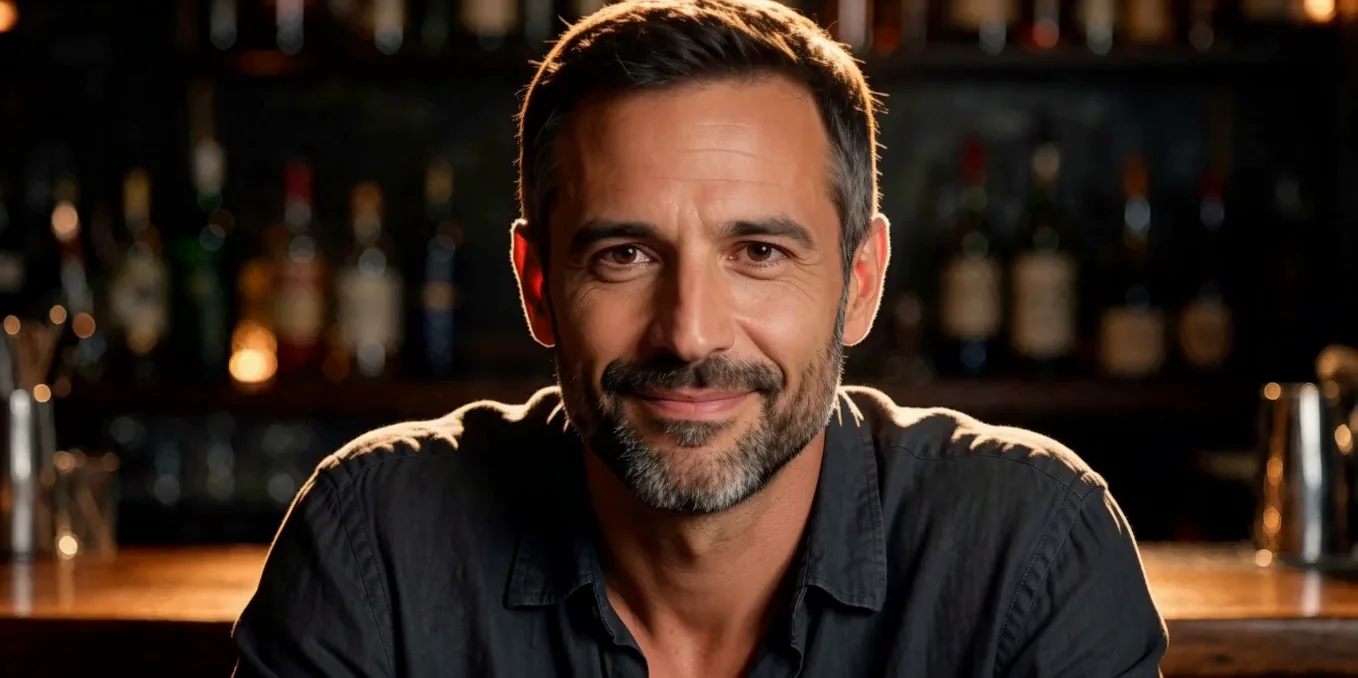
    Avec un clip parlé de 5 secondes en audio_url, les lèvres ont suivi l’audio fourni, avec un demi-sourire et un mouvement de sourcil, et le visage est resté proche du portrait d’entrée. En 720p, le clip est revenu à environ 1358 x 678, 5,0 secondes, après environ 3 min 7 s.

    Image vers vidéo avec un clip parlé de 5 secondes en audio_url, 16:9 en 720p, cinq secondes.

Avant de lancer

À savoir avant de lancer daVinci-MagiHuman

Tous les modes
Les clips durent de 5 à 10 secondes, en 256p, 720p ou 1080p, en 16:9 ou 9:16. Les dimensions reviennent proches des valeurs nominales, sans être exactes : le 720p en 16:9 a donné environ 1358 x 678 et le 1080p environ 1904 x 1088. Nous avons testé la parole en anglais et n’avons pas testé le chant. Ce que montre un clip dépend de votre prompt et de notre politique d’utilisation.
Texte vers vidéo
La personne et la scène viennent de vos mots : décrivez donc le cadrage. Une demande de selfie avec un téléphone a fait apparaître un téléphone dans le cadre lors d’un test supplémentaire. Nous n’avons pas utilisé audio_url sur ce point de terminaison.
Image vers vidéo
Une image de première image est obligatoire, et le clip part de celle-ci. Tous nos essais en image vers vidéo ont utilisé le 16:9. Avec audio_url, nous avons testé un enregistrement de 5 secondes sur un clip de 5 secondes, sans tester d’enregistrement plus court ou plus long que le clip.

Cas d’usage

Ce que vous pouvez construire avec l’API daVinci-MagiHuman

  • Courts clips parlés

    Une personne dit une réplique face caméra en 5 à 10 secondes : une introduction, une bande-annonce, un salut, avec la voix générée pour vous.

  • Clips verticaux pour téléphone

    Réglez le format sur 9:16 pour les fils d’actualité et les stories. Notre test en portrait à 720p est revenu à environ 726 x 1270.

  • Un portrait qui parle avec votre enregistrement

    Partez d’une photo et ajoutez un fichier de parole en audio_url : les lèvres suivent votre audio et le visage reste proche de la photo.

  • Tests de personnage et de dialogue

    Testez l’apparence et la voix d’un personnage sur une photo de première image, avec une courte réplique entre guillemets, avant de construire une pièce plus longue. Nous avons testé l’anglais ; l’éditeur liste cinq autres langues.

Prompts

Exemples de prompts daVinci-MagiHuman à copier

Collez-en un tel quel dans le playground, puis changez une seule chose à la fois.

  • Texte vers vidéo

    Qui, où, la réplique entre guillemets, puis la lumière

    Résultat de ce prompt

    Close-up at night on a hotel balcony, city lights blurred behind. A woman in her thirties with a short platinum bob and a black slip dress leans on the rail, looks into the camera with a sly smile and says softly: "You really thought I'd leave without saying goodbye?" Warm practical light, shallow depth of field.

    Pourquoi ça marche. La personne et le lieu viennent en premier, la réplique reste entre guillemets avec sa manière d’être dite, et la lumière clôt le prompt. Notre transcription correspondait à la réplique mot pour mot.

    Essayer ce prompt
  • Texte vers vidéo

    Dire où se pose le regard

    Résultat de ce prompt

    Vertical medium close-up on a rainy neon-lit street at night. A man in his late twenties with freckles, short ginger hair and a wet denim jacket looks straight into the camera, laughs and says: "Okay, I'm lost, but honestly? Best night of the trip." Rain drips from his hair, pink and blue sign reflections on the wet pavement behind him. Handheld, eye level.

    Pourquoi ça marche. « Looks straight into the camera » a fixé le cadrage. Lors d’un essai supplémentaire, demander un selfie avec un téléphone a plutôt fait apparaître un téléphone dans le cadre.

    Essayer ce prompt
  • Image vers vidéo

    Donner à la photo un instant suivant

    Résultat de ce prompt

    On a sunlit stone terrace above the sea, she turns from the view to the camera, tucks her hair behind her ear and says warmly: "Stay for one more sunset. The boat can wait." Gentle sea breeze, soft golden light.

    Pourquoi ça marche. Le prompt décrit ce qu’elle fait après la photo : elle se tourne vers la caméra, replace ses cheveux, parle. Les trois se sont produits et la transcription correspondait.

    Ce mode part de votre propre image : ajoutez-la dans le playground avant de lancer.

    Essayer ce prompt
  • Image vers vidéo

    Avec votre propre voix, décrire l’allure

    Résultat de ce prompt

    Leaning on the bar, he speaks low and teasing, a slow half smile and a raised eyebrow, warm amber light.

    Pourquoi ça marche. Les mots viennent de l’enregistrement fourni, donc le prompt se contente de fixer l’ambiance, le mouvement et la lumière. Les lèvres ont suivi l’audio, avec un demi-sourire et un mouvement de sourcil.

    Ce mode part de votre propre image : ajoutez-la dans le playground avant de lancer.

    Essayer ce prompt

Comparer

daVinci-MagiHuman face aux modèles proches : lequel choisir

ModèleModesÀ partir deContenuÀ choisir si
OmniHuman 2.0Avatar parlant$0.108 / seconde produiteFiltré — Ce modèle refuse franchement les demandes qui dépassent ses propres limites. Résultat mesuré, non supposé ; les modèles que nous n’avons pas mesurés ne portent aucune mention.Vous avez déjà l’enregistrement vocal et un portrait, et vous voulez un clip plus long, jusqu’à 300 secondes, piloté par cet audio. Choisissez plutôt daVinci-MagiHuman si vous voulez que le modèle prononce une réplique que vous écrivez entre guillemets, ou si vous avez besoin d’un clip en 9:16.
Kling Avatar 2.0Avatar parlant$0.051 / seconde produiteFiltré — Ce modèle refuse franchement les demandes qui dépassent ses propres limites. Résultat mesuré, non supposé ; les modèles que nous n’avons pas mesurés ne portent aucune mention.Vous avez un portrait et votre propre audio, et voulez un clip piloté par cet audio, la même idée qu’OmniHuman 2.0. Choisissez plutôt daVinci-MagiHuman si vous voulez que le modèle prononce une réplique que vous écrivez entre guillemets.

Tarifs

Tarifs de l’API daVinci-MagiHuman

Un clip de 5 secondes est proposé à partir de $0.12 en 256p et de $0.36 en 1080p.

Le playground affiche le prix exact de vos réglages avant le lancement. Les tâches échouées ou expirées ne sont généralement pas facturées. Certains modèles facturent les refus de contenu comme indiqué sur leur page ; consultez ces conditions avant l’envoi.

Voir tous les paliers de prix

Démarrer

Utiliser l’API daVinci-MagiHuman en trois étapes

  1. Étape 1

    Placez la réplique entre guillemets

    Le modèle prononce ce qui figure entre guillemets. Dites qui parle et comment (doucement, chaleureusement, en riant), puis la réplique elle-même. Nos trois répliques comptaient 8 à 10 mots pour un clip de 5 secondes, et chacune est revenue mot pour mot.

  2. Étape 2

    Décrivez le cadrage, pas un appareil

    Lors d’un test supplémentaire en 9:16, demander un selfie avec un téléphone a placé dans le cadre un téléphone orienté vers la caméra depuis l’arrière. Écrivez plutôt « looks straight into the camera » et la taille du plan (« vertical medium close-up »).

  3. Étape 3

    Apportez votre propre voix avec audio_url

    Avec un fichier de parole ou de chanson joint, le prompt n’a plus besoin des paroles. Décrivez l’ambiance, le mouvement et la lumière : les lèvres suivent l’enregistrement. Lors de notre test, un enregistrement de 5 secondes correspondait à un clip de 5 secondes.

La référence des paramètres et les exemples de code se trouvent dans les onglets API et Readme, en haut de cette page.

Pourquoi SpicyAPI

Pourquoi utiliser daVinci-MagiHuman sur SpicyAPI

  • Aucun filtre de notre part

    Nous n’ajoutons aucun filtre de contenu. Ce que le modèle génère, vous le recevez.

  • Testé, pas supposé

    Les niveaux de contenu viennent de vraies générations que nous avons lancées et vérifiées, avec la date du test sur la page.

  • Payer au résultat, en dollars

    Ni abonnement ni crédits. Les tâches échouées ou expirées ne sont généralement pas facturées. Certains modèles facturent les refus de contenu comme indiqué sur leur page ; consultez ces conditions avant l’envoi.

  • Une clé pour tous les modèles

    Une seule clé API et un seul solde couvrent les modèles d’image, de vidéo, d’audio et de chat ; explorez davantage de modèles depuis le même compte.

FAQ

FAQ de l’API daVinci-MagiHuman

À propos de daVinci-MagiHuman

daVinci-MagiHuman met le modèle ouvert de 15 milliards de paramètres de Sand.ai et SII-GAIR derrière une seule API : texte vers vidéo et image vers vidéo, avec l’image et la voix générées ensemble, de 5 à 10 secondes en 256p, 720p ou 1080p, en 16:9 ou 9:16, avec la possibilité d’apporter votre propre audio. La facturation se fait à la seconde de la durée demandée, et les requêtes en échec ne sont pas facturées.

Modèles liés et tâches suivantes