はじめに
Kling 3.0 のテキストから動画は、画像や駆動動画を一切使わずに、書いたプロンプトをクリップに変えます。長さを丸 3〜15 秒、解像度を 720p、1080p、4K のいずれか、アスペクト比を 16:9、9:16、1:1 のいずれかに設定します。generate_audio をオンにすると、セリフ、効果音、環境音が映像と同じ工程で生成されます。shot_type で 1 つの連続したセットアップを保つか、可灵に自らマルチショットの編集を任せるかを選べます。
開始素材で Kling 3.0 のモードを選ぶ
| 手元にあるもの | モード |
|---|---|
| 書いたシーンや脚本 | Kling 3.0 テキストから動画(現在のモード) |
| 開始フレーム、任意で終了フレームも | Kling 3.0 画像から動画 |
| キャラクター写真と駆動クリップ | Kling 3.0 Motion Control |
主な機能とハイライト
セリフと環境音が同じファイルの中に
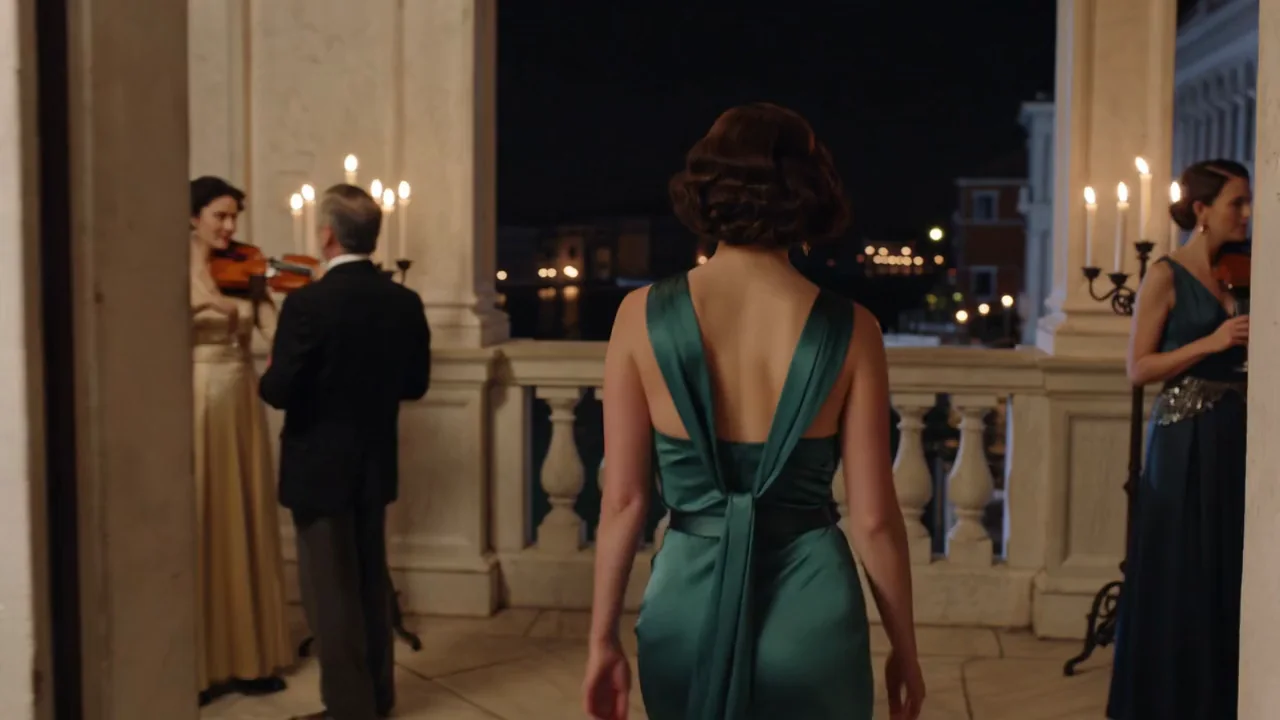
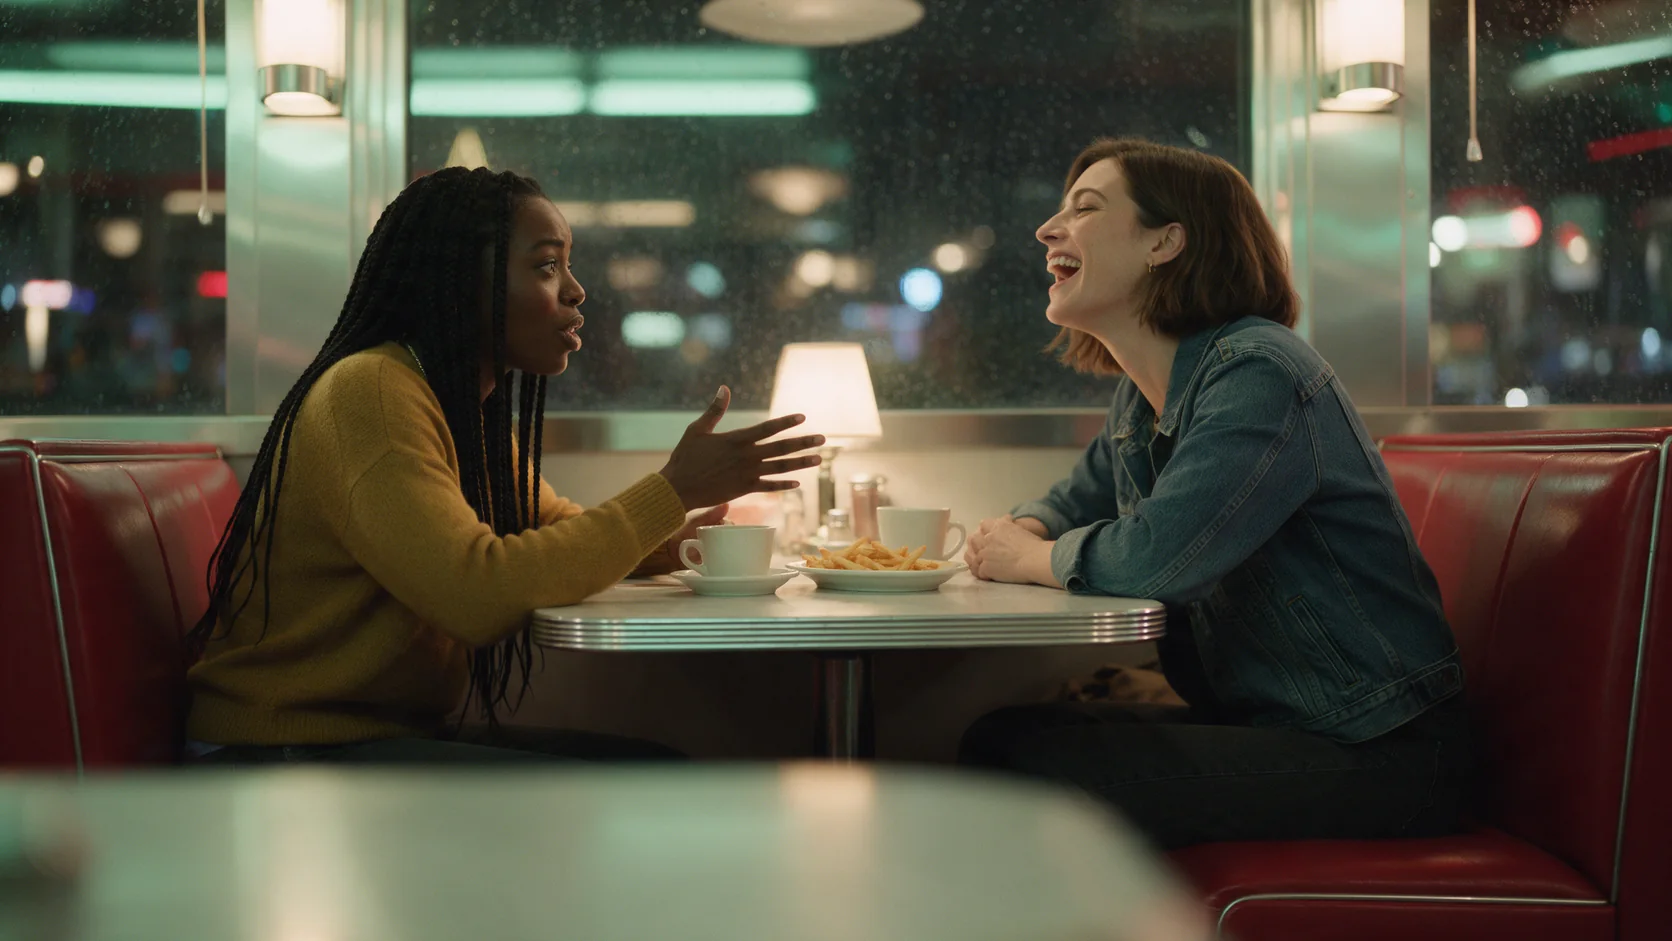
generate_audio をオンにすると、プロンプトに引用符で書いたセリフが、映像に合わせたタイミングの可聴なセリフとして、描写した環境音とともに返ってきます。当社のテストでは「Don't wait up」というセリフが、弦楽四重奏とパーティーのざわめきの上に、1 段落の文章だけから話し言葉として返ってきました。
複数ショットを扱う 2 つの方法
shot_type を single にすると、ほとんどの実行でカメラは 1 つのセットアップに留まりますが、それでも自発的にカットすることがあります。当社のテストでは、2 本の単一ショットのクリップで途中に余分なカットが入り、1 回は光が変化しました。プロンプトに「1 つの連続したショット、カットなし」を加えると、再テストではショットがまとまりました。shot_type を multi にすると、可灵が自らカットを決めます。
720p、1080p、4K
3 つの解像度すべてと音声の切り替えが価格を変えます。タイミングとフレーミングは 720p で下書きし、気に入ったテイクをレンダリングに見合うようになったら 4K で実行してください。
リクエストパラメーター
| パラメーター | 必須 | 説明 |
|---|---|---|
prompt | はい | 被写体、動作、カメラ、そして音声をオンにする場合は欲しいセリフと音を描写してください。 1 文字以上 · 2500 文字以内 |
negative_prompt | いいえ | クリップに入れたくないもの(物、見た目、動き)を最大 2,500 文字で指定します。任意で、料金は変わりません。 2500 文字以内 |
aspect_ratio | いいえ | 16:9、9:16、1:1。クリップ全体で固定され、代わりに従う元フレームはありません。 |
resolution | いいえ | 720p、1080p、4K。上位階層ほど秒あたりの費用が上がります。 |
generate_audio | いいえ | 同じクリップに生成されたサウンドトラック――引用符内のセリフ、効果音、環境音――を加えます。720p と 1080p では無音より秒あたりの料金が高くなりますが、4K では音声の有無で料金は変わりません。 デフォルト値: |
duration_seconds | いいえ | 丸秒単位で 3 から 15。価格を左右します。 |
shot_type | いいえ | single はほとんどの実行で 1 つのセットアップを保ちますが、それでも自発的にカットすることがあります。multi は可灵に自らマルチショットの編集を任せます。 |
multi_prompt | いいえ |
|
guidance_scale | いいえ | クリップがプロンプトにどれだけ忠実に従うかを 0〜1 で指定します(既定 0.5)。高いほど文面に沿い、低いほどモデルに自由度を与えます。 |
料金
出力秒数ごとに課金されます。解像度と音声の切り替えの両方が単価を変えます。
| 解像度 | 音声を生成: いいえ | 音声を生成: はい |
|---|---|---|
| $0.0672 / 秒 | $0.1008 / 秒 |
| $0.0896 / 秒 | $0.1344 / 秒 |
| $0.336 / 秒 | $0.336 / 秒 |
ユースケース
本物の音声でシーンを開く
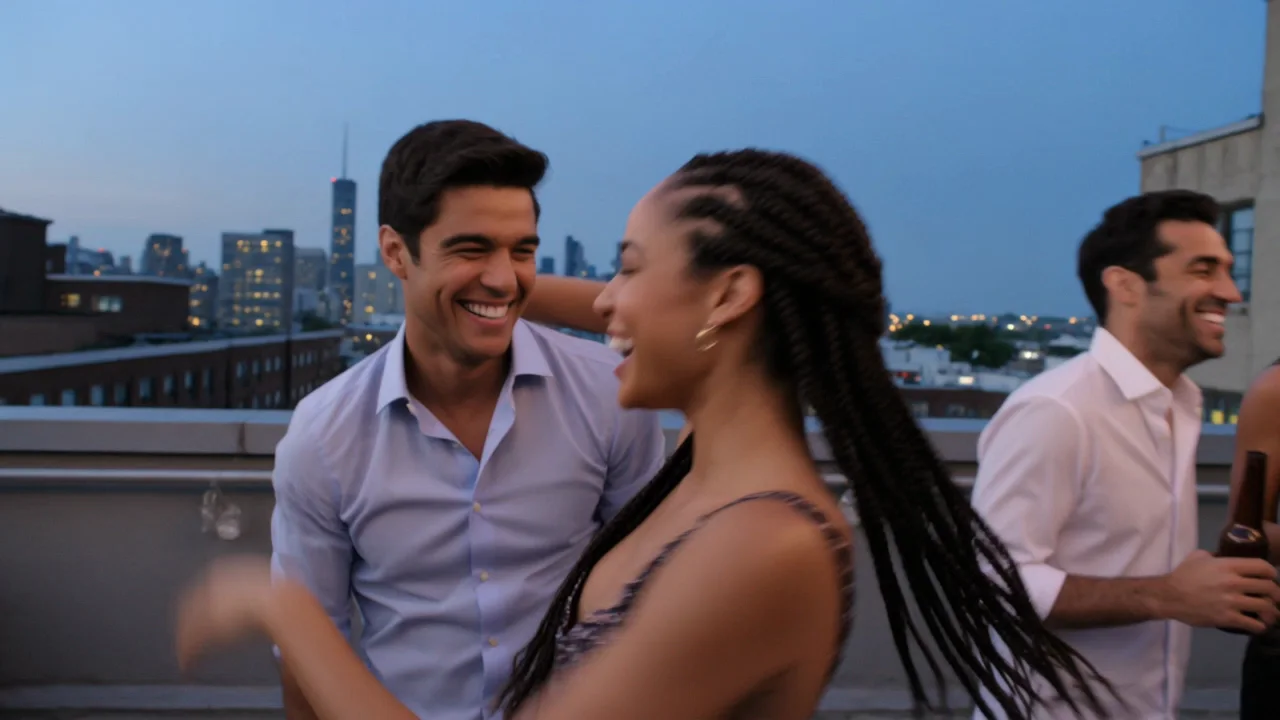
乾杯、告白、別れ――セリフを書いて音声をオンにすれば、セリフ、部屋のトーン、映像が 1 つのファイルに届きます。当社の屋上パーティーの例は、グループ全体が 1 つのセリフを一緒に叫ぶところで終わり、その下で瓶がぶつかる音と音楽にタイミングを合わせています。
4K に踏み切る前に見た目を下書きする
テキストから動画は元画像を必要としないため、4K レンダリングに費用をかける前に、照明のアイデア、カメラの動き、セリフを試す最速の方法です。
連続性のために画像から動画へ引き継ぐ
テキストから動画は実行のたびに衣装、顔、フレーミングを新たに決めます。複数のクリップでキャラクターが同じ見た目である必要があるときは、まずここで最初のショットを生成し、その最後のフレームを次のクリップの開始フレームとして画像から動画に渡してください。
プロンプトガイドと実践のヒント
起きる順番どおりに書く
プロンプトを被写体と衣装、動作、カメラの動き、見た目、そして音の順に構成してください。宮殿のテラスのガウンの例はこの順序に従っています。彼女が誰でどんな服装か、何をするか(歩く、振り向く、話す)、カメラと光、そして環境音の順です。
グループ全体に着地させる 1 つのセリフを与える
複数人が画面にいるときは、依頼の最後に、一緒に話す 1 つの瞬間――1 つのセリフ――を名指しすることで、複数の声がいつ重なるべきかを推測させるのではなく、モデルにセリフを着地させる明確な展開を与えます。
重要なときは「1 つの連続したショット、カットなし」と言う
shot_type: single はカットに対する絶対的な保証ではありません。テイクが最初から最後まで 1 つのセットアップを保つ必要があるなら、その指示を直接プロンプトに加えてください。最初の試みでカットして光が変わってしまったショットの再テストでは、フレーミングと照明の両方が一定に保たれました。
API クイックスタート
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "kling/3.0/text-to-video",
  "input": {
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise",
    "shot_type": "single",
    "resolution": "720p",
    "aspect_ratio": "16:9",
    "generate_audio": false,
    "duration_seconds": 5
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
認証、完全なスキーマ、ポーリング、エラー処理は API リファレンスを参照してください。