「Qwen Image 2512 LoRA」は、異なる2つのベースを持つ1つのモデルページです。 テキストから画像ではQwen-Image-2512を、編集ではQwen-Image-Edit-2511を使います。そのタスクのベースに合わせて学習された、または互換性が明示的に書かれたアダプターを選んでください。生成用のアダプターがそのまま編集に使えるとは限りません。ファイルを間違えると効果がほとんど出ない、あるいは読み込み自体に失敗することがあります。Qwen-Image-Edit-2512は存在しません。数字はリリースの月で、編集用のLoRAには2509や2511と書かれていて、このページが使っているのは2511です。
| テキストから画像 | 画像編集 | |
|---|---|---|
| ベースモデル | Qwen-Image-2512 | Qwen-Image-Edit-2511 |
| アダプターの学習対象または互換性ターゲット | Qwen-Image-2512 | Qwen-Image-Edit-2511 |
| 1リクエストあたりのLoRA | 最大3 | 最大3 |
強度(scale) | 0〜4、通常は1から開始 | 0〜2、通常は1から開始 |
| 入力 | プロンプト | プロンプトに1〜3枚の元画像を加える |
| 出力サイズ | アスペクト比9種、長辺は最大1536 px | 元画像1枚目の比率で約1 MP、または9種類の比率から選ぶ |
| 価格 | 1枚あたり$0.03 | 1枚あたり$0.03 |
どちらのタスクもQwen Image 2512 LoRAのモデルページにあり、規制なしのラベルが付けられています。LoRAや元画像を追加しても費用は増えません。
どのタスクが自分の作業に合うか
書面だけの指示ならテキストから画像を、人物や衣装、構図を残したい写真なら編集を使ってください。ファッションの作業は2段階にできます。2512用に学習したスタイルまたはアイデンティティのLoRAでルックを生成し、Edit 2511のLoRAでカメラアングルや光を変えて編集します。用途ごとに文書化されたLoRAファイルを使ってください。生成用のアダプターが編集まで制御してくれるとは限りません。
LoRAファイルをQwen-Image-2.1のページ名だけで選ばないでください。公開例には2512の生成アダプターと、Edit 2511/2509の編集アダプターが含まれます。ファイルに書かれたベースと用途を確認してください。Qwen Image 2.1 LoRAガイドがそのファミリーの例を扱っています。
まずPlaygroundで試す
- 編集タスクを開きます(リンクには下記の例のプロンプトが自動入力されます)。そのままPlaygroundタブのForm表示で作業します。生成の場合は代わりにテキストから画像を開いてください。実行には入金済みのアカウントでログインします。
- 編集のみ:ImagesでAdd a fileまたはAsset URLから元画像を追加します。最大3枚で、1枚目が出力形を決めます。
- Style LoRAsで、
.safetensorsへの直接リンクをLoRA fileに貼り付け、Strengthを設定します(最初は1、上限は編集が2、テキストから画像が4)。Add itemで最大3件追加できます。 - Seedを設定して実行し、Remove itemを押して同じプロンプトと同じシードでもう一度実行すると、ファイルが何を書き換えたかを確認できます。
Playgroundが送るJSONはAPIが受け取るJSONと同じなので、ここで動く設定はそのままコードに書き写せます。
リクエスト
編集はモデルページの例に沿って行います(固定のフレーズ<sks>を持つEdit 2511のカメラアングルLoRA)。
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" -H "Content-Type: application/json" \
  -H "Idempotency-Key: $(uuidgen)" \
-d '{"model":"alibaba/qwen-image-2512-lora/edit","input":{"image_urls":["https://cdn.spicyapi.ai/models/examples/inputs/33f7ff15be3301c7.webp"],"loras":[{"path":"https://huggingface.co/fal/Qwen-Image-Edit-2511-Multiple-Angles-LoRA/resolve/main/qwen-image-edit-2511-multiple-angles-lora.safetensors","scale":1}],"prompt":"<sks> front view eye-level shot close-up","seed":42}}'テキストから画像はalibaba/qwen-image-2512-lora/text-to-imageを使い、image_urlsの代わりにaspect_ratio(例:"3:4")を使い、トリガーフレーズをプロンプトの先頭に置いた2512のLoRAを渡します。タスクの一連の流れはTasksのドキュメントにあります。ホスティングとリンクのルールは自作LoRAガイドにまとまっています。
Agentに任せられます。 inputオブジェクトをinput.jsonとして保存し、npx @spicyapi/cli tasks create --model alibaba/qwen-image-2512-lora/edit --input-file input.json --waitを実行します(CLI)。MCPサーバーを追加してアシスタントに実行させることもできます(内部でspicyapi_task_createを呼びます)。Agent Skillをnpx skills add spicyapi-ai/spicy-skillでインストールすることもできます。CLIとMCPは価格を表示し、有料呼び出しの前に確認を求めます。
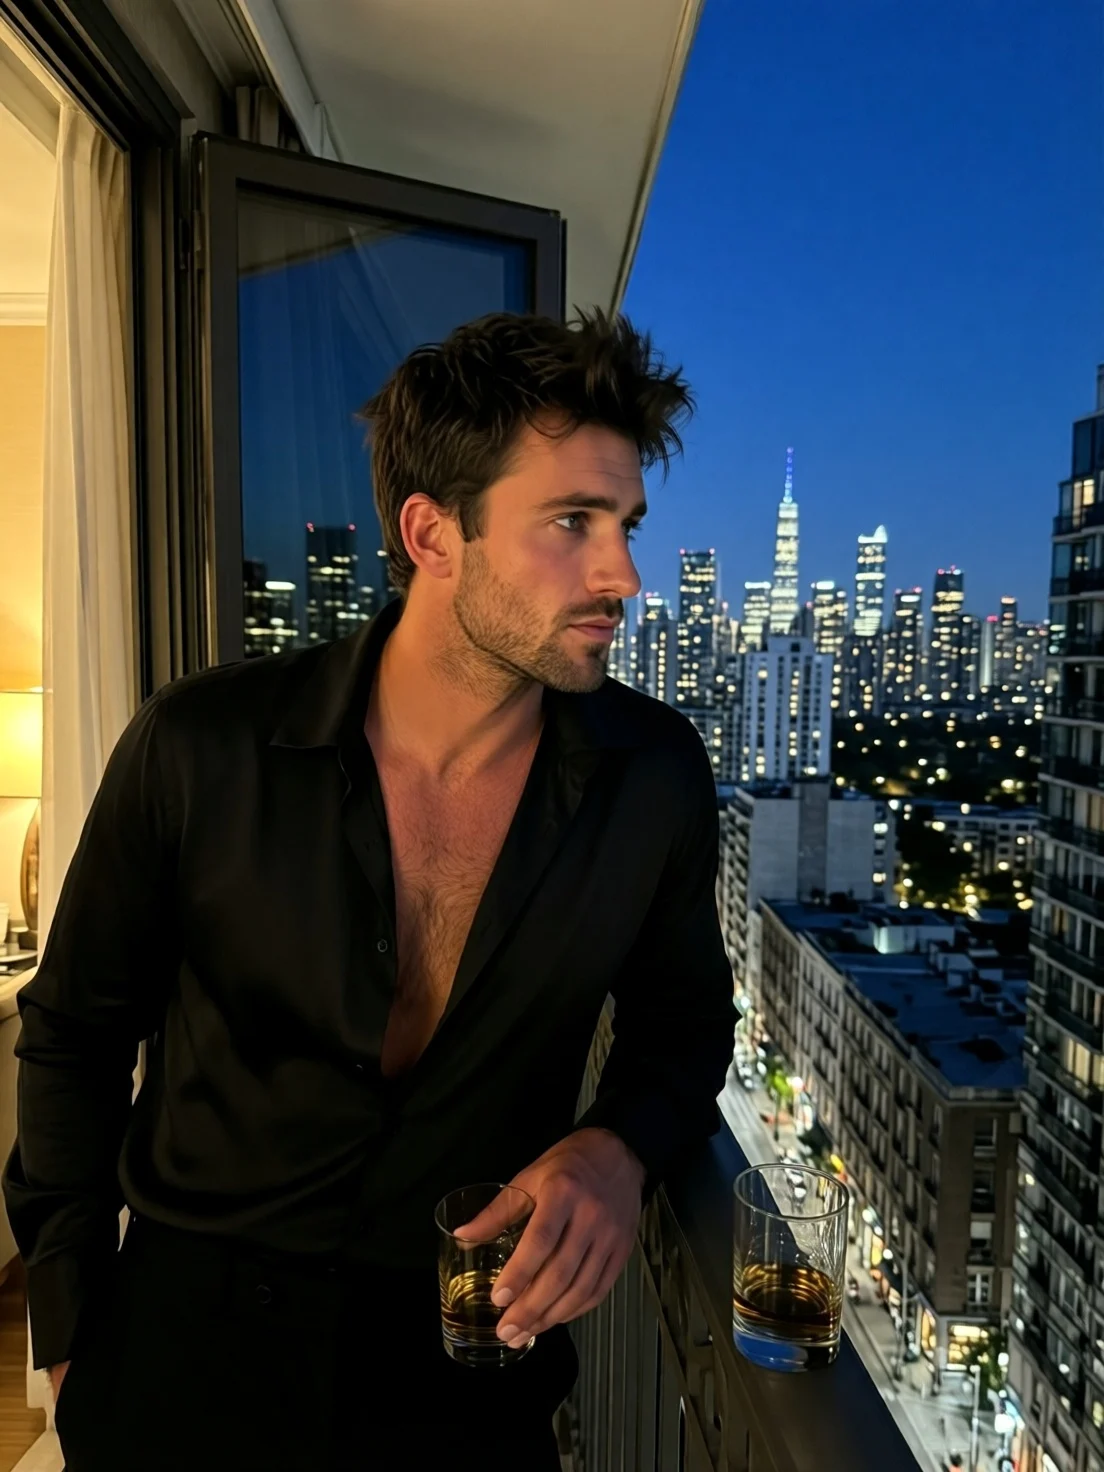
上のリクエストで送信した元画像です。
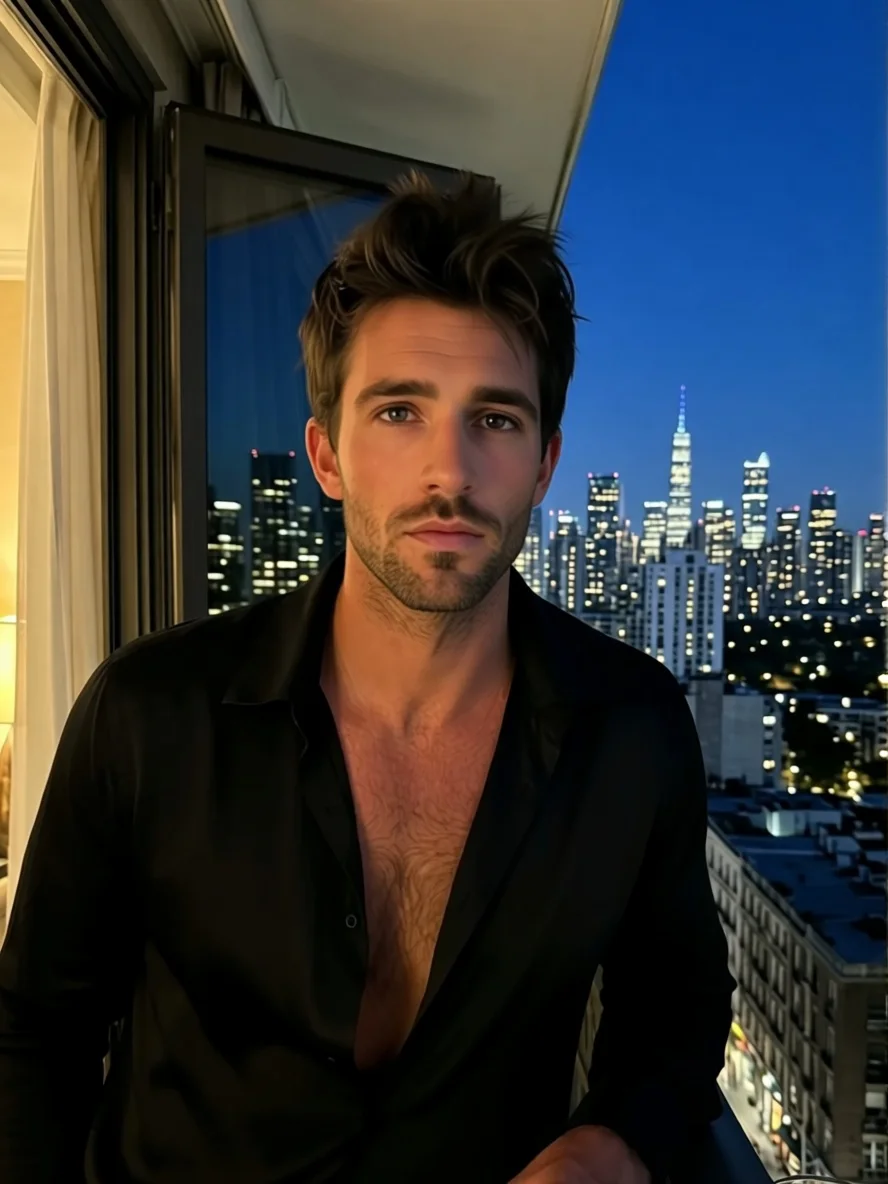
結果:同じ男性、シャツと街並み、正面ビュー。プロンプト<sks> front view eye-level shot close-up、LoRAスケール1、シード42。
リクエストを消費する前にファイルを確認してください
- カードで学習ベースを探します(Hugging Faceのモデルツリーまたは説明文)。生成なら「Qwen-Image-2512」、編集なら「Qwen-Image-Edit-2511」、またはその用途についての互換性注記を探してください。「Qwen」としか書かれていないカードは、何も示していません。
- トリガーフレーズはそのまま写します。 スタイルLoRAは通常、プロンプト冒頭のフレーズを期待します。編集用LoRAは
<sks>のような固定コマンドを期待することが多いです。 .safetensorsファイルへの直接の公開リンクを使います。 ウェブページ、ZIP、ログインが必要なリポジトリ(HTTP 401)はリクエストを失敗させ、通常は課金されません。無料の見積り(CLIspicyapi tasks quote)は、ページリンクと制限付きファイルを支払い前に拒否しますが、アダプターが合うかどうかを判断することはできません。ファイルは完全なチェックポイントではなくLoRAアダプターである必要があります。- ファイルごとにメモを残します。 ベース、用途、リビジョン固定リンク、そして効果のあったスケールです。
LoRAは何かをしたのか
レスポンスはアダプターを適用したかどうかを一切教えてくれません。同じプロンプトとシードで、有無の2回を実行し、1回につき1つだけ条件を変えてください。
| 見える様子 | 考えられる原因 | 次の対応 |
|---|---|---|
| リクエストが失敗し、画像が出ない | リンクにログインが必要か、ページを指しているか、アダプターではない | URLを修正する。通常は課金されない |
scaleでリクエストが拒否される | 編集のエンドポイントは2が上限(テキストから画像は4) | 値を下げる |
| 画像がLoRAなしの場合と同一かほぼ同一 | ベースが違う、トリガーフレーズが抜けている、または強度が不足している | まずカードのベース、次にフレーズ、そして強度を上げる |
| 効果が出て、強度に比例して強まる | ファイルは正しいが、1では弱い | テキストから画像:0.7、1、1.3を試す。編集:0.25刻みで2まで上げる |
| 効果は出るが、顔や場面が崩れる | 強度が高すぎる、または元画像が競合している | 強度を下げてください。元画像は1枚に絞ります。アイデンティティはスタイルLoRAではなく元画像から取ります |
編集ではQwen-Image-Edit-2511が、照明補正などコミュニティで使われているLoRAの効果の一部をベースモデルに組み込んでいます(Qwenのリリースノート)。そのためLoRAなしの編集でも、照明やアングルのファイルが加える効果の一部が既に出ていることがあります。ファイルは学習された効果そのもので評価してください。
編集で使う元画像
元画像ごとに役割を決め、指示の中で名前を明記します。Picture 1は人物、Picture 2は衣装、Picture 3は部屋です。アスペクト比を選んでいなければ1枚目の元画像が出力形を決めるため、求める構図の写真を1枚目に置いてください。きれいな元画像1枚から始め、最初の編集ができたら残りのものを追加します。
複数画像を使う編集設定のイラスト。Qwenの出力ではありません。
編集の範囲を絞りたい場合は、何を残すかを明示します。彼女の顔を残す、ドレスを残す、窓からの光を残す、という書き方です。
アダルトコンテンツでの挙動
2026年9月のテストによると、LoRAなしで動かした生成と編集は、最も踏み込んだ親密なシーンが暗示的な形でのみ返り、それ以外はすべて納品されました。適切なアダルトLoRAを読み込むと、そのシーンはテキストから画像でも、服を着た人を使った編集でも納品されました。強度の高い編集では、スタイルやアイデンティティのアダプターが同じ効果を与えると決めつけずに、Edit 2511と互換性のあるアダルトアダプターを選んでください。アイデンティティ、照明、スタイル、アダルトコンテンツはそれぞれ別のファイルです。全結果はQwen Image 2512 LoRAのレビューにあり、Qwenの編集モデルはQwen画像編集テストで比較されています。

モデルページからの公開サンプルです。
FAQ
Qwen Image Edit 2512 LoRAはありますか?
そのようなモデルはありません。2512はテキストから画像のベースが2025年12月にリリースされたものです。編集側の対応はEdit 2511で、ファイル名の「Edit 2512」はカードと突き合わせるべき誤ったラベルです。
編集タスクでQwen-Image-2512のLoRAを使えますか?
作者が、その特定の2512ファイルがEdit 2511でも動く、と書いている場合以外はEdit-2511アダプターを使ってください。タスクごとにベースが違うことは、クロス互換性の保証ではありません。2512アダプターはテキストから画像側に残し、その見た目だけを元画像経由で編集に持ち込みます。
編集のリクエストでスケール3を拒否されるのはなぜですか?
編集は0〜2、テキストから画像は0〜4を受け付けます。まず1から始めてください。
LoRAのダウンロード失敗は課金されますか?
通常は課金されません。完成した画像は$0.03として課金されますが、アダプター効果がほとんどなくても同じです。アダプターの読み込み失敗はタスクの失敗であり、URLのチェックが成功しただけではその2つを区別できません。
どちらのタスクを開くか
元画像がない場合はQwen Image 2512 テキストから画像を開いて、2512との互換性が書かれたファイルを読み込みます。ポートレートや構図を残さなければならない場合は、Edit 2511のファイルでQwen Image 2512 LoRA編集を開いてください。どちらを開く場合も、バッチを組む前に、同じシードのLoRAなしの対照実験として、互換性のあるファイル1件で最初の1回を実行してください。