はじめに
Qwen Image 2512 LoRA テキストから画像 は、Alibaba が 2025 年 12 月に公開した 200 億パラメーターのオープンモデル Qwen-Image-2512 を使い、文章のプロンプトから画像を 1 枚作ります。自前の LoRA ファイルを最大 3 つ読み込めます。長辺最大 1536 ピクセル・9 種類のアスペクト比から選び、JPEG、PNG、WebP を一律料金で受け取れます。プラットフォームはプロンプト、ウェイト、画像のいずれにもコンテンツフィルターを加えません。
手元の素材からモードを選ぶ
| 手元にあるもの | モード |
|---|---|
| 文章で書いた説明 | Qwen Image 2512 LoRA テキストから画像 |
| 手を加えたい画像 1〜3 枚 | Qwen Image 2512 LoRA 画像編集 |
主な機能とハイライト
LoRA の下に、より大きなベースを
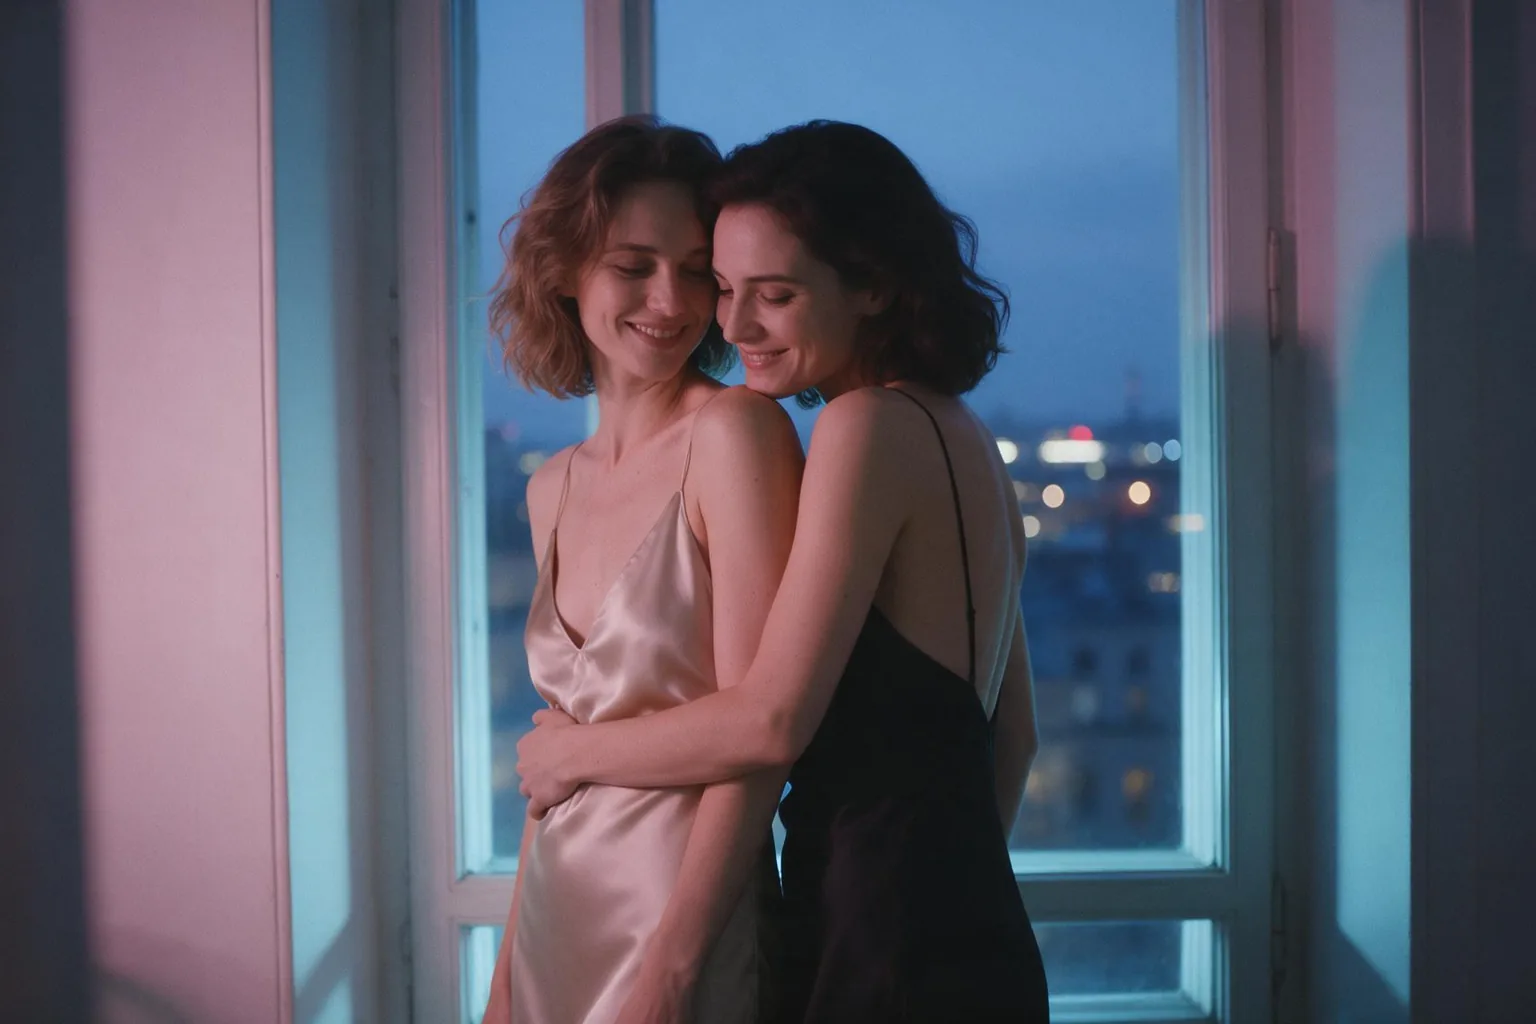
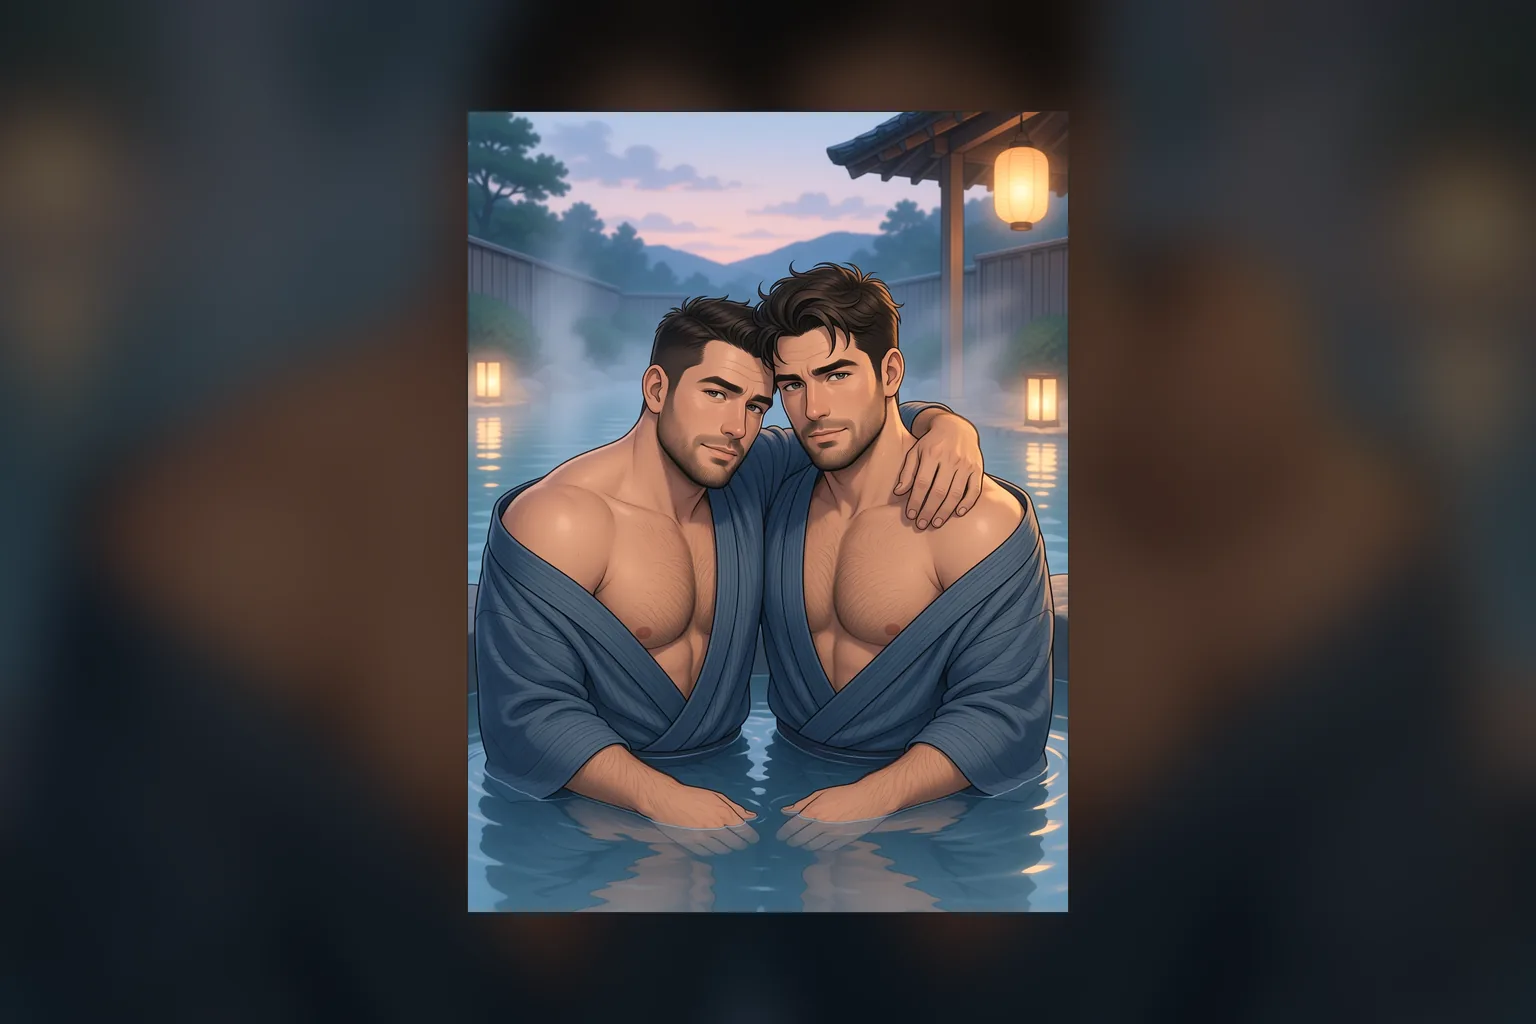
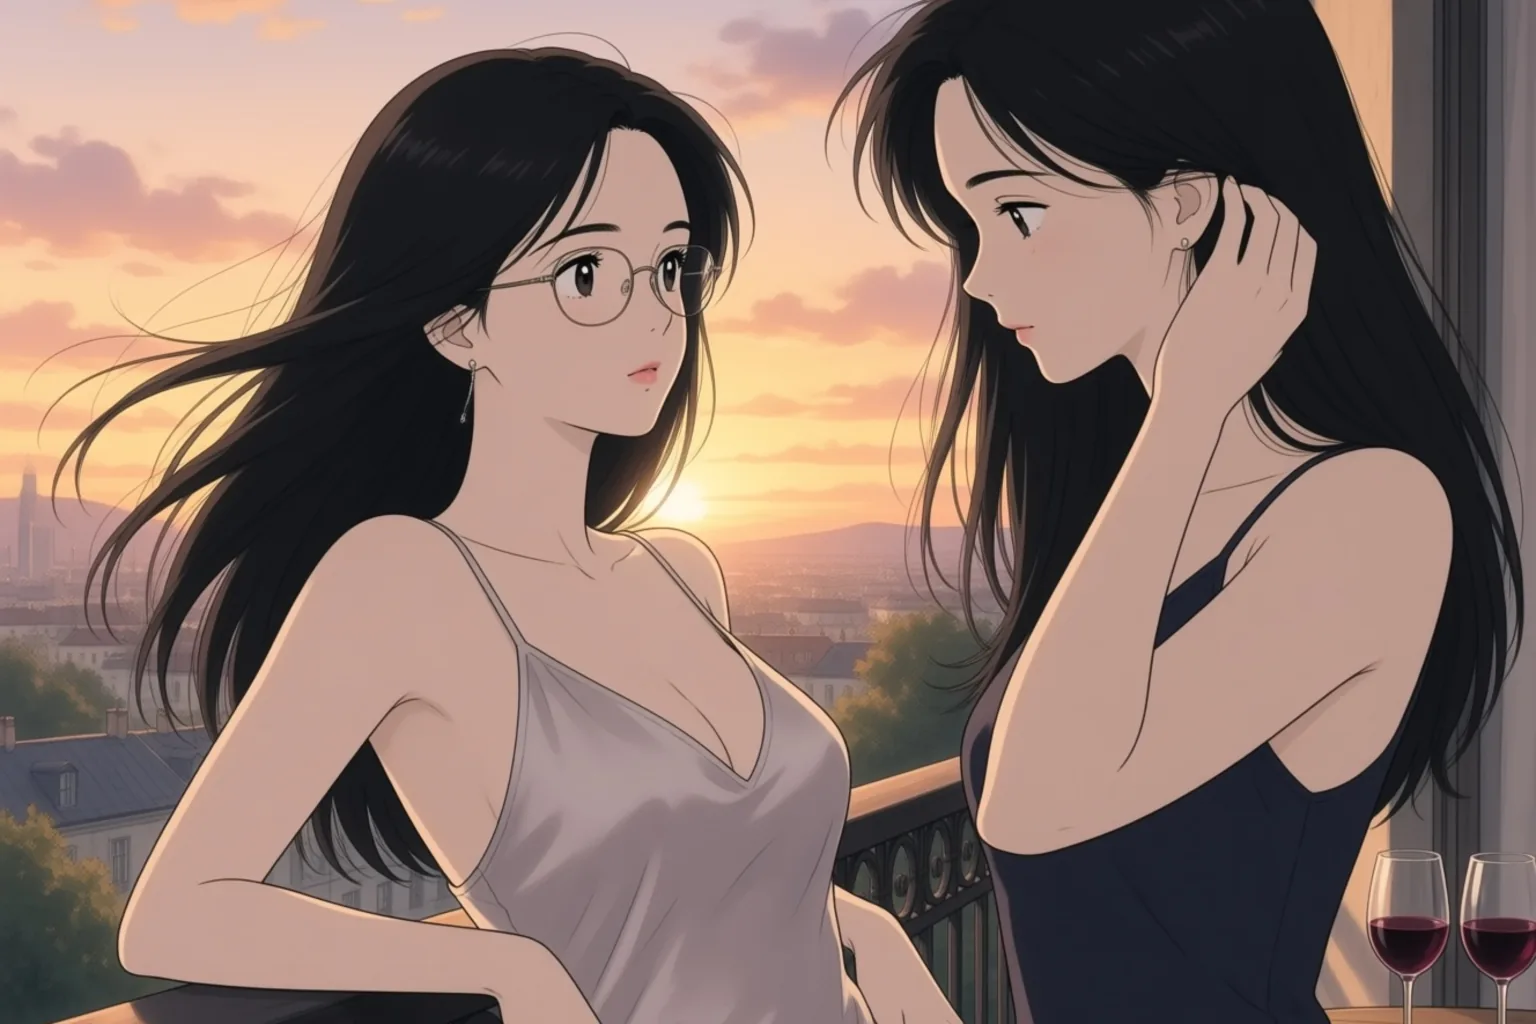
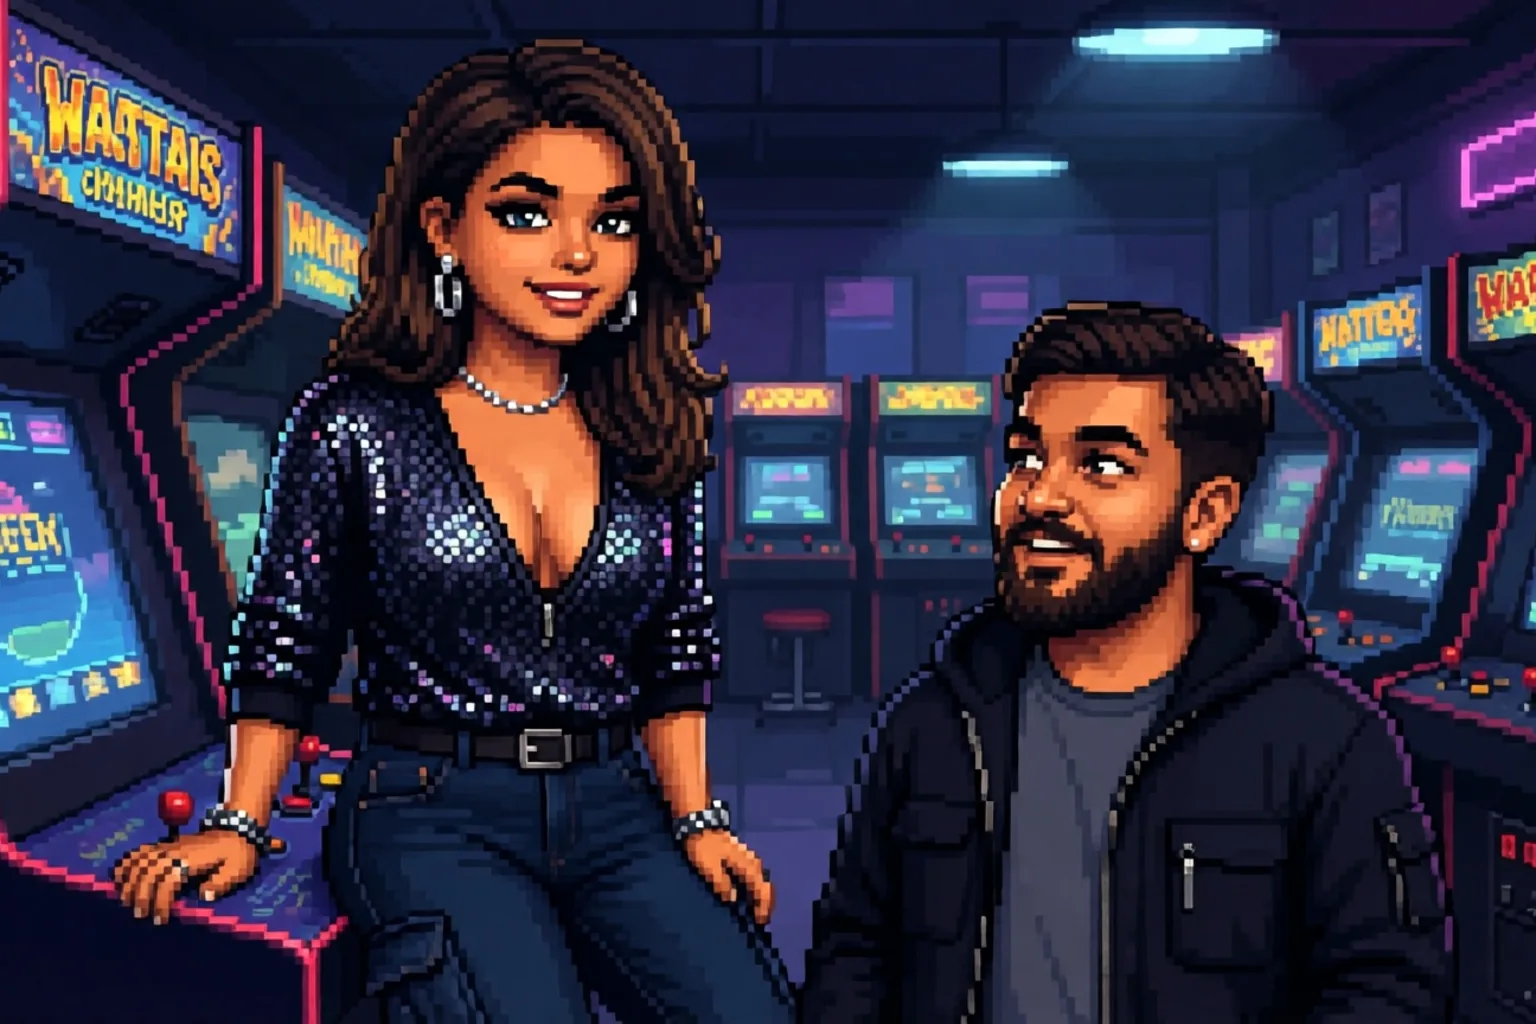
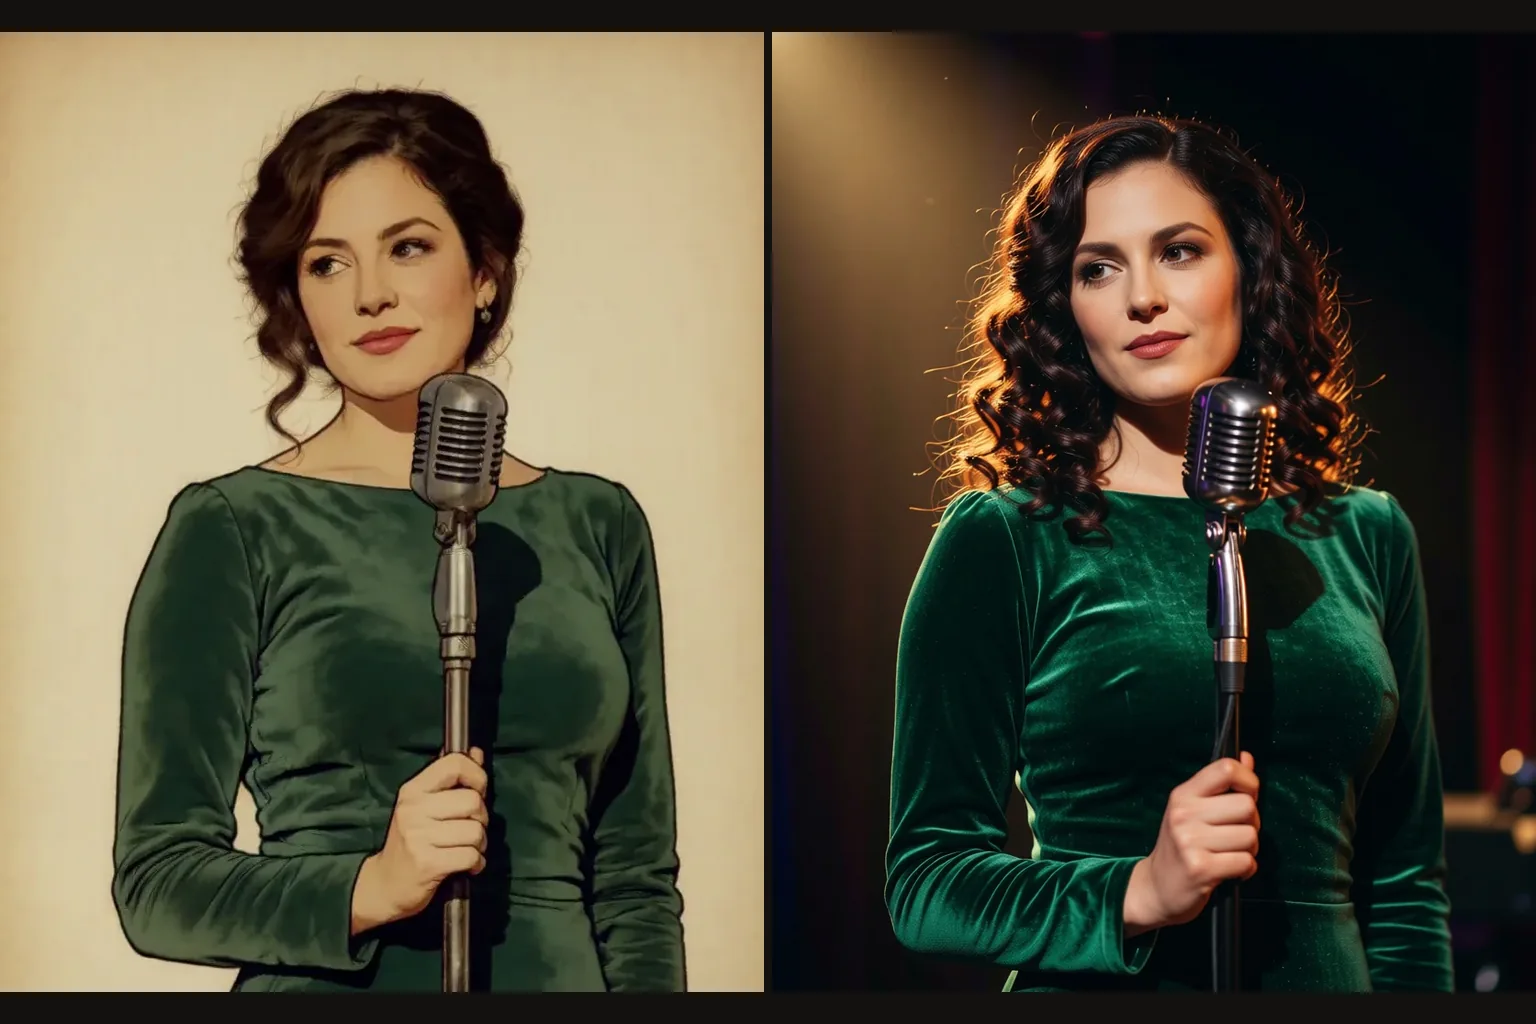
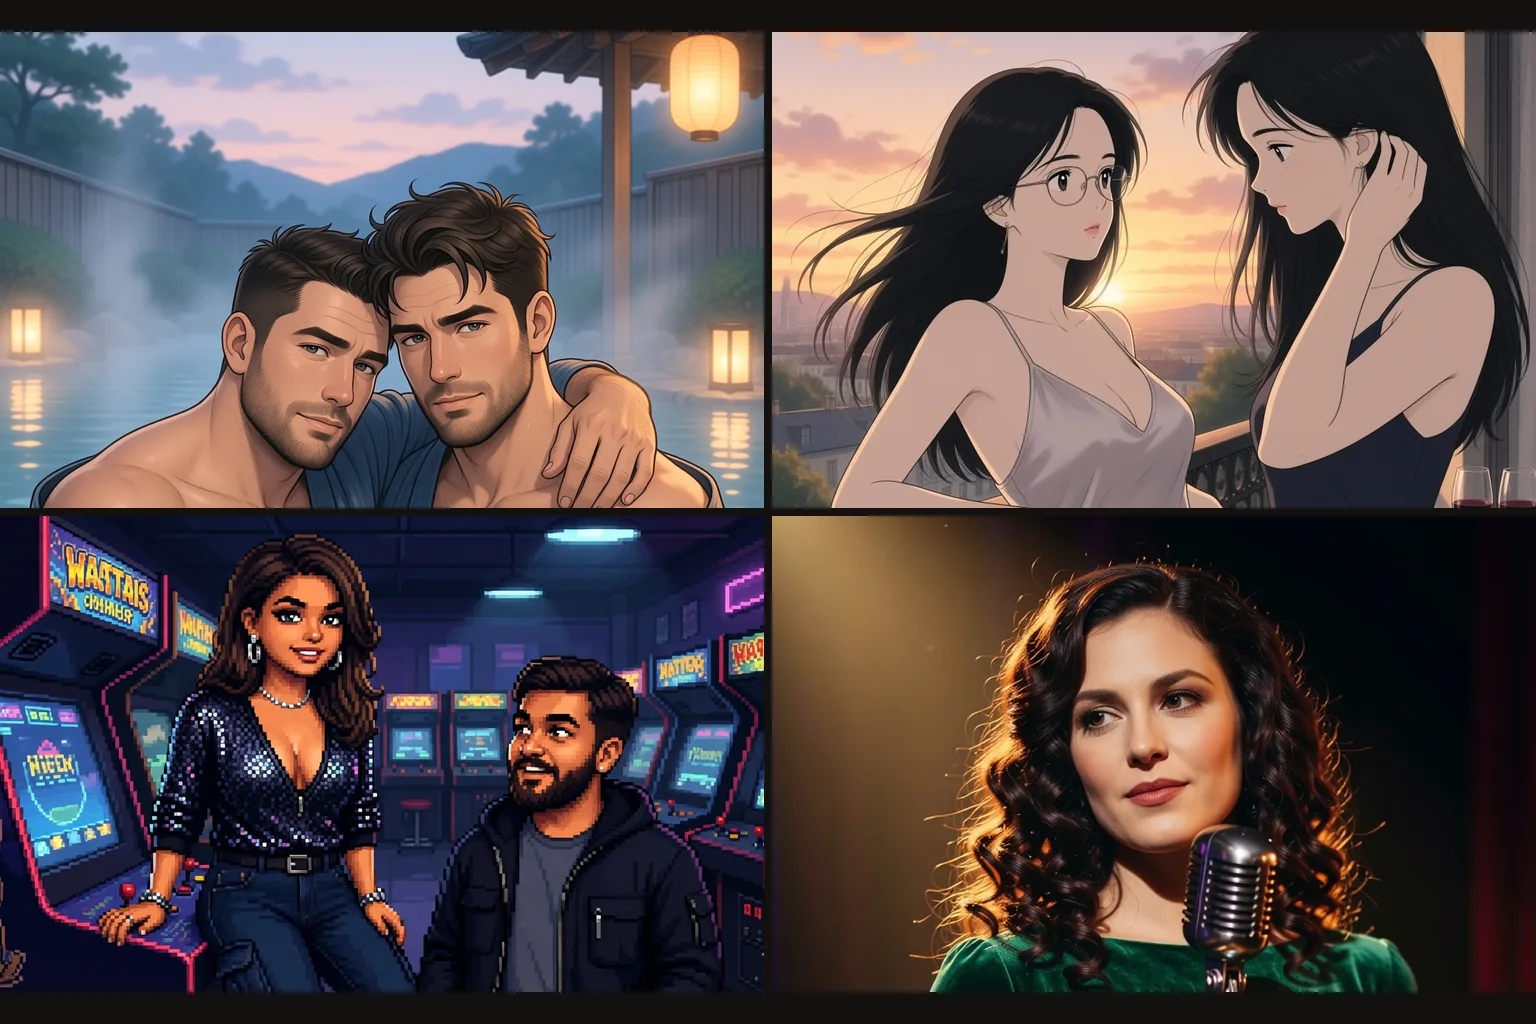
Alibaba は Qwen-Image-2512 を、人物がよりリアルになり、毛並みや風景などの自然の細部がより精細になり、文字の描画も改善したリリースと説明しています。スタイル LoRA を使ってもその細部は残り、イラスト調でも顔、手、小物がきちんと描かれます。
同じ料金で、より大きな画像
1:1 は 1328 x 1328、16:9 は 1536 x 864 で返り、100 万画素を超えます。どの比率も同じ料金です。
カスタムウェイトでも規制なし
フィルターなしの LoRA を読み込むと、当社で最も強い内容のプローブも書かれたとおりに返ってきました。重みが審査されることはなく、出力がフィルターされることもありません。
リクエストパラメーター
| パラメーター | 必須 | 説明 |
|---|---|---|
prompt | はい | LoRA のトリガーフレーズを先頭に置き、続けて被写体、舞台、光を書きます。Qwen-Image は長く詳しいプロンプトによく従います。 1 文字以上 · 5000 文字以内 |
aspect_ratio | いいえ | 21:9 から 9:21 まで 9 種類。1:1 は 1328 x 1328、16:9 は 1536 x 864 で、どれも同じ料金です。 |
loras | いいえ | Qwen-Image-2512 向けに学習した {path, scale} を最大 3 つ。scale は 0 から 4 で、1 が中立です。 デフォルト値: |
output_format | いいえ | 既定は JPEG で、必要なら PNG か WebP も選べます。料金は変わりません。 |
seed | いいえ | LoRA の scale を 1 つずつ変えていく間、画像のセットを比べられる状態に保ちます。 |
料金
$0.03 / 枚
どのアスペクト比でも 1 枚ごとの一律料金で課金されます。LoRA の読み込みに追加料金はかかりません。
ユースケース
イラストのシリーズ
絵本、水彩、ピクセルアートの LoRA と固定の seed で、表紙、コマ、サムネイルの統一されたセットができます。画像が大きいので、1 枚から複数の掲載先向けに切り抜く余裕もあります。
細部まで描けるキャラクターアート
200 億パラメーターのベースに載せたキャラクター LoRA は、スタイルを効かせた画でも顔と手を読み取れる形に保ちます。同じキャラクターが何度も登場するキャラクターシートやビジュアルノベルでは、これが効いてきます。
プラットフォーム向けの規制なしの静止画
ユーザーが求める LoRA を読み込み、画像をそのまま言葉で書きます。コンテンツフラグも、結果の二次審査もありません。
プロンプトガイドと実践のヒント
LoRA が学習したトリガーを使う
2512 の LoRA の多くは、「storybook anime illustration」や「Pixel Art」のようなスタイルのフレーズに反応します。モデルカードから正確にコピーして、プロンプトの冒頭に置いてください。
長く具体的なプロンプトを書く
Qwen-Image は詳しい説明をよく読み取ります。被写体、服装、場所、時間帯、光、色調を完全な文で書いてください。キーワードの短いリストでは、ベースモデルの描写力を無駄にします。
読み込む前にベースを確かめる
無関係なベース向けの LoRA はエラーなく読み込まれますが、ほとんど効きません。最初の Qwen-Image 向けに学習した LoRA は、ここでも絵を変えることが多いものの、結果は予測しにくくなります。モデルカードにはベースが書かれているので、リクエストを使う前に Qwen-Image-2512 とあるか確かめてください。
1 つの seed で scale を比べる
seed を固定し、LoRA を 0.7、1、1.3 で試します。大きなベースに載せたスタイル LoRA は、ルックが前に出るまでに少し強めの scale が必要なことがあります。
API クイックスタート
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "alibaba/qwen-image-2512-lora/text-to-image",
  "input": {
    "aspect_ratio": "1:1",
    "output_format": "jpeg",
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
認証、完全なスキーマ、ポーリング、エラー処理は API リファレンスを参照してください。