はじめに
Z-Image Base LoRA テキストから画像 は、文章のプロンプトから、自前の LoRA ファイルを最大 3 つ読み込んだ画像を 1 枚描きます。Alibaba の Tongyi-MAI チームによる 60 億パラメーターのベースモデル Z-Image を使います。開発元がファインチューニングと LoRA 学習の出発点として挙げる、蒸留なしのビルドです。アスペクト比は 9 種類から選べます。プラットフォームはプロンプト、ウェイト、画像のいずれにもコンテンツフィルターを加えません。
手元の素材からモードを選ぶ
| 手元にあるもの | モード |
|---|---|
| 文章で書いた説明 | Z-Image Base LoRA テキストから画像 |
| スタイルを変えたい画像 | Z-Image Base LoRA 画像から画像 |
主な機能とハイライト
LoRA の学習先になるビルド
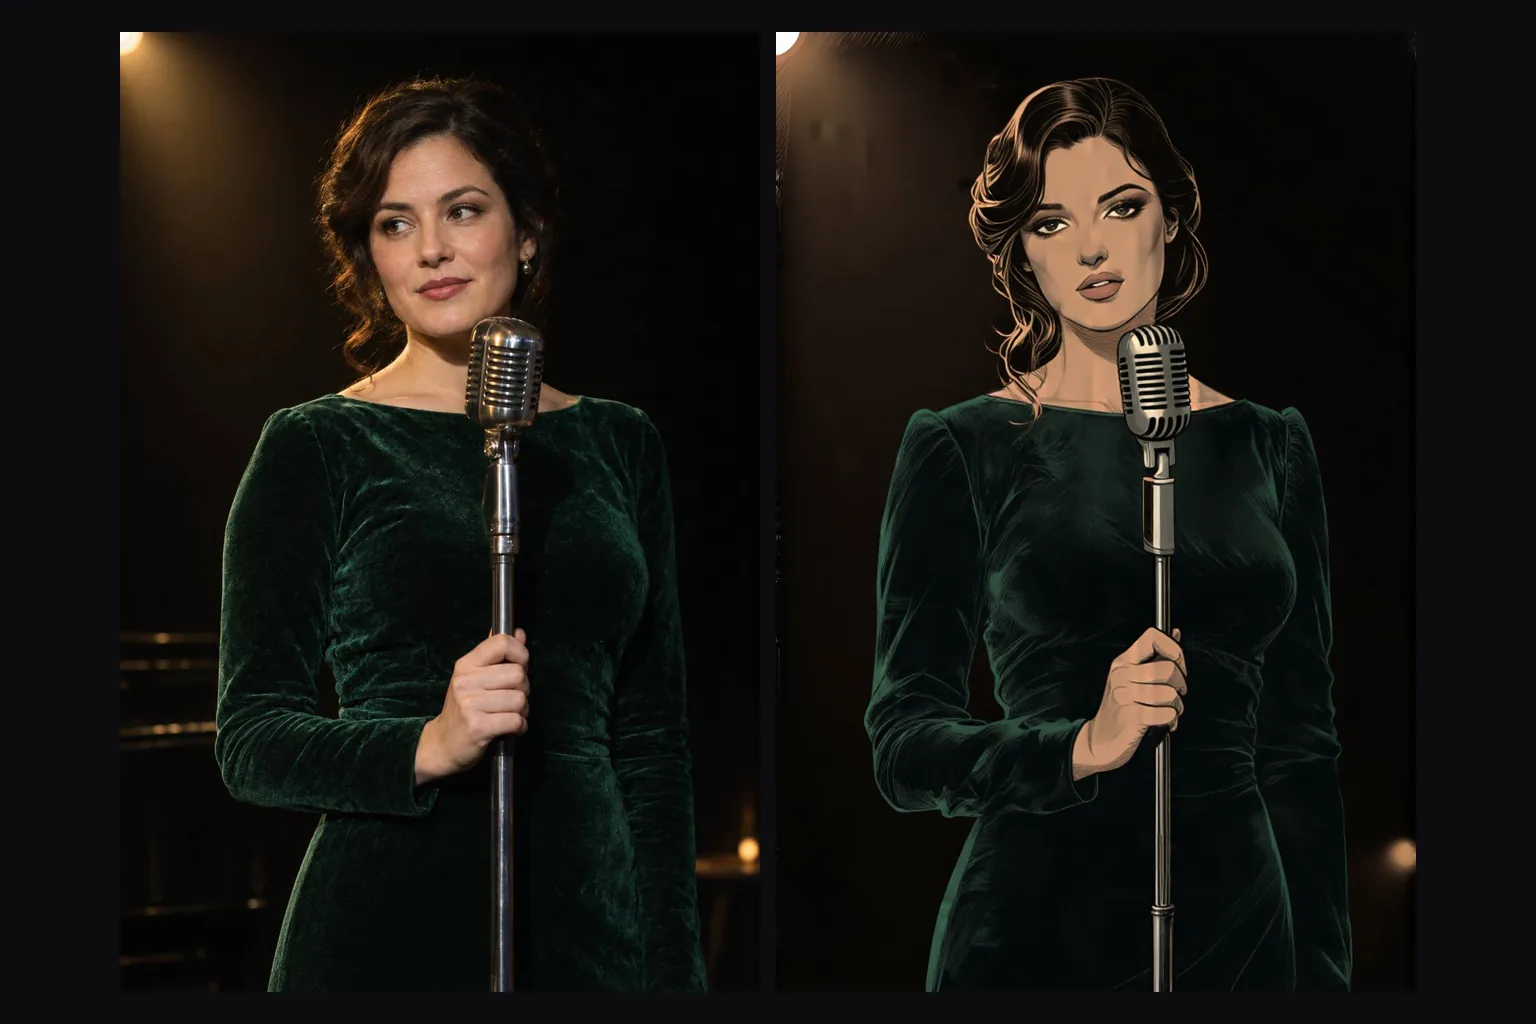
Z-Image には、高速な蒸留版の Turbo と、このフル版の Base があります。開発元はファインチューニングに Base を推奨しており、これで学習した LoRA をここで読み込むと、当社のテストでは全体のルックががらりと変わりました。
同時に 3 つ
1 リクエストに LoRA を最大 3 つまで、それぞれ 0 から 4 の個別の scale で使えます。事前に当社へアップロードするものはなく、ファイルが審査されることもありません。
標準で写真のように
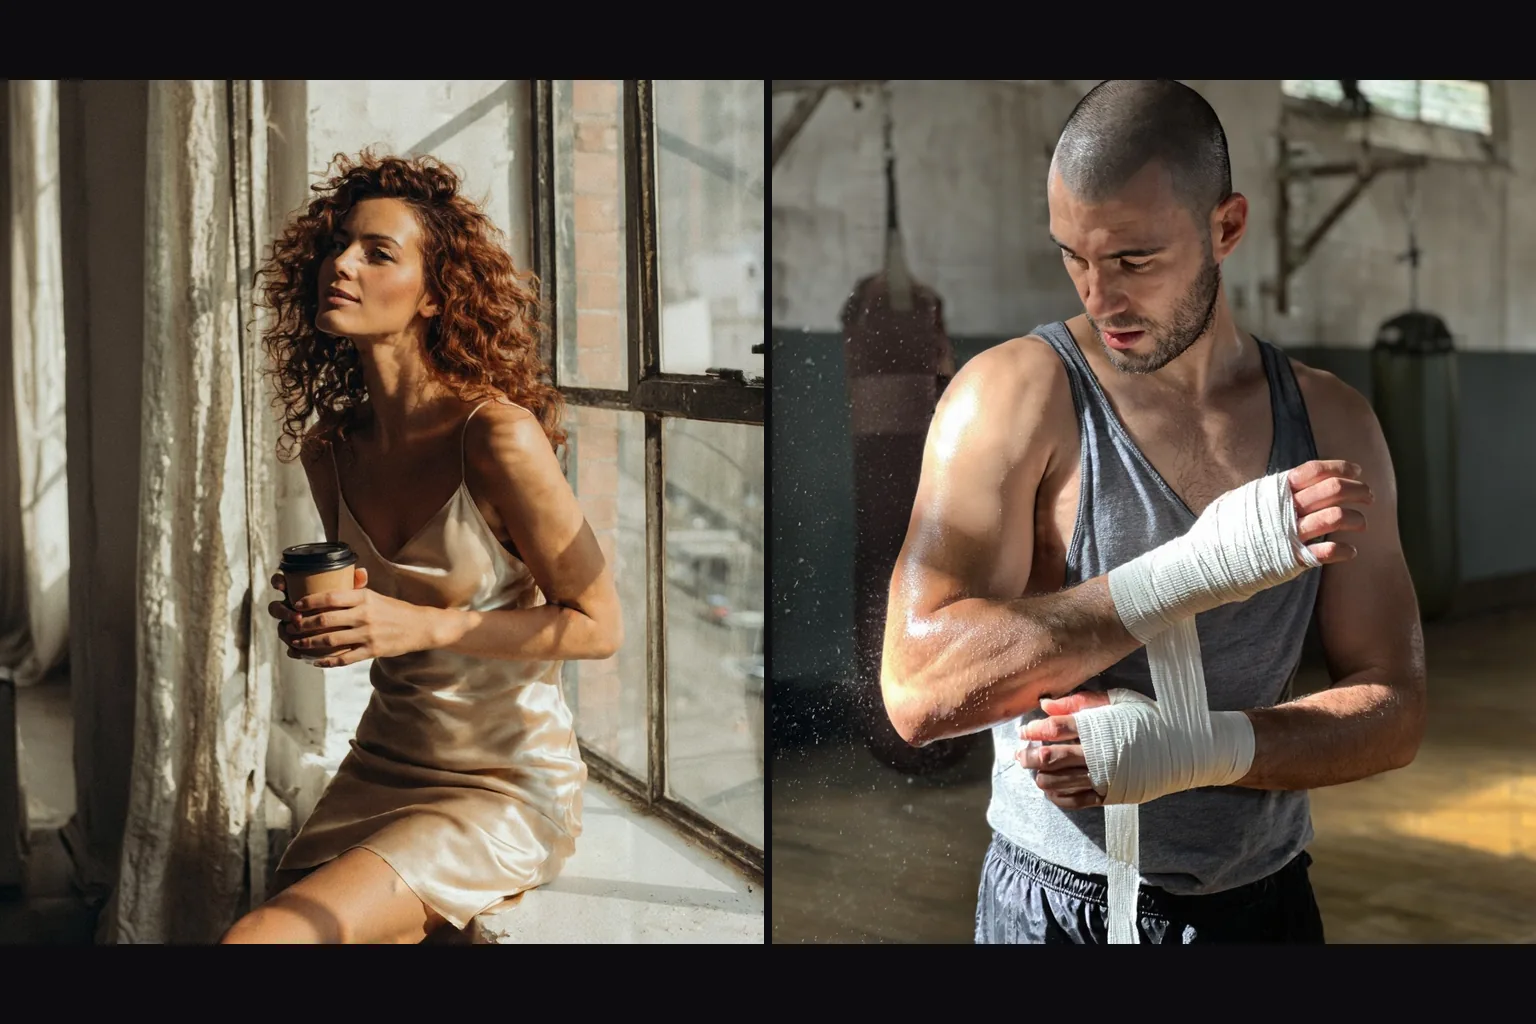
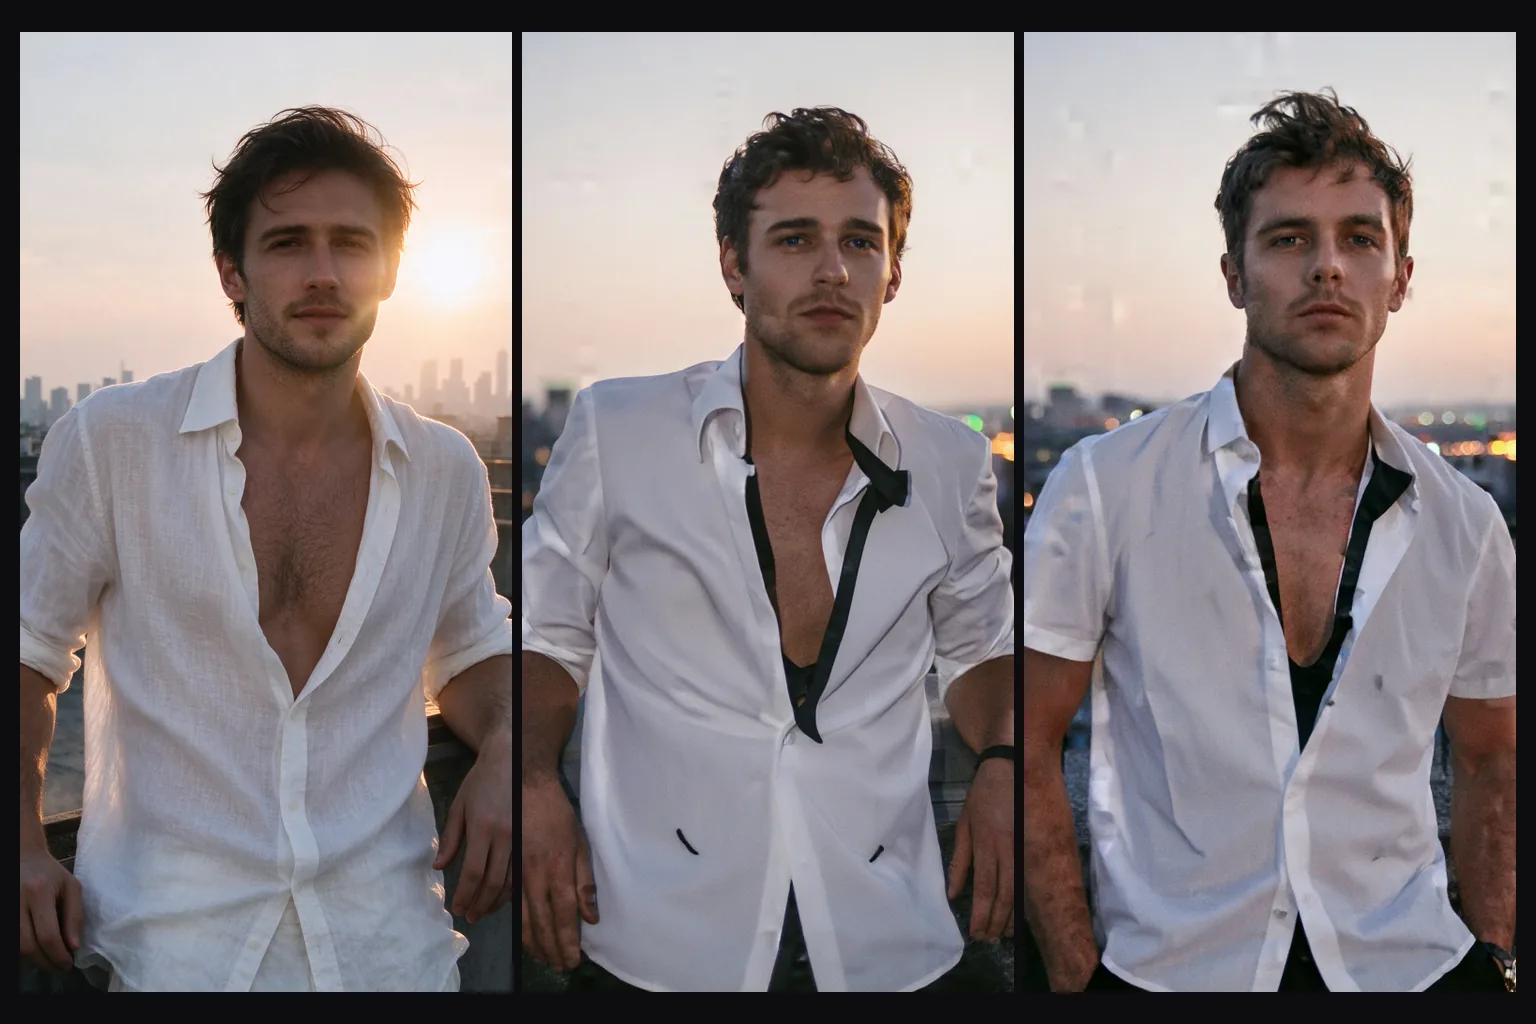
LoRA なしでも、自然な肌、光、粒子感のある写真のような画像を描き、長い説明的なプロンプトにもよく従います。
コンテンツフィルターなし
プロンプト、ウェイト、結果のいずれにもフィルタはありません。ベースモデルは、かなり強め以外の軽め〜最大のすべてのレベルを迷わず描画しました。かなり強めは、ブロックされたのではなく、輪郭がぼやけた状態で出てきました。フィルタなしの LoRA は、そのためにあるものです。
リクエストパラメーター
| パラメーター | 必須 | 説明 |
|---|---|---|
prompt | はい | 文章がいちばんうまくいきます。被写体、服装、場所、光、レンズの順です。 1 文字以上 · 5000 文字以内 |
aspect_ratio | いいえ | 約 100 万画素の 9 種類の形で、21:9(1536 x 640)から 9:21 まで。既定は 1:1 です。 |
loras | いいえ | Z-Image Base で学習した {path, scale} を最大 3 つ。scale は 0 から 4 で、1 が中立です。 デフォルト値: |
output_format | いいえ | 既定は JPEG で、PNG か WebP も選べます。形式によって料金は変わりません。 |
seed | いいえ | LoRA や文章を 1 つずつ変えていく間、画像のセットを比べられる状態に保ちます。毎回まったく同じピクセルになることを保証するものではありません。 |
料金
$0.014 / 枚
1 枚ごとに課金されます。アスペクト比、出力形式、LoRA の読み込みによって料金は変わりません。
ユースケース
セット全体に共通のハウススタイル
スタイル LoRA を読み込み、トリガーフレーズを先頭に置いたまま、プロンプトのリストを流します。セット内のどの画像も同じルックになります。
自分で学習した LoRA
Z-Image Base で学習するなら、その結果を GPU を自前で動かさずに、フル品質のままここで試せます。
写真のような静止画
ポートレート、エディトリアル、シネマティックなカットを、文章から 21:9 から 9:21 までの 9 種類の形で。
プロンプトガイドと実践のヒント
文章で書く
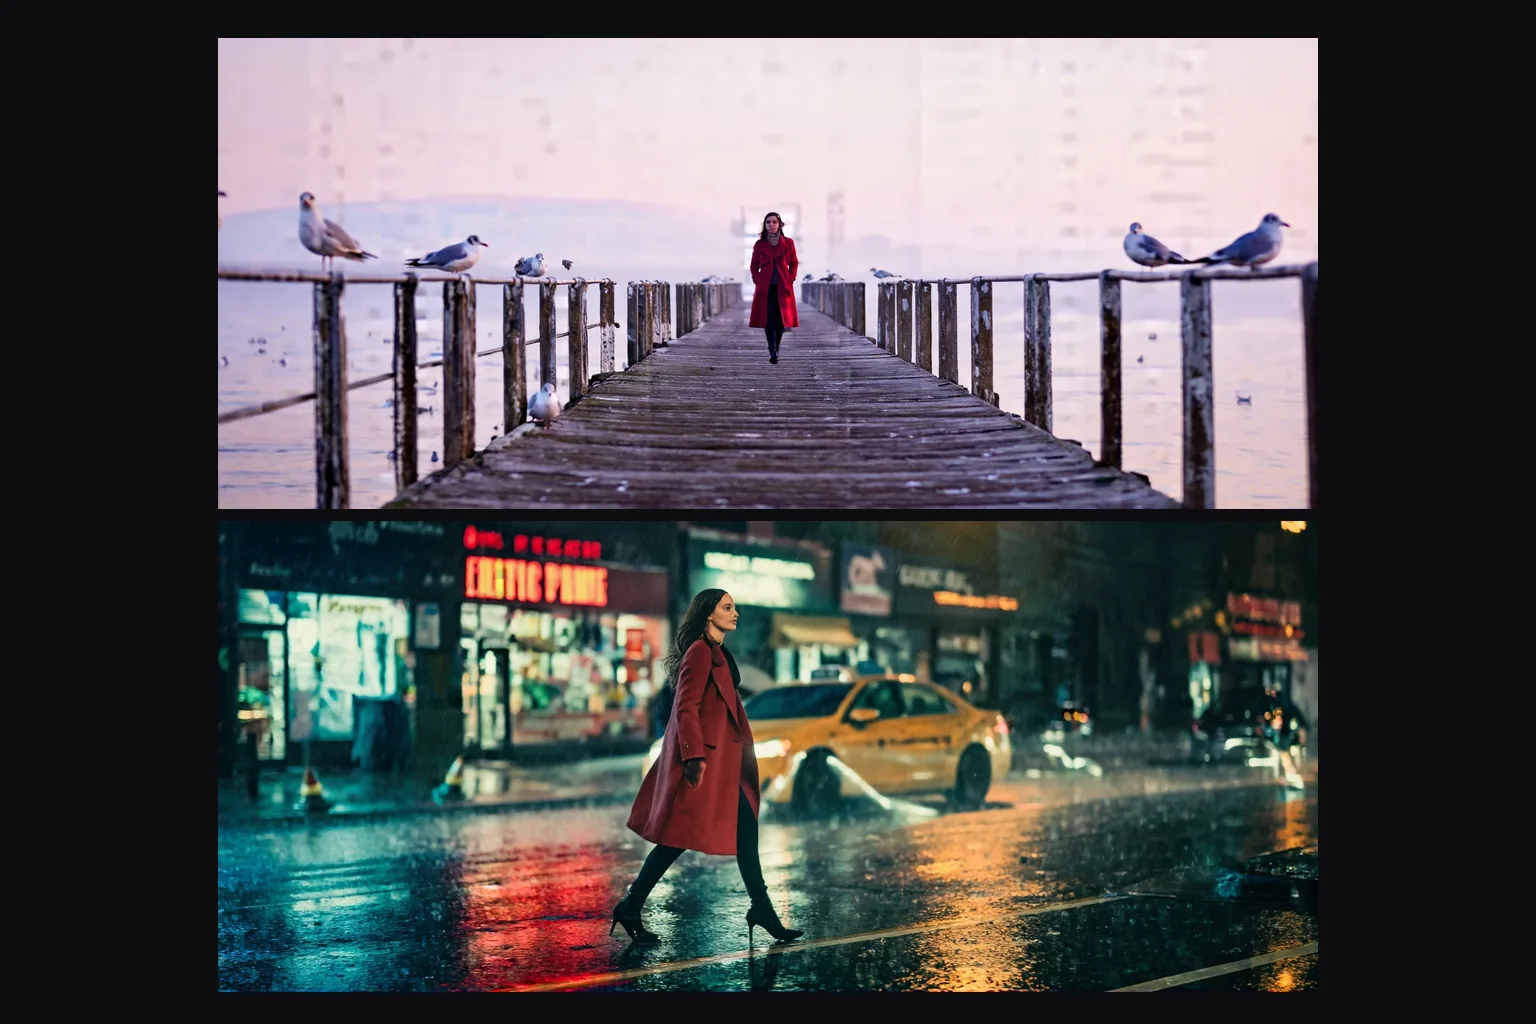
被写体、服装、場所、光、レンズを文章で説明します。当社のテストでは、両手で持ったコーヒーカップや、桟橋のカモメのような細部にもモデルはよく従いました。
トリガーフレーズに注意
プロンプトへの追従が強いため、LoRA のトリガーフレーズだけでもスタイルが変わることがあります。フレーズの有無だけでなく、LoRA ファイルの有無で比べてください。
Turbo ではなく Base の LoRA を
当社のテストでは、Z-Image Turbo で学習した LoRA が、このビルドでエラーなく画像を崩しました。Z-Image Base で学習した LoRA を探してください。
時間に余裕を
Base は Turbo よりずっと多くのサンプリングステップを回します。当社のテストでは、テキストから画像 1 リクエストのモデル処理時間は 10 秒から 57 秒で、たいてい半分ほどかかりました。
API クイックスタート
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "alibaba/z-image-base-lora/text-to-image",
  "input": {
    "aspect_ratio": "1:1",
    "output_format": "jpeg",
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
認証、完全なスキーマ、ポーリング、エラー処理は API リファレンスを参照してください。