更新(2026年10月9日): 10月9日の再テストでは、Vidu Q4 Preview の image-to-video は、親密なシーン(L4)のリクエストを3回すべて拒否しました。10月8日には、同じリクエストが示唆にとどまる形で返ってきていました。部分的なレベルと合意のうえでの拘束は引き続き描画され、最も強いレベルは引き続き腰の高さまでのフレーミングでした。この記事の残りの部分は、10月8日に測定した結果をそのまま報告しています。
画面に登場させたいキャラクターがいて、成人向けのシーンを考えている。そこで、2026年10月7日に公開された Vidu Q4 Preview と Seedance 2.5 のどちらを使うか迷っている。決め手になるのは、肩紐がずれる程度を超えた要求にそれぞれがどこまで応えるか、そして画像のほかに何を入力できるかです。
結論: 最も強いレベル(L3)を求めるなら、応えてくれたのは Seedance です。静止画から始めた場合、Vidu Q4 Preview はそのレベルの 3 回すべてで表現を控えめにしました(フレームが腰より上で止まる、または下着が残る)。一方、Seedance 2.5 Spicy は 3 回中 3 回、通常版の Seedance 2.5 は採用した 2 回の両方で描画しました。部分的なレベルと拘束では、Vidu の image-to-video がいずれも 3 回中 3 回で、Seedance 2.5 Spicy と並びました。成人 2 人の親密なシーンでは 3 回中 3 回とも表現を控えめにし(行為は示唆にとどまり、接触はフレーム外)、Seedance 2.5 Spicy は 3 回中 3 回描画しました。弱点は Vidu の reference-to-video で、最も強いレベルと拘束はすべての実行で拒否されました。入力面では、Seedance 2.5 が参照画像 30 枚・音声クリップ 10 本まで受け付けるのに対し、Vidu は 15 枚・3 本です。Vidu には 2k と 4k の解像度があり、引用した台詞どおりに話します。
Vidu 自体の結果は Vidu Q4 Preview は検閲なし? にまとめています。ほかに 2 本の直接比較として Vidu Q4 Preview と Vidu Q3、Vidu Q4 Preview と Kling 3.0 があります。
Vidu Q4 Preview の image-to-video を試す → · Seedance 2.5 を試す → · Seedance 2.5 Spicy を試す →
それぞれどこまで描くか
レベル:L1 示唆的(肩紐のずれ、レース)· L2 部分的· L3 強め· L4 激しい(成人 2 人の親密なシーン)· L5 極端(合意のうえでの拘束、映画的な流血)。各セルは、採用した実行のうち「描画された/控えめに仕上がった/拒否された」の回数です。日付は表の下の注記にあります。
| モデル・タスク | L1 | L2 | L3 | L4 | L5 拘束 |
|---|---|---|---|---|---|
| Vidu Q4 Preview · image-to-video | 1/1 | 3/3 | 0/3:控えめ 3 | 0/3:控えめ 3 | 3/3 |
| Seedance 2.5 Spicy · image-to-video | 3/3 | 2/3、控えめ 1 | 3/3 | 3/3 | 3/3 |
| Seedance 2.5 · image-to-video | 3/3 | 3/3 | 2/2 | 3/3 | 未実施 |
| Vidu Q4 Preview · reference-to-video | 1/1 | 0/3:控えめ 3 | 拒否 3/3 | 拒否 2、控えめ 1 | 拒否 3/3 |
| Seedance 2.5 · reference-to-video | 3/3 | 3/3 | 2/2 | 3/3 | 未実施 |
表の読み方と、データが薄い部分:
- 日付と経路。 Vidu Q4 Preview:2026 年 10 月 8 日、540p、5 秒、服を着た成人の元写真から。Seedance 2.5:2026 年 9 月 24 日。Seedance 2.5 Spicy:2026 年 9 月 25 日(reference-to-video のタスクはありません)、480p、4 秒。解像度や長さでコンテンツチェックの通り方は変わりませんが、3 つのセットは同じ日に同じプロンプトで実行したわけではないため、厳密な実験室比較ではなく、有力な目安として読んでください。
- 「描画された」は「すべてがフレームに入った」ではありません。 Vidu の L3 の結果では、モデルがフレームを腰より上に保っていました。L4 のクリップは騎乗の動きを横から捉えたショットで、接触そのものはフレームに入りません。これは「描画された」ではなく「控えめ」として数えています。男性の L3 リクエストは、image-to-video では胸や腰で切られ、reference-to-video では拒否されました。
- L5 は同じ条件の比較ではありません。 Vidu の拘束テスト(縛られた手首、みみず腫れ、フロッガー)は、静止画からの 3 回すべてで描画されました。Seedance 2.5 Spicy は、拘束と映画的な流血という 2 種類の L5 を、どちらも 3 回中 3 回描画しました。通常版の Seedance 2.5 では L5 を実行していないので、その行は推測で埋めず空けてあります。
- サンプル数。 レベルごとに 3 回では、「最も強いレベルは一度も出ない」といった傾向は見えますが、割合を約束できるほどではありません。
Spicy が通常版の Seedance に何を加えるかは、Seedance 2.5 と 2.5 Spicy の比較 と Seedance 検閲なし版のテスト を参照してください。
各モデルが受け付ける入力
実際のプロジェクトの多くは、ここで決まります。
| Vidu Q4 Preview | Seedance 2.5 | Seedance 2.5 Spicy | |
|---|---|---|---|
| テキストだけで開始 | 不可 | 可 | 不可 |
| 冒頭フレーム(image-to-video) | 可 | 可。終了フレームも任意で指定可 | 可。終了フレームも任意で指定可 |
| 参照画像 | 1〜15 枚 | 最大 30 枚 | 受け付けない |
| 参照音声クリップ | 最大 3 本、MP3、各 3〜12 秒 | 最大 10 本、各 2〜30 秒、合計 30 秒 | 受け付けない |
| 参照動画クリップ | 不可 | 最大 10 本、各 2〜30 秒、合計 30 秒 | 受け付けない |
| クリップの長さ | 3〜16 秒 | 4〜30 秒 | 4〜30 秒 |
| 解像度 | 540p、720p、1080p、2k、4k | 480p、720p、1080p | 480p、720p、1080p、アップスケールされた 4k |
| 音声 | 既定でオン、オフにも可 | 既定でオン、オフにも可 | 既定でオン、オフにも可 |
| 参照使用時のアスペクト比 | 16:9、9:16、1:1、3:4、4:3 | 21:9、16:9、4:3、1:1、3:4、9:16、adaptive | 該当なし |
参照 15 枚と 30 枚
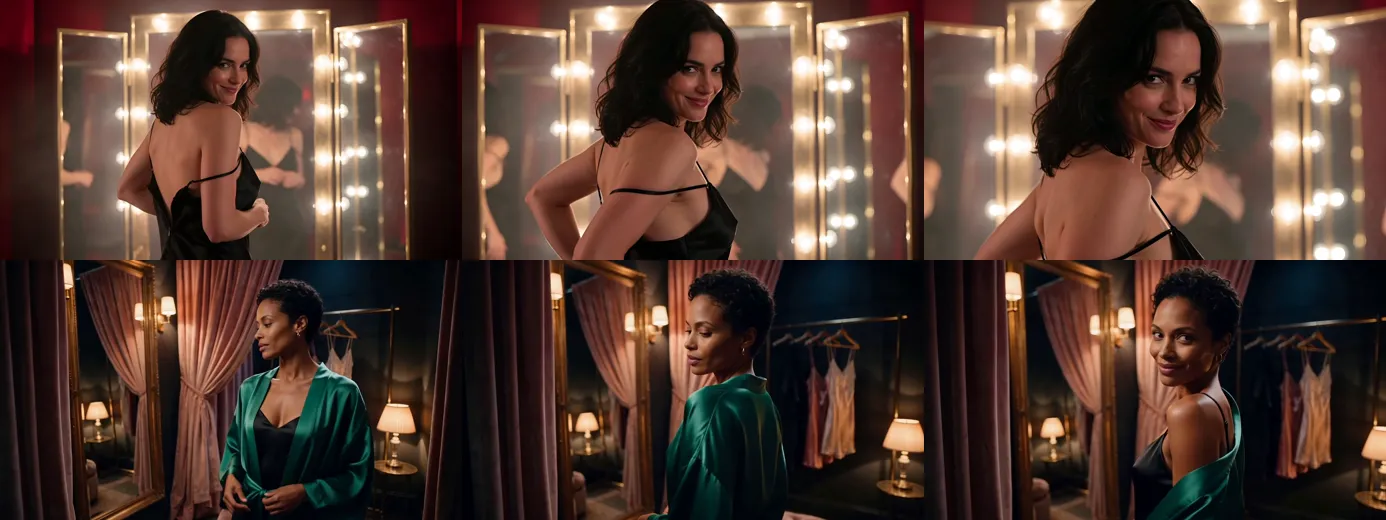
15 枚あれば、複数の人物に衣装とセットを加えた構成まで足ります。Vidu には参照を 3 枚(ポートレート、シルクのローブの商品写真、無人の試着室)送ったところ、彼女の顔、ローブの色、部屋の鏡とカーテンがすべて引き継がれた 1 つのシーンが返ってきました。30 枚が効くのは、登場人物が多いショットや、1 人につき複数の角度を使いたいときです。ただし Seedance 2.5 のモデルページは、似たフレームを 10 枚並べるより、1 人につき 2〜3 の角度のほうがよく働くと案内しています。
Seedance にあって Vidu にないものは 3 つあります。動きとカメラワークのための参照動画、より長いテイク、そして 21:9 です。どちらのモデルでも、配役を決めるのはプロンプトです。参照は位置で呼び(「the woman from the first image」)、それぞれが何のためのものかを書いてください。
音声クリップ
Vidu の音声は声の参照にすぎません。クリップが決めるのは声で、言葉はプロンプトに二重引用符で書く必要があります。「参照音声の声と言葉で」と頼んだだけで台詞を書かなかった実行は、無音で返ってきました。プロンプトで引用した台詞は、下のクリップの短い台詞も含めて、きちんと話されました。
動画:Vidu Q4 Preview の image-to-video、1080p、5 秒。黒いスリップドレスの女性が試着室の鏡の前で肩紐を落とし、台詞を言う。
Seedance の参照音声は、音の拠りどころです。話し方、テンポ、音楽のフレーズに動きとカット位置が合わせられ、最大 10 本まで使えます。自分で用意した声に沿った台詞のテイクが欲しいなら Vidu のほうが直接的で、拍に合わせたカットが欲しいなら Seedance です。
解像度と長さ
2k や 4k が必要なら、通常の解像度として用意しているのは Vidu だけです。出力は 10-bit HEVC なので、ブラウザによってはその場で再生できず、デスクトップのツールで変換することになります。Seedance 2.5 のネイティブ描画は 1080p までで、Seedance 2.5 Spicy の 4k は、その描画をアップスケールしたものです。同じ長さなら 1080p より時間がかかります。1 クリップで 16 秒を超えたいなら、Seedance は 30 秒まで対応します。
プロンプト自体について
Vidu は引用された台詞を発話として読み取り、最大 20,000 文字のプロンプトを受け付けます。Seedance には独自の入力チェックがあり、入力側が一部の表現を拒否することが知られています。最も安定して拒否されるのはキスで、実在の特定できる人物の写真も受け付けないことがあります。Vidu の公開例にある 2 人の女性のキスは依頼どおりに返ってきましたが、それは 1 本のクリップであってテストではなく、実際の写真を Vidu で実行してはいません。Seedance での実践的なアドバイスは、見せ場は文章ではなく静止画に入れておくこと。まさにそのための image-to-video です。
シーン別の選び方
| シーン | 選ぶもの | 理由 |
|---|---|---|
| 静止画からの最も強いレベル(L3)、親密なシーン、または最も強い L5 の要求 | Seedance 2.5 Spicy | 3 回中 3 回描画。Vidu は毎回 L3 と親密なシーンを控えめにした |
| 同じシーンで、テキストのみの開始、参照クリップ、30 秒のテイクも欲しい | Seedance 2.5 | 3 つとも使える。画像と参照の実行で L1〜L4 を描画 |
| 静止画からの部分的なレベルや合意のうえでの拘束を高解像度で | Vidu Q4 Preview の image-to-video | 各レベルで 3 回中 3 回描画し、4k まで対応 |
| 自分で用意した声での台詞 | Vidu Q4 Preview | 台詞をプロンプトに引用する。クリップが声を決める |
| 15 枚を超える登場人物、またはカメラと動きの参照動画 | Seedance 2.5 | 画像 30 枚、動画 10 本、音声 10 本 |
| 参照から(フレームではなく)最も強いレベルを求めるもの | Vidu の reference-to-video 以外 | 拒否された。人物のフレームから image-to-video で始める |
| 映画的な流血 | Vidu Q4 Preview または Seedance 2.5 Spicy | どちらも描画(通常版の Seedance 2.5 は未実施) |
どちらでも実行の無駄を減らす習慣が 2 つあります。まず最短の長さで動きを確認すること、そして最初のフレームに必要なものをすでに映しておくことです。Vidu の reference-to-video の拒否は 60〜90 秒後に返り、課金されません。同じ静止画を両方に送るのが、自分のシーンにどちらの解釈が合うかを知る最短の方法です。前世代の Vidu を同じ条件で見るには、Vidu Q3 の NSFW テスト があります。
よくある質問
Vidu Q4 Preview は Seedance 2.5 より検閲が緩いですか? 最も強いレベル(L3)や親密なシーンについては違います。image-to-video は一度も拒否されませんでしたが、3 回中 3 回、L3 のリクエストをフレームの腰より上に収めるか下着を残しました。Seedance 2.5 Spicy は 3 回中 3 回描画しました。部分的なレベルと拘束では、Vidu の image-to-video は Seedance 2.5 Spicy と同等でした。親密なシーンでは 3 回中 3 回とも控えめになり(行為は示唆にとどまり、接触はフレーム外)、Seedance 2.5 Spicy は 3 回中 3 回描画しました。
Seedance 2.5 は検閲なしですか? 私たちの API ではコンテンツフィルターを追加しておらず、実行では画像タスクと参照タスクで L1〜L4 が描画されました。ただし ByteDance 自身のチェックは働き、一部の表現、特にキスは拒否されます。
Seedance 2.5 Spicy は何のためのものですか? 4k の解像度を備えた image-to-video 専用ビルドで、私たちの実行ではテストしたすべてのレベルで描画されました。text-to-video も参照入力もありません。ほかの読み方は 以前の比較 にあります。
参照が多いのはどちらですか? Seedance 2.5 です。画像 30 枚、音声クリップ 10 本、動画クリップ 10 本で、Vidu は画像 15 枚と音声クリップ 3 本です。
音声クリップは言葉まで引き継ぎますか? どちらのモデルでも引き継ぎません。台詞はプロンプトに引用符で書いてください。クリップが決めるのは聞こえ方です。