はじめに
Wan 3.0 テキストから動画 は、書いたプロンプトだけから音声付きの 2〜30 秒のクリップを生成します。必須フィールドは prompt だけです。duration_seconds、resolution(480p・720p・1080p、既定は 720p)、aspect_ratio(既定は 16:9)、generate_audio、enable_prompt_expansion、seed はいずれも明示的な設定で、既定値のままでもかまいません。画像でショットを固定しないため、顔も衣装もセットもすべて文章からモデルが作り出します。Wan 3.0 のモードの中で表現の幅はいちばん広く、特定の人物を再現する力はいちばん弱いモードです。
開始素材に応じてモードを選ぶ
| 開始素材 | モード |
|---|---|
| 書いたブリーフから、場面、行動、カメラ、必要に応じて音を組み立てます。 | Wan 3.0 テキストから動画 |
| 承認済みの開始画像が被写体と構図を決め、指示文がその後の動きを導きます。 | Wan 3.0 画像から動画 |
| 別々の参照素材に、人物、場所、動き、音の役割を明確に割り当てられます。 | Wan 3.0 参照から動画 |
主な機能とハイライト
音も同じリクエストで指示できます
generate_audio は既定でオンなので、返ってくるファイルには映像に合わせた音がすでに入っています。武器庫のサンプルはこれを意識的に使っています。プロンプトの最後に「Audio:」の行を置き、革手袋が木に落ちる音、紐がきしむ音、松明がはぜる音を指定しているので、それぞれの音が原因となる動作と一緒に返ってきます。別途スコアを付けるときだけ false にしてください。
2〜30 秒の任意の整数秒
duration_seconds は 2〜30 のすべての整数を受け付け、既定は 5 です。-1 を渡すとスマート尺になり、モデルがプロンプトから長さを決めます。砂丘のサンプルは既定の 5 秒、720p・16:9 で、砂嵐の壁から彼女の顔まで空撮で降りてくる動きを 1 本収めています。長いクリップほど人物や形が崩れやすいので、まず 5 秒で見た目を固めてから延ばしてください。
言葉だけで無検閲のシーンを
このファミリーは無検閲で、どのシーンにもフラグやリクエストごとの申告は要りません。ドライブインのサンプル(ステーションワゴンの荷台に寝そべる成人女性 2 人を映写機の光だけが照らし、ゆっくりしたキスで終わるシーン)は、5 秒・720p でプロンプトの文章だけから生成しました。映っているすべての人について、同意、権利、年齢、現地の法律に対する責任はお客様にあります。
リクエストパラメーター
| パラメーター | 必須 | 説明 |
|---|---|---|
prompt | はい | カットそのものです。被写体、動作 1 つ、カメラの動き 1 つ、そのあとに光と音。 1 文字以上 |
aspect_ratio | いいえ | 16:9、9:16、1:1、4:3、3:4、adaptive から選びます。adaptive はモデルに選ばせる指定です。 |
enable_thinking | いいえ | 生成の前に、指示と参照素材をモデルにじっくり読み込ませます。長いドキュメントや Web ページ、複雑な参照画像に向いていますが、処理は遅くなります。 デフォルト値: |
resolution | いいえ | 480p、720p、1080p。既定は 720p。 |
duration_seconds | いいえ | 2〜30 の任意の整数秒、または -1 でスマート尺です。スマート尺ではモデルが長さを決め、上限の 30 秒分を先に確保して、実際に出力された長さで精算します。 |
generate_audio | いいえ | 既定でオン。映像に固定された音付きでクリップが返ります。 デフォルト値: |
enable_prompt_expansion | いいえ | 既定でオフ。オンにすると生成前にプロンプトが書き直され、薄いブリーフには効き、詳細なブリーフとは喧嘩します。 デフォルト値: |
seed | いいえ | 0〜2147483647。1 フィールドずつ比べるときは固定し、幅が欲しいときは外してください。 |
料金
| 仕様 | 料金 |
|---|---|
| $0.045 / 秒 |
| $0.09 / 秒 |
| $0.18 / 秒 |
ユースケース
元画像なしで雰囲気のある場面を作る
ロケーションの写真がないときは、プロンプトがそれを組み立てます。砂丘のサンプルは、夕日の砂丘の稜線、押し寄せる巨大な砂嵐、風になびくエメラルドのシルクのドレス、空撮から彼女の顔まで降りてくるカメラを、文章だけで描いています。特定の顔よりも環境が重要なムードフィルムやピッチ用のリールに向いた使い方です。
一人称のフレーミング
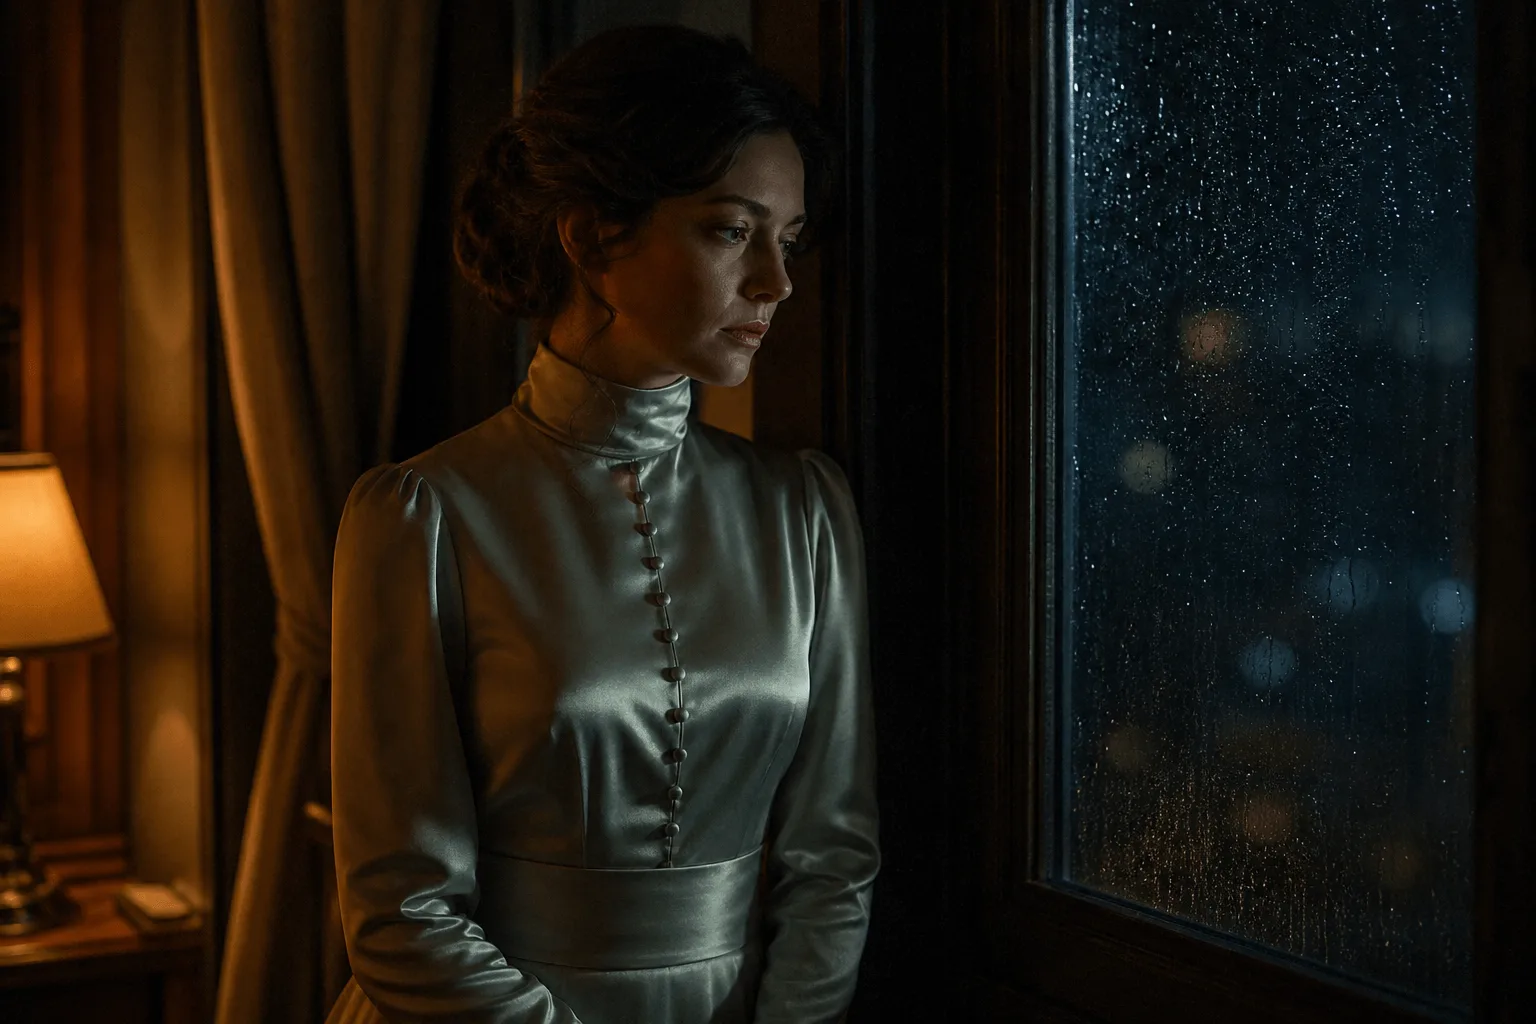
主観ショットのサンプルは、切れ目のない 1 テイクとして書かれています。カメラは見る人自身の目で、光源はタングステンのランプ 1 つだけ、そして衣装は最後まで書いたとおりのままだとブリーフに明記しています。変わらないものを書くことは、動くものを書くのと同じくらい役に立ちます。あいまいなプロンプトをモデルが勝手な方向に解釈するのを防げるからです。
プロンプトガイドと実践のヒント
被写体・動作・カメラ・光・音の順に書く
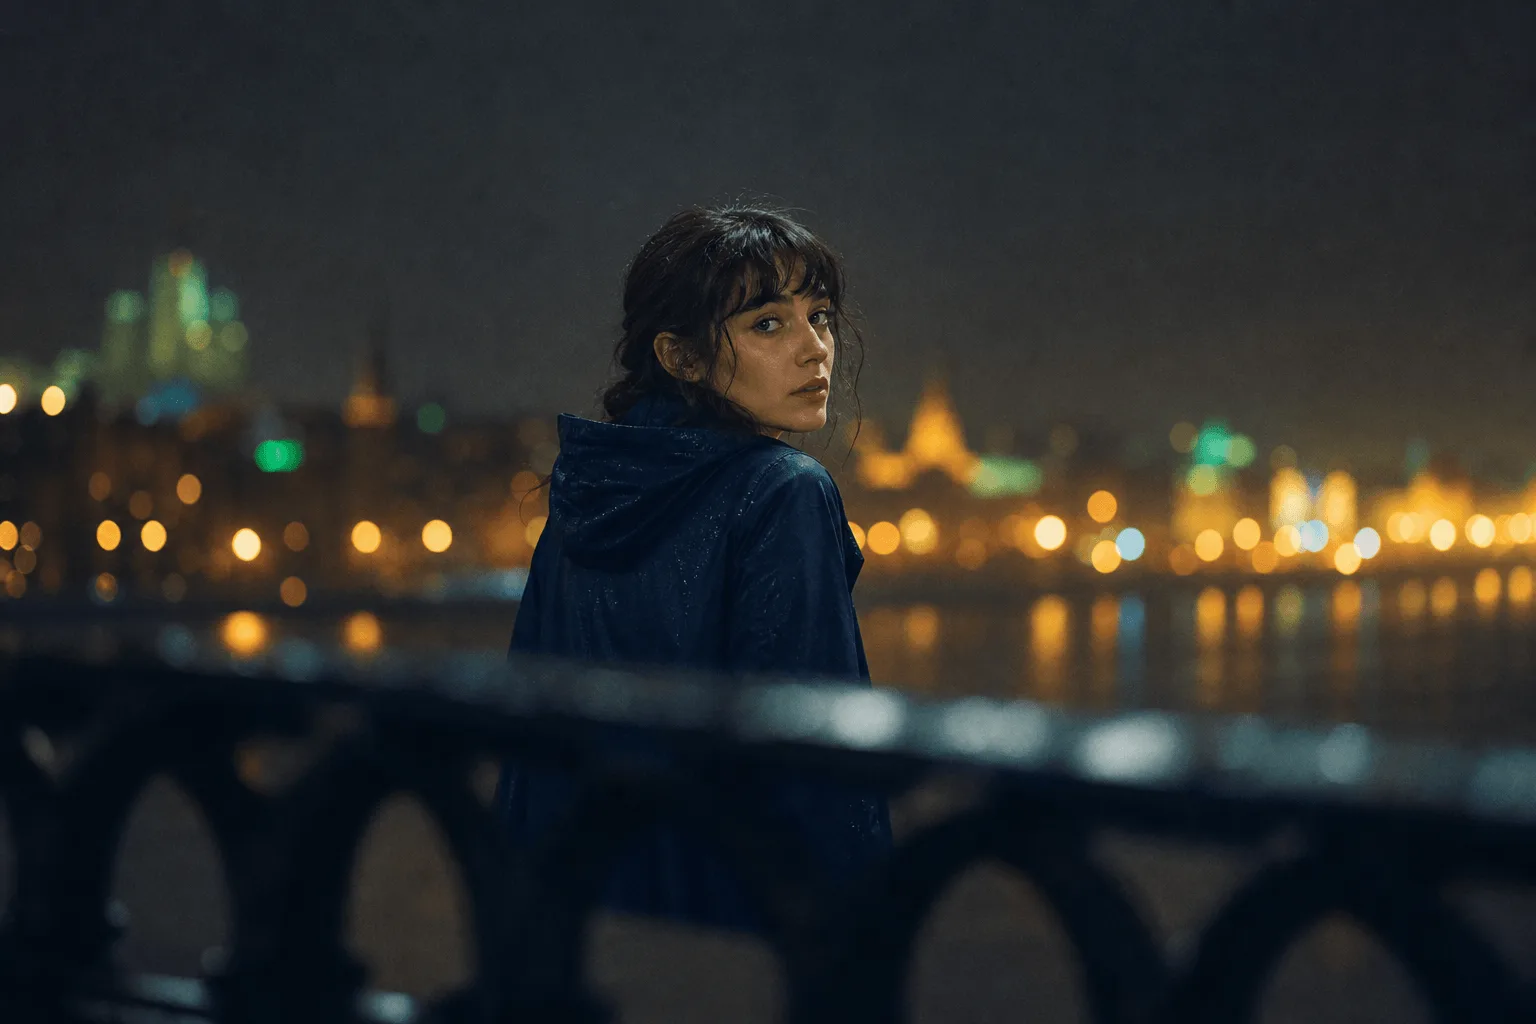
被写体を 1 つ、動作を 1 つ、カメラの動きを 1 つ書き、そのあとに光と音について一言ずつ添えます。形容詞を並べるより、はっきりした動作を 1 つ書くほうが結果は大きく動きます。ファミリーの参考クリップもこの順番どおりです。傘を分け合う女性 2 人、髪をかき上げてからのキス、ゆっくりしたドリーイン、濡れた地面ににじむネオン、傘を打つ雨。
細部が場面を支えるときはフレーミングを指定する
武器庫のプロンプトは、腰から上のミディアムクローズアップ、低めの 3/4 アングル、85mm とフレーミングを明記しています。引きの画では手袋も紐も、肩に当たる松明の光も失われるからです。細部が大事なときは、モデルが寄りの画を選んでくれることに期待せず、画面の中でどれくらいの大きさにしたいかを書いてください。
細かく書いたブリーフではプロンプト拡張をオフに
ここでは enable_prompt_expansion の既定値は false です。オンにすると生成前にプロンプトが書き換えられ、2 行程度のアイデアには役立ちますが、上のような細かいブリーフとは衝突します。比較のために再実行するときは seed を固定し、1 回に 1 つのフィールドだけを変えてください。シードを固定すれば比較は公平になりますが、同じフレームになる保証はありません。テキストだけでは実行をまたいで同じ顔を保てないので、繰り返し登場する人物には reference-to-video を使ってください。
API クイックスタート
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "alibaba/wan-3.0/text-to-video",
  "input": {
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise",
    "resolution": "720p",
    "aspect_ratio": "16:9",
    "duration_seconds": 5
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
認証、完全なスキーマ、ポーリング、エラー処理は API リファレンスを参照してください。