本文へスキップ

daVinci-MagiHuman API

sand-ai/davinci-magihuman/image-to-video

daVinci-MagiHuman の画像から動画は、手持ちの写真から 5〜10 秒のクリップを始め、動きと声を加えます。プロンプトでセリフを引用するか、音声ファイルを添付してください。256p、720p、1080p に対応し、16:9 か 9:16 を選べます。

最低価格 $0.024/秒

プレイグラウンド

入力

画像から動画
211/5000
写真のあとに起きることを書いてください。人物が何をするか、そして引用符の中で何を言うかです。audio_url を指定した場合は言葉を書かず、雰囲気、動き、光を書いてください。 3 文字以上 · 5000 文字以内
1/1

ファイルやメディアのリンクをドロップ、貼り付け、または選択 · 1 ファイル・1 件 10 MB まで・JPG · PNG · WEBP

  • 1
1 / 1 ファイル
開始フレームです。公開されていて直接ダウンロードできるリンクを指定してください。クリップはこの写真から始まります。
0/1

音声ファイルをここにドロップ、またはここから選択 · 1 ファイル・1 件 90 MB まで・MP3 · WAV

0 / 1 ファイル
任意です。音声または歌のファイルへの公開リンクです。声を作る代わりに、その音声に合わせて動画が生成されます。当社の試行では、5 秒の録音を 5 秒のクリップに使いました。
16:9(既定)か 9:16 です。当社の画像から動画の試行はすべて 16:9 でした。アスペクト比によって料金は変わりません。
料金に影響
256p、720p(既定)、1080p のいずれかです。解像度が高いほど 1 秒あたりの料金は上がります。モデルは小さく描画し、高い解像度は超解像の工程で作られます。当社の 720p の試行は約 1358 x 678 で返ってきました。
長さ料金に影響
5〜10 秒、既定は 5 秒です。秒数ごとに課金されます。 5 以上 · 10 以下
シード値
任意の整数です。同じ seed と同じ入力では、似た結果になりますが、同一になることは保証されません。 0 以上 · 2147483647 以下
セーフティチェックオフ

SpicyAPI はこのモデルにセーフティチェックをかけません。プロンプトと素材はそのままモデルに渡り、出力はモデル自身が決めます。

送信と料金見積もりを有効にする前にアカウントを確認しています。

出力

実行待ち
サンプル出力

お探しのモデルが見つかりませんか?

必要なモデルと用途をお知らせください。次に何を追加するかを決めるチームに直接届きます。

トーキング動画 API

daVinci-MagiHuman API のポイント

映像と声を一緒に生成する 1 つの 15B モデル。テキストか写真から、カメラに向かって話す人物を 5〜10 秒、最大 1080p で作ります。

パラメータ数
15B
1 つのモデルが映像とサウンドトラックを一緒に生成します。重みは Apache 2.0 のもとで公開されています。
クリップの長さ
5〜10 秒
5 秒から 10 秒の間で選べます。既定は 5 秒です。当社のクリップは 25 fps で返ってきました。
最高解像度
1080p
256p、720p(既定)、1080p。モデルは小さく描画し、高い解像度はモデル自身の超解像の工程で作られます。サイズは公称値に近く、1080p では約 1904 x 1088 でした。
画面の形
2
両方のエンドポイントで、横長 16:9(既定)か縦長 9:16 を選べます。音声と画面の形では料金は変わりません。
手持ちの音声
任意
音声または歌のファイルを audio_url で送ると、声を作る代わりに、その音声に合わせて動画が生成されます。
話せる言語
6
中国語(北京語・広東語)、英語、日本語、韓国語、ドイツ語、フランス語。出品元の掲載情報によります。当社のテストは英語です。

作例

daVinci-MagiHuman で作れるもの

  • テキストから動画

    バルコニーで語られる一言

    引用セリフを含む 1 つのプロンプトから、夜のバルコニーに立つ白金色のボブの女性を写した 1080p のクリップができました。背後では街の明かりがぼやけています。約 1904 x 1088、25 fps、5.0 秒で、音声付きで返ってきました。サウンドトラックを文字起こしすると、セリフと一語一句一致しました。処理には約 3 分 53 秒かかりました。

    テキストから動画。1080p・16:9、5 秒。引用されたセリフが、サウンドトラックで話されています。

  • ポートレート

    笑いとセリフのある縦型クリップ

    画面の形を 9:16 に設定すると、雨に濡れたネオンの通りで、そばかすのある赤毛の男性が笑い、セリフを言います。720p では約 726 x 1270、5.0 秒で返ってきました。文字起こしもセリフと一語一句一致しました。処理には約 1 分かかりました。自撮りを頼む代わりに、"looks straight into the camera" と書きました。

    縦型のテキストから動画。9:16・720p、5 秒。引用されたセリフが、サウンドトラックで話されています。

  • 画像から動画

    振り向いて話し出す一枚の写真

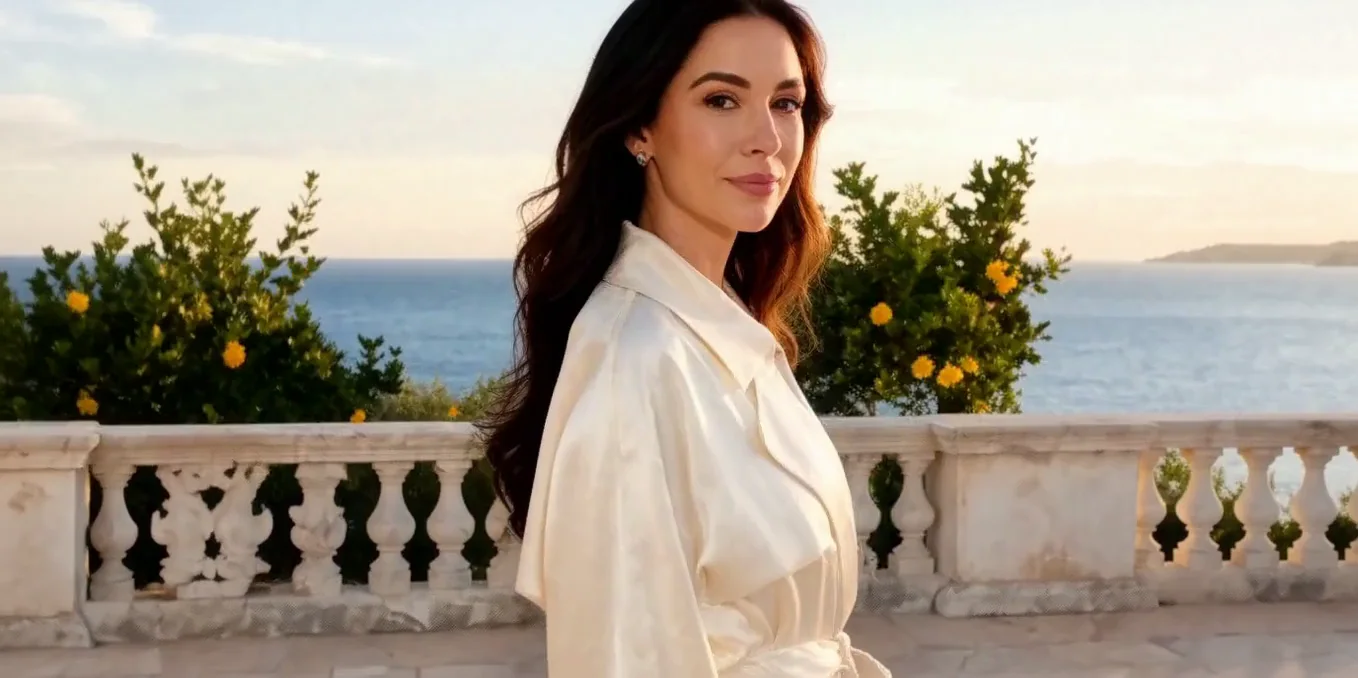
    開始フレームの画像とプロンプトから、音声ファイルなしで生成しました。彼女は海のほうから振り向き、髪を耳にかけて、セリフを言います。文字起こしは一語一句一致しました。720p では約 1358 x 678、5.0 秒で、約 1 分 45 秒後に返ってきました。

    音声ファイルなしの画像から動画。16:9・720p、5 秒。引用されたセリフが、サウンドトラックで話されています。

  • 手持ちの音声

    録音に合わせて動く肖像

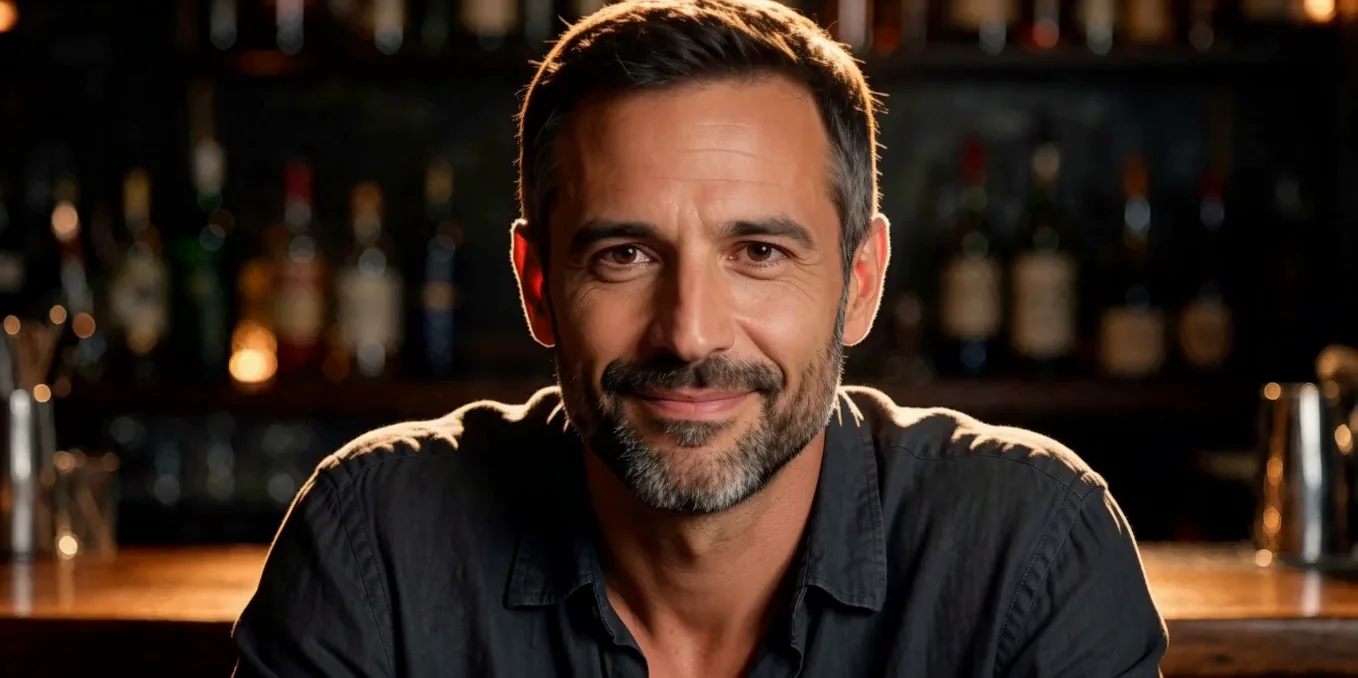
    audio_url に 5 秒の話し声のクリップを指定すると、口元は提供された音声に従い、半分の微笑みと眉の動きも加わりました。顔は入力したポートレート写真に近いまま保たれました。720p では約 1358 x 678、5.0 秒で、約 3 分 7 秒後に返ってきました。

    画像から動画。5 秒の話し声のクリップを audio_url に指定、16:9・720p、5 秒。

実行する前に

daVinci-MagiHuman を使う前に知っておきたいこと

すべてのモード
クリップは 5〜10 秒で、256p、720p、1080p のいずれか、16:9 か 9:16 です。サイズは公称値に近い値で、完全に一致するわけではありません。16:9 の 720p は約 1358 x 678、1080p は約 1904 x 1088 でした。当社が試したのは英語の音声で、歌は試していません。クリップに何が映るかは、プロンプトと当社の利用ポリシーによります。
テキストから動画
人物と場面は文章から生まれるので、構図を書いてください。スマートフォンで自撮りする指定をしたところ、追加の 1 回の試行で画面にスマートフォンが映りました。このエンドポイントでは audio_url を試していません。
画像から動画
開始フレームの画像は必須で、クリップはそこから始まります。当社の画像から動画の試行は、すべて 16:9 でした。audio_url では 5 秒の録音を 5 秒のクリップで試しましたが、クリップより短い録音や長い録音は試していません。

活用例

daVinci-MagiHuman API で作れるもの

  • 短い発話クリップ

    人物がカメラに向かって 1 言だけ話す、5〜10 秒のクリップです。自己紹介、予告、あいさつなどに使えます。声はこちらで生成されます。

  • スマホ向けの縦型クリップ

    フィードやストーリーズには、画面の形を 9:16 に設定してください。当社の縦型の試行は、720p で約 726 x 1270 で返ってきました。

  • 手持ちの録音で話すポートレート

    写真を出発点にし、音声ファイルを audio_url で追加します。口元は手持ちの音声に従い、顔は写真に近いまま保たれます。

  • キャラクターとセリフのテスト

    より長い作品を作る前に、開始フレームの写真と短い引用セリフで、キャラクターの見た目と声を試せます。当社のテストは英語で、出品元はほかに 5 つの言語を掲載しています。

プロンプト

コピーして使える daVinci-MagiHuman のプロンプト例

まずはそのまま Playground に貼り付け、そのあと一度にひとつずつ変えてみてください。

  • テキストから動画

    人物、場所、引用セリフ、そして光

    このプロンプトの結果

    Close-up at night on a hotel balcony, city lights blurred behind. A woman in her thirties with a short platinum bob and a black slip dress leans on the rail, looks into the camera with a sly smile and says softly: "You really thought I'd leave without saying goodbye?" Warm practical light, shallow depth of field.

    うまくいく理由. 人物と場所を先に書き、セリフは話し方とともに引用符に入れ、最後に光で締めくくっています。文字起こしはセリフと一語一句一致しました。

    このプロンプトを試す
  • テキストから動画

    視線の行き先を書く

    このプロンプトの結果

    Vertical medium close-up on a rainy neon-lit street at night. A man in his late twenties with freckles, short ginger hair and a wet denim jacket looks straight into the camera, laughs and says: "Okay, I'm lost, but honestly? Best night of the trip." Rain drips from his hair, pink and blue sign reflections on the wet pavement behind him. Handheld, eye level.

    うまくいく理由. "looks straight into the camera" が構図を決めました。追加の試行では、スマートフォンで自撮りを頼んだところ、代わりに画面にスマートフォンが映りました。

    このプロンプトを試す
  • 画像から動画

    写真に次の瞬間を与える

    このプロンプトの結果

    On a sunlit stone terrace above the sea, she turns from the view to the camera, tucks her hair behind her ear and says warmly: "Stay for one more sunset. The boat can wait." Gentle sea breeze, soft golden light.

    うまくいく理由. プロンプトには、写真のあとに彼女がすることを書いています。カメラへ振り向く、髪を耳にかける、話す、の 3 つです。3 つとも起こり、文字起こしも一致しました。

    このモードはご自身の画像から始まります。実行前に Playground で画像を追加してください。

    このプロンプトを試す
  • 画像から動画

    自分の声で、見せ方を指定する

    このプロンプトの結果

    Leaning on the bar, he speaks low and teasing, a slow half smile and a raised eyebrow, warm amber light.

    うまくいく理由. セリフは渡した音声から来るため、プロンプトは雰囲気、動き、光だけを指定しています。口元は音声に従い、半分の微笑みと眉の動きも見られました。

    このモードはご自身の画像から始まります。実行前に Playground で画像を追加してください。

    このプロンプトを試す

比較

daVinci-MagiHuman と近いモデルの比較:どれを選ぶか

モデルモード最低価格コンテンツこんなときに
OmniHuman 2.0トーキングアバター$0.108 / 出力秒フィルターあり — このモデルは、モデル自身の許容範囲を超える指示を明確に拒否します。実測済みの結果です。未計測のモデルには表示が付きません。声の録音と肖像写真がすでにあり、その音声で動く、最長 300 秒のクリップが欲しい場合に向いています。書いた引用セリフをモデルに話させたい場合や、9:16 のクリップが必要な場合は、代わりに daVinci-MagiHuman を選んでください。
Kling Avatar 2.0トーキングアバター$0.051 / 出力秒フィルターあり — このモデルは、モデル自身の許容範囲を超える指示を明確に拒否します。実測済みの結果です。未計測のモデルには表示が付きません。肖像写真と手持ちの音声があり、その音声で動くクリップが欲しい場合です。OmniHuman 2.0 と同じ考え方です。書いた引用セリフをモデルに話させたい場合は、代わりに daVinci-MagiHuman を選んでください。

料金

daVinci-MagiHuman API の料金

5 秒のクリップは 256p で $0.12 から、1080p で $0.36 からです。

プレイグラウンドで、実行前に設定に合った正確な料金を確認できます。失敗またはタイムアウトしたタスクは、通常課金されません。一部のモデルでは、モデルページに明記されたとおりコンテンツ拒否も課金対象です。送信前に課金条件を確認してください。

すべての料金区分を見る

はじめ方

3 ステップで daVinci-MagiHuman API を使う

  1. ステップ 1

    セリフを引用符で囲む

    モデルは引用符の中の言葉を話します。誰がどのように話すか(例:静かに、温かく、笑いながら)を書き、そのあとにセリフそのものを置いてください。当社が試した引用セリフ 3 つは、5 秒のクリップでそれぞれ 8〜10 語でしたが、どれも一語一句そのまま返ってきました。

  2. ステップ 2

    機器ではなく、構図を書く

    追加で行った 9:16 の試行では、スマートフォンで自撮りする指定をしたところ、カメラのほうを向いたスマートフォンが画面に映り込みました。代わりに "looks straight into the camera" と、ショットサイズ("vertical medium close-up")を書いてください。

  3. ステップ 3

    audio_url で自分の声を使う

    音声または歌のファイルを添付すれば、プロンプトに言葉を書く必要はありません。雰囲気、動き、光を書いておけば、口元は録音に合わせて動きます。当社の試行では、5 秒の録音を 5 秒のクリップに合わせられました。

パラメーターの詳細とコード例は、このページ上部の API タブと Readme タブにあります。

SpicyAPI を選ぶ理由

daVinci-MagiHuman を SpicyAPI で使う理由

  • 当社独自のフィルターなし

    当社はコンテンツフィルターを追加しません。モデルが生成したものがそのまま届きます。

  • 推測ではなく実測

    コンテンツのレベルは、当社が実際に生成して確認した結果にもとづき、テスト日もページに記載しています。

  • 成果ごとに米ドルで支払い

    定額プランもクレジットもありません。 失敗やタイムアウトのタスクは通常、課金されません。ただし、モデルページに明記された一部のモデルではコンテンツ拒否も課金対象です。送信前にその課金条件をご確認ください。

  • すべてのモデルにひとつのキー

    1 つの API Key と残高で、画像、動画、音声、チャットのモデルを利用できます。同じアカウントで、さまざまなモデルを試せます。

FAQ

daVinci-MagiHuman API のよくある質問

daVinci-MagiHuman について

daVinci-MagiHuman は、Sand.ai と SII-GAIR によるオープンな 150 億パラメータのモデルを 1 つの API にまとめています。テキストから動画と画像から動画に対応し、映像と音声を一緒に生成します。256p、720p、1080p のいずれかで、16:9 か 9:16 の 5〜10 秒が得られ、手持ちの音声を使うこともできます。課金はリクエストした長さの秒数ごとで、失敗したリクエストには課金されません。

関連モデルと次のステップ