本文へスキップ

Wan 2.1 LoRA の画像から動画は、あなたの写真を 480p または 720p の 5 秒か 10 秒のクリップにし、カメラワーク LoRA を含む自前の LoRA ファイルを最大 3 つ使えます。クリップは写真の形を保ち、何もフィルターされません。

最低価格 $0.24/回

プレイグラウンド

入力

画像から動画
必須です。LoRA にトリガーワードがあれば先に書き、続けて最初のフレームのあとに何が起きるか、カメラがどう動くかを書きます。何を変えたいかをはっきり書いてください。そうしないと、モデルは写真に近いままになります。 1 文字以上
1/1

ファイルやメディアのリンクをドロップ、貼り付け、または選択 · 1 ファイル・1 件 10 MB まで・JPG · PNG · WEBP · GIF

  • 1
1 / 1 ファイル
最初のフレームです。クリップはこの写真の形を保ちます。公開されていて、直接ダウンロードできる JPEG、PNG、WebP を指定してください。 1 文字以上
料金に影響
480p(既定)か 720p。720p はクリップあたりの料金が高く、時間もかかります。形は写真に従います。
長さ料金に影響
510
5 秒(既定)か 10 秒。ほかの長さは拒否されます。10 秒のクリップは 5 秒のクリップの 1.5 倍の料金です。
スタイル LoRA1/3

360 Orbit

Wan 2.1 14B 向けに学習した {path, scale} を最大 3 つ(画像から動画の LoRA の多くは 480P チェックポイントで学習されていますが、720p でも動きます)。path は .safetensors ファイルへの公開の直接リンクで、scale は 0〜4(既定は 1)。LoRA の読み込みで料金は変わりません。 3 件以内
セーフティチェックオフ

SpicyAPI はこのモデルにセーフティチェックをかけません。プロンプトと素材はそのままモデルに渡り、出力はモデル自身が決めます。

送信と料金見積もりを有効にする前にアカウントを確認しています。

出力

実行待ち
サンプル出力

お探しのモデルが見つかりませんか?

必要なモデルと用途をお知らせください。次に何を追加するかを決めるチームに直接届きます。

LoRA 動画 API

Wan 2.1 LoRA API のポイント

Wan 2.1 を自前の LoRA で。場面を文章で書く、写真を動かす、クリップのスタイルを変える。5 秒または 10 秒、コンテンツフィルターなし。

1 回あたりの LoRA
3
1 リクエストにつきウェイトファイルを 3 つまで、それぞれ 0〜4 の個別の strength で。
読み込める LoRA
2.1, 2.2
Wan 2.1 14B の LoRA が読み込めます。当社のテストでは、Wan 2.2 の単一ファイルや低ノイズ側の LoRA も結果を変えました。
入り口
3
プロンプト、冒頭の写真、またはスタイルを変えたい自前のクリップ。
クリップの長さ
5/10 秒
長さは 2 通り。10 秒のクリップは 5 秒のクリップの 1.5 倍の料金です。
最大解像度
720p
480p または 720p。テキストから動画は 16:9 か 9:16、写真とクリップは元の形のままです。
コンテンツフィルター
なし
無検閲: LoRA の審査も、結果へのフィルターもありません。

作例

Wan 2.1 LoRA で作れるもの

  • カメラ LoRA

    カメラの動きは LoRA から

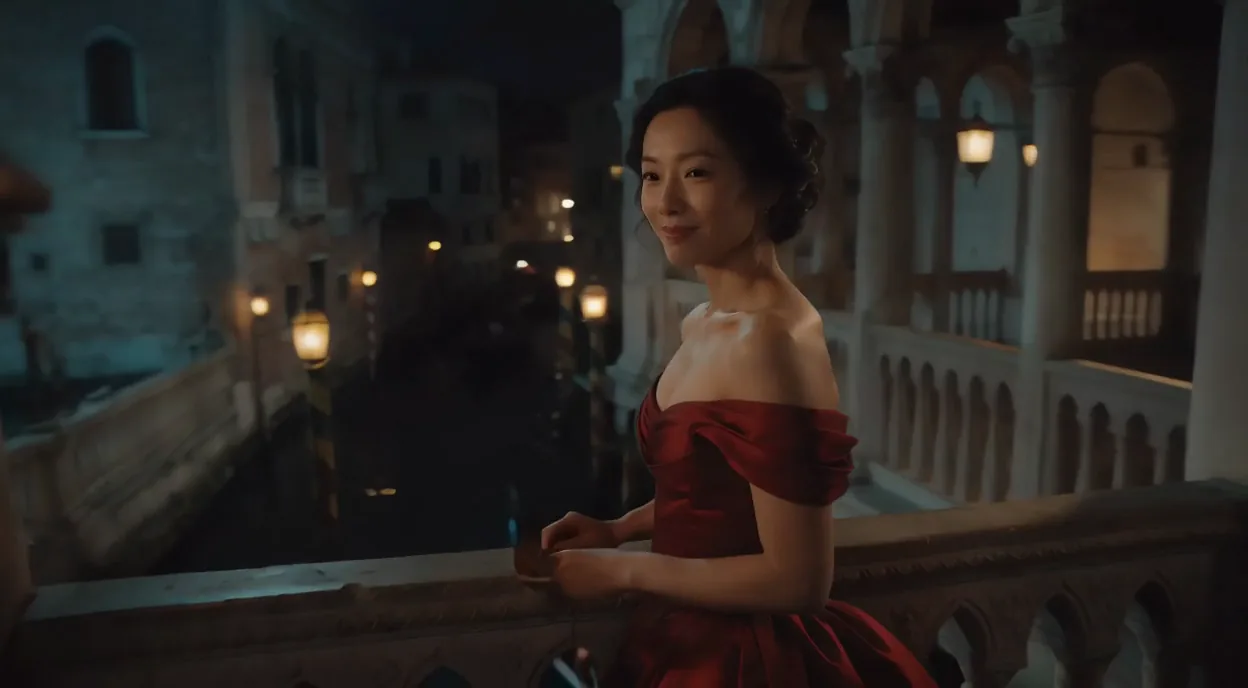
    Wan 2.1 の画像から動画向けに学習した 360 度オービット LoRA を、トリガーフレーズ付きで。同じ seed でこれなしだとカメラは動かず、使うと彼女の背後から運河のほうへ回り込むショットになります。

    360 度オービット LoRA(1)を使った画像から動画、720p、5 秒。

  • スタイル LoRA

    実写で入れて、アニメで出す

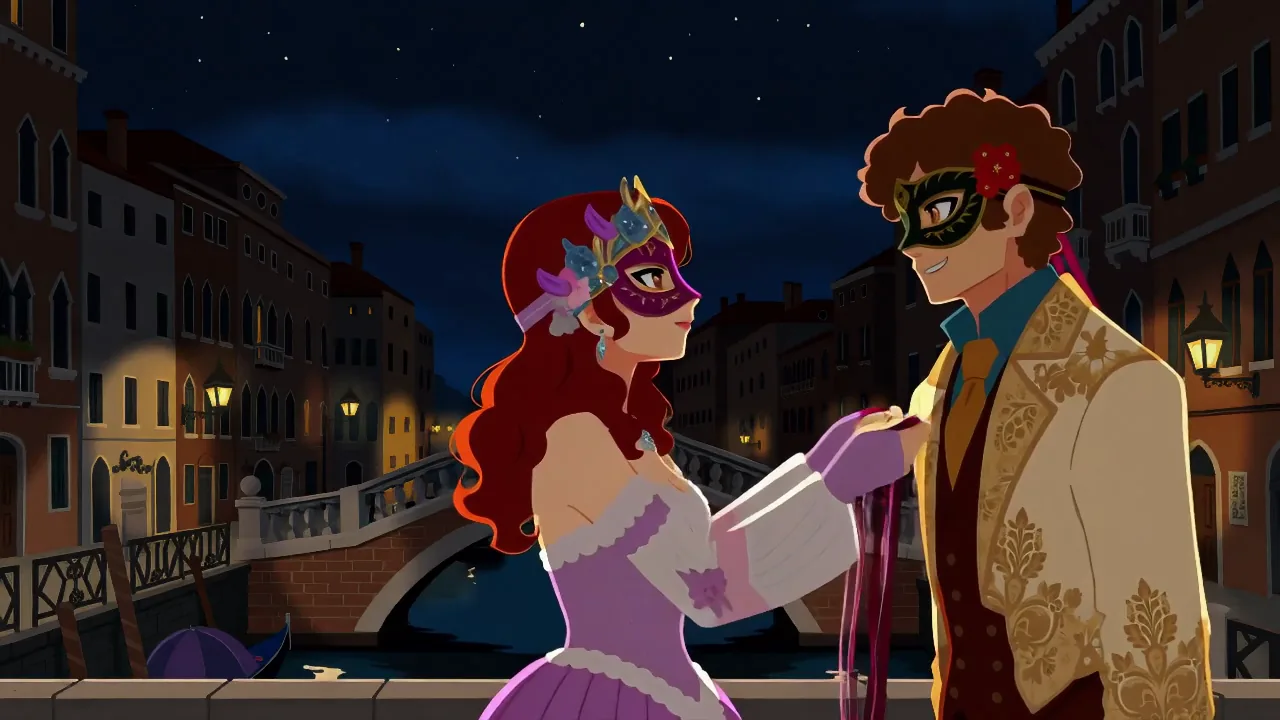
    同じプロンプト、同じ seed で、LoRA なしだと橋の上の実写のカップル、フラットカラーの LoRA を scale 1 で使うと、同じ瞬間がセル調のアニメーションになります。

    フラットカラーのスタイル LoRA(1)を使ったテキストから動画、720p、16:9。

  • 画像から動画

    静止画から生まれる親密な瞬間

    LoRA なしです。ランタンの灯る階段で、1 人がもう 1 人の仮面を持ち上げます。写真の光と布地が、ゆっくりしたプッシュインのあいだも保たれます。

    LoRA なしの画像から動画、720p、5 秒。

Wan 2.1 LoRA で作ったその他のクリップ

  • 5 秒
  • LoRA なしのテキストから動画、720p、16:9、5 秒。
    5 秒
  • LoRA なしの動画から動画、480p、strength 0.9、5 秒。
    5 秒
  • ドリーエフェクト LoRA(1)を使った、縦長写真の画像から動画、720p。
    5 秒
  • LoRA なしのテキストから動画、480p、16:9、10 秒。
    10 秒
  • フラットカラー LoRA を 1 で使った動画から動画、480p、縦向きの元動画。
    5 秒

コンテンツテスト

Wan 2.1 LoRA は規制なし? 実際に試した結果

本番と同じ構成で各レベルを実行し、すべてのクリップをコマ送りで確認しました。「生成」はリクエストが通っただけでなく、その内容が実際に映っていたことを意味します。

Wan 2.1 LoRA でテストしたコンテンツレベル(モード別)
レベル画像から動画テキストから動画動画編集
軽めテストの中で最も軽いプロンプト
生成2026年10月9日 にテスト
生成2026年10月9日 にテスト
生成2026年10月9日 にテスト
中程度フィルターのあるモデルが断り始める地点
生成2026年10月9日 にテスト
生成2026年10月9日 にテスト
生成2026年10月9日 にテスト
強め尺度の中ほど
生成2026年10月9日 にテスト
生成2026年10月9日 にテスト
生成2026年10月9日 にテスト
かなり強め多くのモデルが手加減し始める地点
未テスト
未テスト
未テスト
最大尺度の最上段
未テスト
未テスト
未テスト

生成:書いたとおりに映ります。置き換え:生成はされますが、書いた内容より控えめになります。拒否:リクエストが拒否されます。未テスト:そのモードでそのレベルはまだ試していません。

モードごとの挙動

すべてのモード
5 秒と 10 秒だけで、クリップに音声トラックはありません。LoRA は .safetensors ファイルへの公開された直接リンクである必要があり、1 リクエストあたり最大 3 つです。ゲート付きのファイル、ページのリンク、無関係なモデル向けの LoRA はリクエストが失敗し、課金されません。フィルターなしの LoRA を使わないと、最も強いリクエストは和らげられて返ります。強めのレベルの内容は描画され、かなり強めのレベルは和らげられます。
テキストから動画
形は 16:9 と 9:16 の 2 つだけです。
画像から動画
クリップは写真の形を保つので、選べるアスペクト比はありません。モデルは写真の内容に近いまま動くため、プロンプトで変更をはっきり求めない限り、写真の服装は保たれがちです。
動画編集
結果が元の動画より長くなることはなく、10 秒の選択は元動画がそれより短くても 10 秒の料金で課金されます。video_url は動画を指す必要があります。画像のリンクは拒否されず、1 フレームのクリップが返り、それでも課金されます。strength がおよそ 0.6 を下回ると、ほぼ元のまま返ります。

活用例

Wan 2.1 LoRA API で作れるもの

  • 1 人のキャラクターで、たくさんのクリップ

    毎回のリクエストに同じキャラクターやスタイルの LoRA を読み込めば、シリーズ全体で顔とルックがそろいます。

  • 静止画にカメラワークを

    Wan 2.1 の画像から動画向けに学習したカメラ LoRA が、写真にその動きを加えます。例では、オービット LoRA が宮殿のロッジアに立つ女性の周りを回りました。

  • 手元の映像のスタイル変更

    動画から動画は、クリップの動きとタイミングを保ったまま、プロンプトに従って人物、服装、場所、光を変えます。当社のテストでは、結果は実写のままでした。

  • 規制なしのコミュニティ LoRA

    フィルターなしのキャラクター用とスタイル用の LoRA は、ほかのファイルと同じように読み込まれます。許可リストも審査もなく、結果にフィルターはかかりません。画面に映るすべての人物は成人である必要があります。

プロンプト

コピーして使える Wan 2.1 LoRA のプロンプト例

まずはそのまま Playground に貼り付け、そのあと一度にひとつずつ変えてみてください。

  • テキストから動画

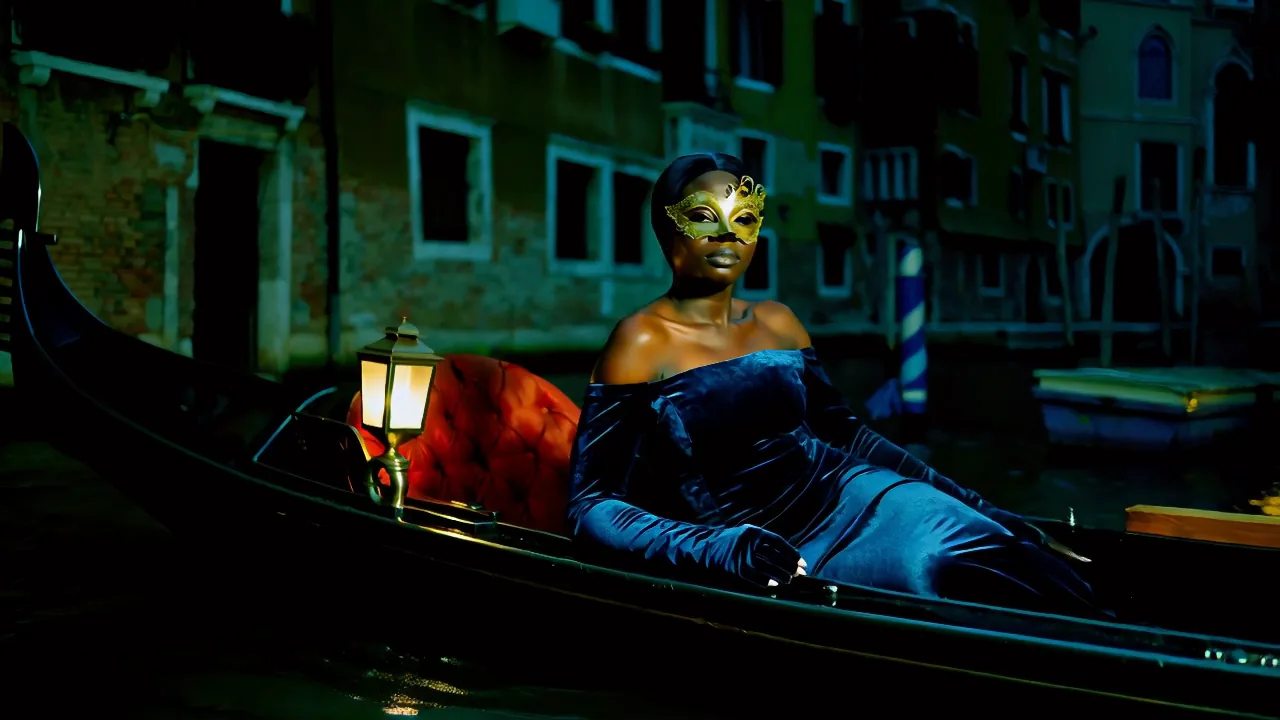
    ゴンドラの上のベルベットのマスク

    このプロンプトの結果

    Night in Venice during carnival. An adult Black woman in her early thirties in a midnight-blue velvet gown with bare shoulders and a gold filigree half-mask reclines on the cushioned seat of a gondola gliding slowly down a narrow canal. Lanterns on striped mooring poles slide past and their light ripples across the black water and her skin. She lifts the mask away from her face, turns her head toward the camera and holds a slow, smouldering gaze. Slow tracking shot alongside the gondola, 35mm, shallow depth of field, warm amber against deep teal, fine film grain.

    うまくいく理由. LoRA なし、ベースモデルのみで 720p。ゴンドラに並走するトラッキングショットで、彼女は長いまなざしでカメラを捉え、ランタンが流れていきます。プロンプトでは仮面を外すことも頼みましたが、彼女は着けたままでした。必要な動作を 1 つ、先に書いて簡潔にしてください。

    このプロンプトを試す
  • 画像から動画

    ロッジアで仮面の客を囲んで

    このプロンプトの結果

    The woman in the crimson gown slowly lowers the gilded mask from her face and turns toward the canal, then back to the camera with a quiet, alluring smile; a gondola glides by below. The camera performs an 0rb4it 360 degree orbit, circling around her on the loggia with the lanterns and the canal sweeping past behind her. Warm lantern light, cinematic.

    うまくいく理由. Wan 2.1 の画像から動画向けの 360 度オービット LoRA を、プロンプトにトリガーフレーズを入れて 1 で使用。LoRA なし(同じ写真、同じ seed)ではカメラは動かず、彼女が首を回すだけでしたが、ありでは、カメラが彼女の背後から運河のほうへ回り込みます。

    このモードはご自身の画像から始まります。実行前に Playground で画像を追加してください。

    このプロンプトを試す
  • テキストから動画

    橋の上のフラットカラーのリボン

    このプロンプトの結果

    flat color, no lineart. Masquerade night in Venice: an adult East Asian woman in a lilac satin gown and an adult white man with curly red hair in a cream brocade coat stand close on a small arched stone bridge over a lantern-lit canal, both wearing ornate half-masks. She reaches up and slowly unties the ribbon of his mask; he smiles and leans in until their foreheads almost touch. Lanterns sway, gentle mist drifts on the water. Slow push-in.

    うまくいく理由. Wan 2.1 のフラットカラー LoRA を、トリガーワード付きで 1 で使用。同じプロンプトと seed で LoRA なしだと、カップルの実写映像になりました。LoRA ありではセル調のアニメーションになり、彼女が彼の仮面のリボンをほどくと、2 人の額が触れ合います。

    このプロンプトを試す

料金

Wan 2.1 LoRA API の料金

リクエスト あたり $0.24 から。

プレイグラウンドで、実行前に設定に合った正確な料金を確認できます。失敗またはタイムアウトしたタスクは、通常課金されません。一部のモデルでは、モデルページに明記されたとおりコンテンツ拒否も課金対象です。送信前に課金条件を確認してください。

すべての料金区分を見る

はじめ方

3 ステップで Wan 2.1 LoRA API を使う

  1. ステップ 1

    ページではなくファイルのリンクを

    Hugging Face の「resolve/main」リンクのように、.safetensors ファイルそのものをダウンロードできる公開リンクを使ってください。リポジトリのページ、ログインが必要なファイル、サインインへリダイレクトされる Civitai のリンクではリクエストが失敗し、失敗したリクエストは課金されません。

  2. ステップ 2

    ベースモデルを合わせる

    Wan 2.1 14B 向けに学習した LoRA を選んでください。テキストから動画の LoRA か、480P・720P の画像から動画チェックポイント向けの LoRA です。当社のテストでは Wan 2.2 の LoRA も効きました。画像モデルなど無関係なモデル向けの LoRA ではリクエストが失敗します。

  3. ステップ 3

    LoRA の確認は画像から動画で

    当社のテストでは、画像から動画は同じ seed と入力でバイト単位で同一のクリップを返しました。そのため、loras を空にした実行と LoRA を入れた実行を比べれば、LoRA が何をしているかがそのままわかります。当社の実行では、0.5 で結果が動き始め、1 でさらに動きました。

パラメーターの詳細とコード例は、このページ上部の API タブと Readme タブにあります。

SpicyAPI を選ぶ理由

Wan 2.1 LoRA を SpicyAPI で使う理由

  • 当社独自のフィルターなし

    当社はコンテンツフィルターを追加しません。モデルが生成したものがそのまま届きます。

  • 推測ではなく実測

    コンテンツのレベルは、当社が実際に生成して確認した結果にもとづき、テスト日もページに記載しています。

  • 成果ごとに米ドルで支払い

    定額プランもクレジットもありません。 失敗やタイムアウトのタスクは通常、課金されません。ただし、モデルページに明記された一部のモデルではコンテンツ拒否も課金対象です。送信前にその課金条件をご確認ください。

  • すべてのモデルにひとつのキー

    1 つの API Key と残高で、画像、動画、音声、チャットのモデルを利用できます。同じアカウントで、さまざまなモデルを試せます。

FAQ

Wan 2.1 LoRA API のよくある質問

Wan 2.1 LoRA について

Wan 2.1 LoRA は、Alibaba のオープンな 140 億パラメータの動画モデルに自前のウェイトを載せられるサービスです。1 リクエストにつき LoRA ファイルを最大 3 つ、それぞれ 0〜4 の strength で、テキストから動画、画像から動画、動画から動画に使えます。クリップは 480p または 720p で 5 秒か 10 秒、steps、guidance、flow shift も調整可能。LoRA は審査されず、何もフィルターされません。

Wan のすべてのモデル22

動画モデル18

関連モデルと次のステップ