はじめに
Wan 2.7 テキストから画像は、文章のアートディレクションから新しい画像を作ります。構図、被写体、光、視覚的な優先順位をブリーフから設計する必要があるときに使います。
手元の素材から Wan 2.7 のモードを選ぶ
| 最初に手元にあるもの | モード |
|---|---|
| 文章のビジュアルブリーフ | Wan 2.7 テキストから画像 |
| 狙いを定めた変更が必要な画像 | Wan 2.7 画像編集 |
主な機能とハイライト
9 枚編集は、書いたとおりに描きます
参照画像を渡せば、image-to-image は送ったブリーフのとおりに描きます。衣装も画面の組み方もそのままです。このプラットフォームには内容のフラグもリクエストごとの申告もなく、それは 2 本のエンドポイントで変わりません。違うのはモデルの側です。text-to-image は踏み込んだプロンプトに対して、控えめな画面を返します。このページのカフェの画像は text-to-image で、オーバーサイズの白いシャツ、窓には雨、という画面です。テキスト側のエンドポイントは、おおよそそのあたりで止まります。
マスクを塗らずに、最大 9 枚をまとめます
image-to-image は 1 リクエストで素材を 1〜9 枚受け取るので、衣服、顔、部屋、色の参照が同じ編集に入れます。プロンプトで各素材の役割を書いてください。ラベルのない積み上げは平均されます。9 枚の編集が濁って返ってくる最も多い原因がそれです。
描く前に、構図を組み立てます
Wan 2.7 は描く前に画面を設計します。それは空間の判断が要るところに現れます。誰が手前にいるのか、手が何を持っているのか、光源がどこにあるのか、といった点です。ここでは、被写体がはっきりして関係がひとつ明快な長い記述が、キーワードの山に勝ちます。
リクエストパラメーター
| パラメーター | 必須 | 説明 |
|---|---|---|
prompt | はい | 画面を書きます。被写体、動作、カメラの位置、そして光とレンズです。 1 文字以上 · 5000 文字以内 |
aspect_ratio | いいえ | 指定できるのは 1:1、4:3、3:4、16:9、9:16、3:2、2:3 で、既定は 1:1 です。画素の予算はどれも同じなので、横長の比率は横に広いだけで大きくはなりません。 |
enable_thinking | いいえ | 生成を始める前にプロンプトを検討させます。オフにすると明らかに速くなり、詳細なプロンプトであれば品質はほとんど変わりません。 デフォルト値: |
num_outputs | いいえ | 1〜4 枚で、どれも同じブリーフに対する別々の seed です。seed 以外は動いていないので、1 つのレイアウトの 4 通りの読み方をそのまま比べられます。 |
resolution | いいえ | 1k か 2k で、既定は 1k です。2k は 1k の 4 倍の画素数になり、縦横の形は |
color_palette | いいえ | 3〜10 色の任意の配色テーマです(推奨は 8 色)。各色を #RRGGBB の 16 進コードで入力し、必要なら画像の何パーセントを占めるかも指定します。 3 件以上 · 10 件以内 |
seed | いいえ | 0〜2147483647 の整数です。固定したまま 1 節ずつ変えてください。 |
料金
$0.03 / 枚
ユースケース
制作前にビジュアルのコンセプトを探る
テキストから画像は、まだ何も決まっていない 1 枚のためのエンドポイントです。残さなければならない顔も服も部屋もないときに使います。被写体、動作、カメラの位置、光、レンズを書き、num_outputs で最大 4 通りを一度に頼めます。それぞれが同じブリーフに対する別の seed で、1 枚ずつ課金されます。
絵コンテのキービジュアルを作る
静止画を 3:2 か 9:16 で生成し、画像から動画のエンドポイントに冒頭のフレームとして渡します。動画のプロンプトは動きだけを担えばよくなるので、衣装とポーズを正確にクリップへ持ち込むいちばん確実な方法です。
キャンペーンのビジュアル体系を作る
seed を 1 つ、プロンプトの骨組みを 1 つ固定し、aspect_ratio を 1:1、3:2、9:16 と変えて、プロフィール、バナー、ストーリーのカードを作ります。画素数はどの比率でも同じなので、横長の画は広くなるだけで、大きくはなりません。
プロンプトガイドと実践のヒント
装飾より先に構図を書く
光、素材、スタイルより先に、被写体、その動作、カメラの位置を書きます。Wan 2.7 は描く前に画面を設計するので、形容詞を積み上げるより、空間の関係を 1 つはっきり書くほうが効きます。
seed を固定し、1 つだけ変える
狙いに近い 1 枚が出たら seed を固定し、衣装、光、比率のうち 1 か所だけを変えます。同じ seed なら乱数が保たれるので、見える違いは変えた部分によるものです。ただし、まったく同じ画像が返る保証はありません。
使い回す前に画素数を確かめる
既定の 1k では、どの比率を選んでも画面は約 101 万〜105 万画素です。resolution: 2k にするとその約 4 倍になります。文章だけだと seed ごとに新しい顔が作られるので、特定の人物を保ちたいなら参照画像を使う画像編集に切り替えてください。enable_thinking をオフにすると目に見えて速くなります。
API クイックスタート
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "alibaba/wan-2.7/text-to-image",
  "input": {
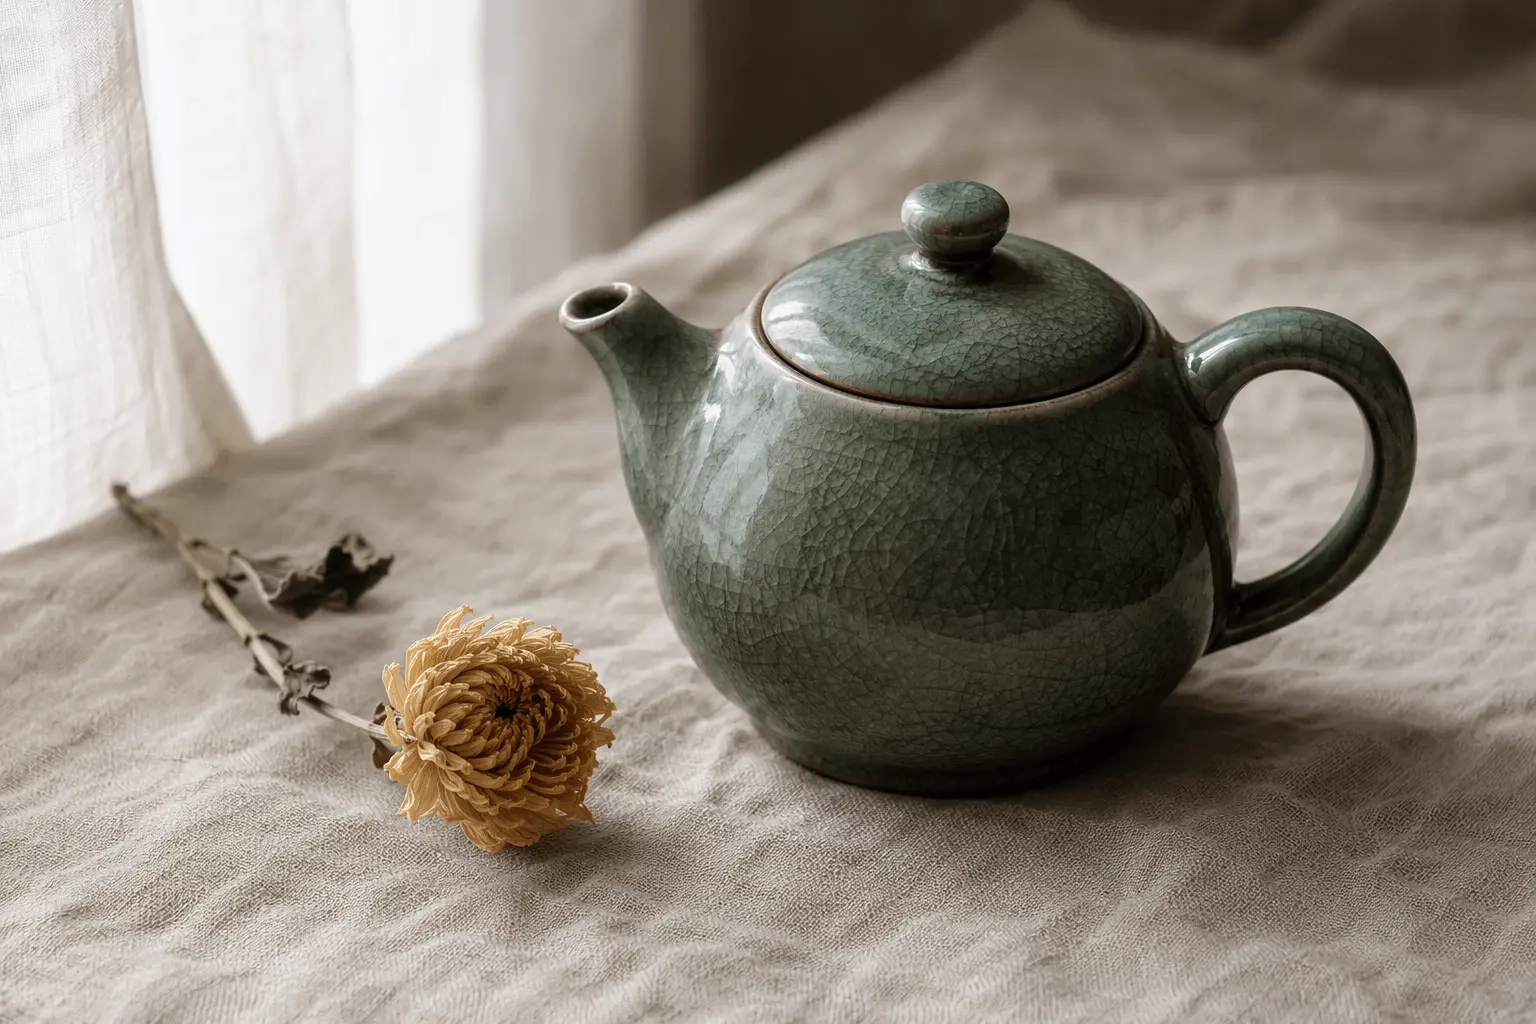
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette",
    "resolution": "1k",
    "num_outputs": 1,
    "aspect_ratio": "1:1"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
認証、完全なスキーマ、ポーリング、エラー処理は API リファレンスを参照してください。