はじめに
映像を video_url、新しい話し声を audio_url に指定します。モデルが口元を音声に合わせて描き直し、元のフレームサイズのまま音声と同じ長さの MP4 を返します。
| 項目 | 値 |
|---|---|
| 入力 | 動画 音声 |
| 出力 | 動画 |
| モデル | VEED Lipsync 2.0 |
| 必須入力 | 話者 1 人の映像( |
| 解像度 | 入力映像と同じ |
| 長さ | 音声に合わせる、最長 5 分 |
| 課金 | 音声の秒数、端数切り上げ |
主な機能とハイライト
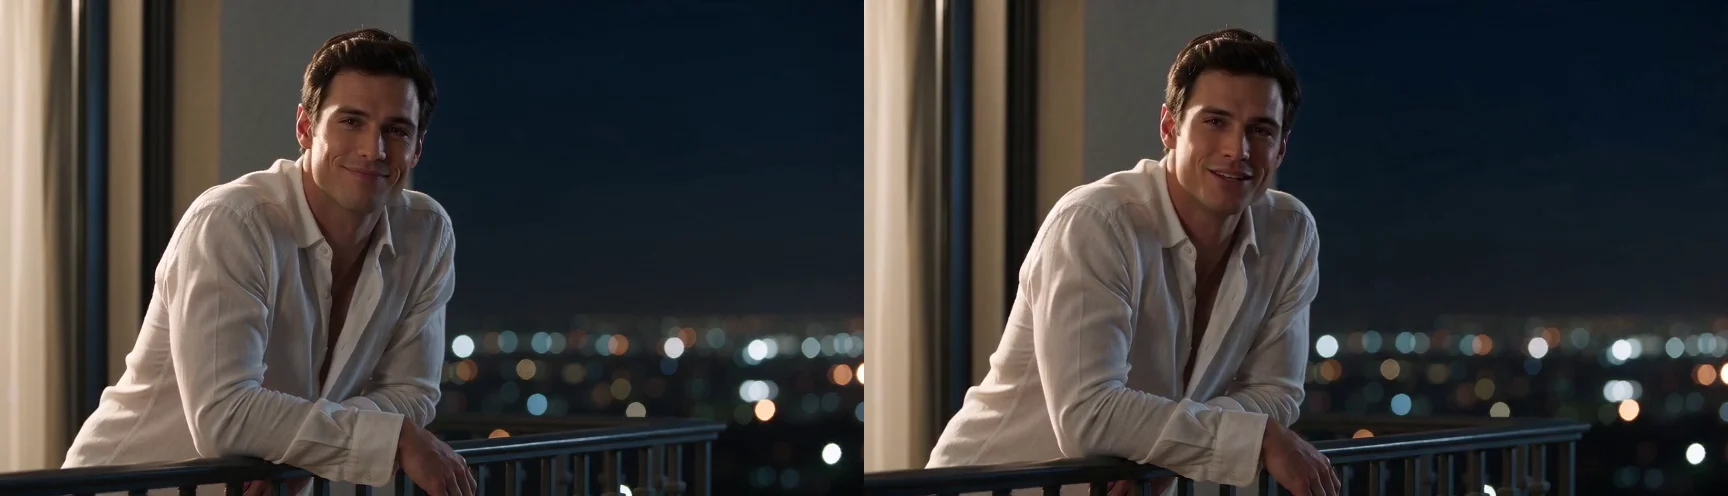
バルコニーのカットに 5 秒のセリフを吹き込み直し
ホテルのバルコニーに立つ白いリネンシャツの男性の 6 秒の映像と、新たに録音したセリフを Lipsync 2.0 に渡しました。口は新しい言葉の形になり、街の灯りやシャツ、半分の笑みは撮影時のままです。結果は 864×496、5.08 秒で、音声の長さに合わせて切られました。
同じ瞬間でも口の形が違います
2 秒地点を並べました。左は元のテイクで、唇を閉じて微笑んでいます。右は結果で、新しいセリフに合わせて口が開いています。シャツや手すり、背景の灯りは変わっていません。
参照に要るのは映像だけです
声のサンプルも顔写真のアップロードも追加学習もありません。音声ファイルを替えれば、同じ映像で別のセリフを話します。
リクエストパラメーター
| パラメーター | 必須 | 説明 |
|---|---|---|
video_url | はい | 必須です。顔が見える話者 1 人の MP4 または WebM を指定します。 1 文字以上 |
audio_url | はい | 必須です。新しい話し声で、最長 5 分です。 1 文字以上 |
料金
$0.084 / 秒
新しい音声の秒数に応じて課金し、端数は 1 秒単位で切り上げます。映像の長さや解像度で料金は変わりません。生成に失敗した場合は課金されません。
ユースケース
撮影後にセリフを直す
撮り終えたテイクの単語、価格、商品名を、出演者を呼び戻さずに差し替えられます。
自然に見える翻訳ナレーション
翻訳した音声トラックを元の映像に載せ、口の動きを新しい言語に合わせます。
生成動画に新しいセリフ
動画生成モデルで作ったキャラクターに、生成時とは別のセリフを話させられます。
プロンプトガイドと実践のヒント
顔がはっきり映ったテイクを選びます
正面向きで明るく、動きの少ない映像が最適です。素早く首を振る、手で口を覆う、髪が唇にかかるといった場面では精度が落ちます。
新しいセリフを用意します
録音する、音声モデルで生成する、翻訳した音声トラックを使う、いずれでも構いません。音楽なしの 1 人の声が理想で、雑音の多い音声は先に整えてください。
2 つのリンクを送ります
映像を
video_url、話し声をaudio_urlに指定します。完成した動画は元の映像と同じ解像度で返ります。
はじめに
VEED Lipsync 2.0 は、画面の人物が話しているように見える内容を差し替えるモデルです。video_url に映像、audio_url に新しい話し声を渡すと、口元が音声に合わせて描き直されます。
主な機能と特長
手元のテイクにそのまま使えます
背景や服装、表情は撮影時のまま残り、描き直すのは口の周りだけです。
入力と同じ解像度で返します
出力は入力映像のフレームサイズを保ち、料金は解像度に左右されません。
長さを決めるのは音声です
音声が短ければ映像を切り、長ければ映像を延ばして合わせます。当方のテストでは、結果の長さは音声と 100 分の数秒の差に収まりました。
活用シーン
撮り直しなしのセリフ修正
収録済みのプレゼンター映像で、名前や日付、キャンペーン内容を直せます。
声の差し替え
翻訳した音声や録り直した音声を、元の演技にそのまま載せられます。
入力のガイドとコツ
話者は 1 人、顔はカメラ向きに
対応は 1 本につき話者 1 人です。顔が見える状態を保ち、素早く首を振る場面は避けてください。
音声はクリアに
音楽や雑音のない 1 人の声を使い、雑音の多い録音は先に整えてください。
テンポを合わせます
新しいセリフを元の長さに近づけると、体の動きが自然に見えます。
API クイックスタート
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "veed/lipsync-2.0/lip-sync",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "video_url": "https://example.com/reference.mp4"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
認証、完全なスキーマ、ポーリング、エラー処理は API リファレンスを参照してください。