はじめに
スタイル用のウェイトを画像編集に適用します。<Picture 1> が元画像で、それ以降のトークンは補助となる参照画像を示します。
| 項目 | 値 |
|---|---|
| 入力 | 画像 |
| 出力 | 画像 |
| 対応する処理 | text-to-image の生成と image-to-image の編集による静止画です。 |
| 基になるモデル | LoRA を添付できる MiniMax H3-Image の公開ウェイトです。 |
| LoRA の添付上限 | 直接取得する .safetensors の URL を最大 3 つ使えます。 |
| LoRA の強さ | ファイルごとに 0–4、既定値は 1 です。 |
| プロンプトの長さ | 必須で、最大 5,000 文字です。 |
| 解像度の選択肢 | 1k、1.5k、2k、3k、4k。既定値は 1k です。 |
| 画面の形 | 15 種類の比率で、文章からの生成の既定は 1:1 です。 |
| 編集用画像 | 1–9 枚で、元画像に続けて最大 8 枚を参照にします。 |
| 参照の書き方 | アップロード順に <Picture 1>、<Picture 2> 以降を使います。 |
| 出力のエンコード | 既定の jpeg のほか png、webp を選べます。 |
| 比較用設定 | 任意の seed が変更比較を助けますが、出力一致は約束しません。 |
| 出力寸法の検証値 | 1.5k・9:16 は 1152 x 2048、4k・16:9 は 5472 x 3072 でした。 |
主な機能とハイライト
ネオンの光をカムコーダー風に
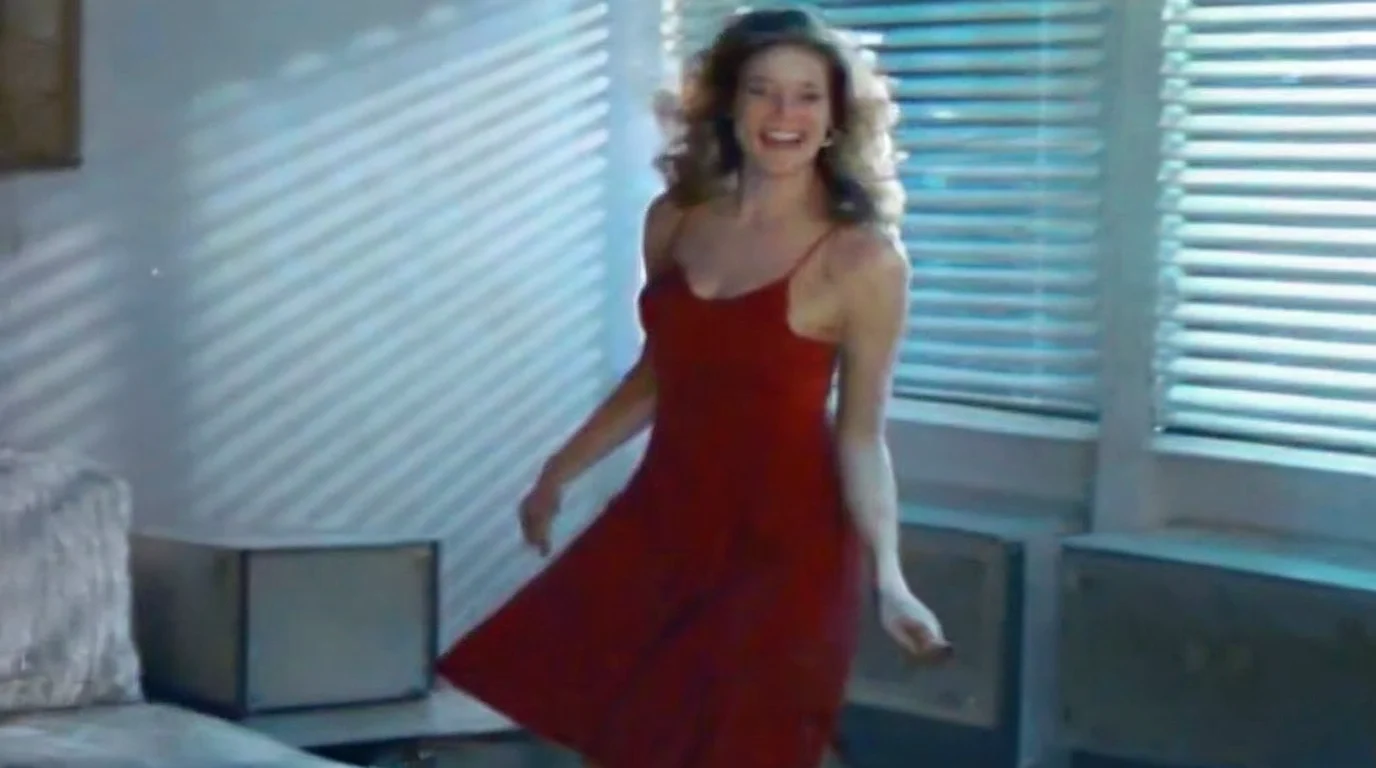
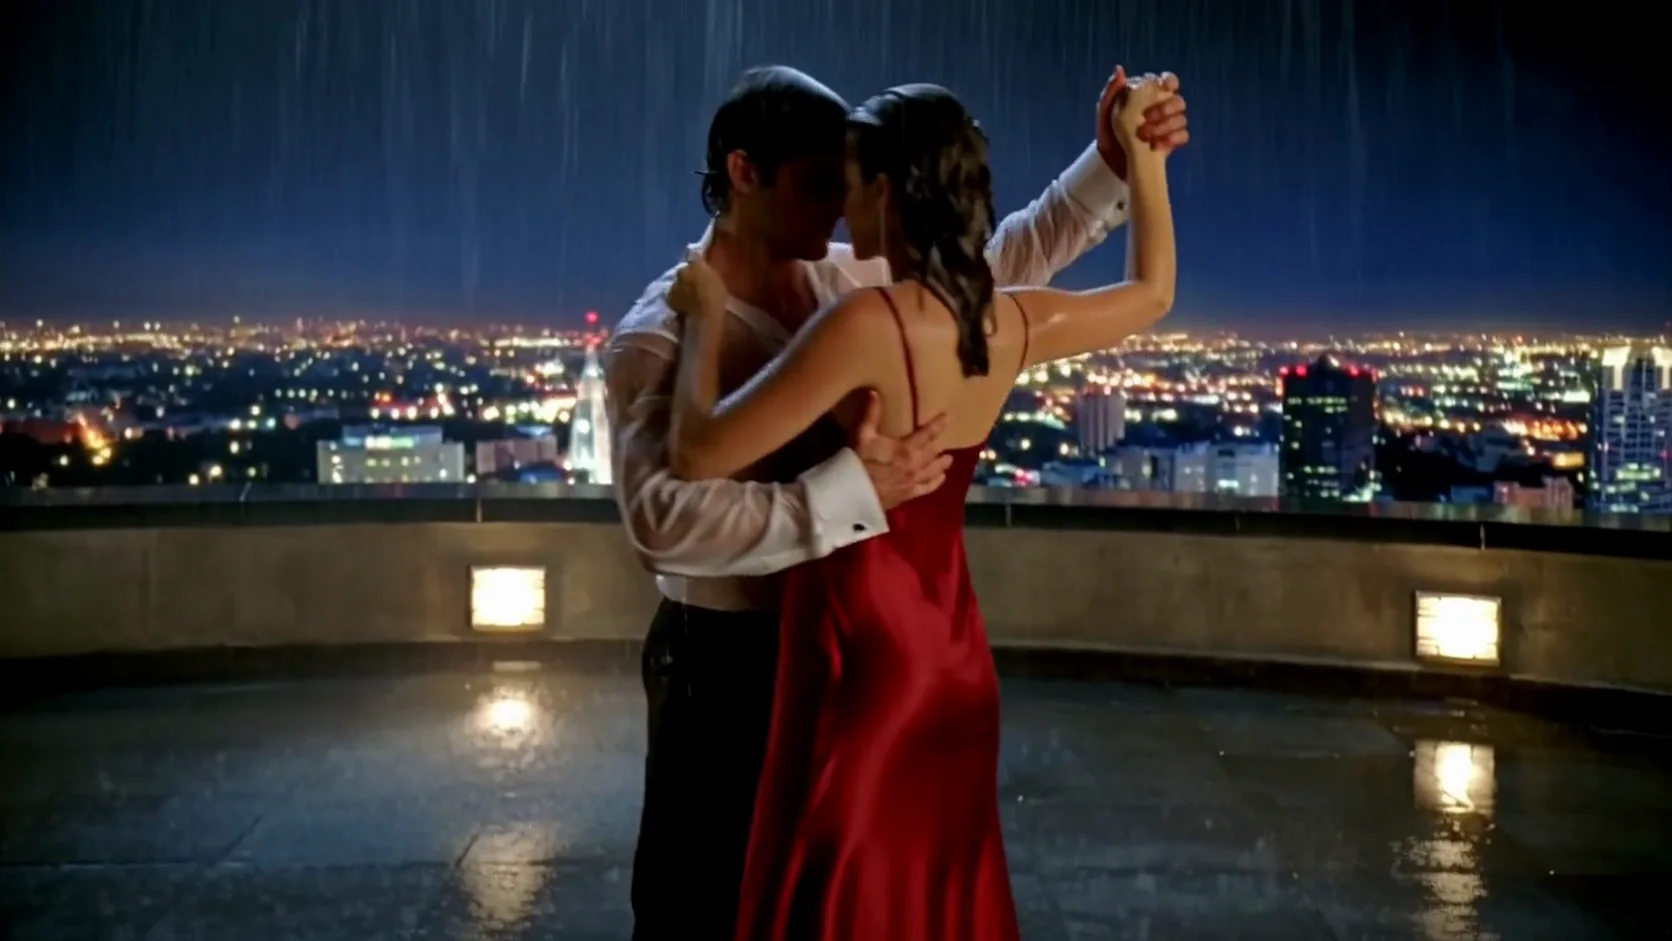
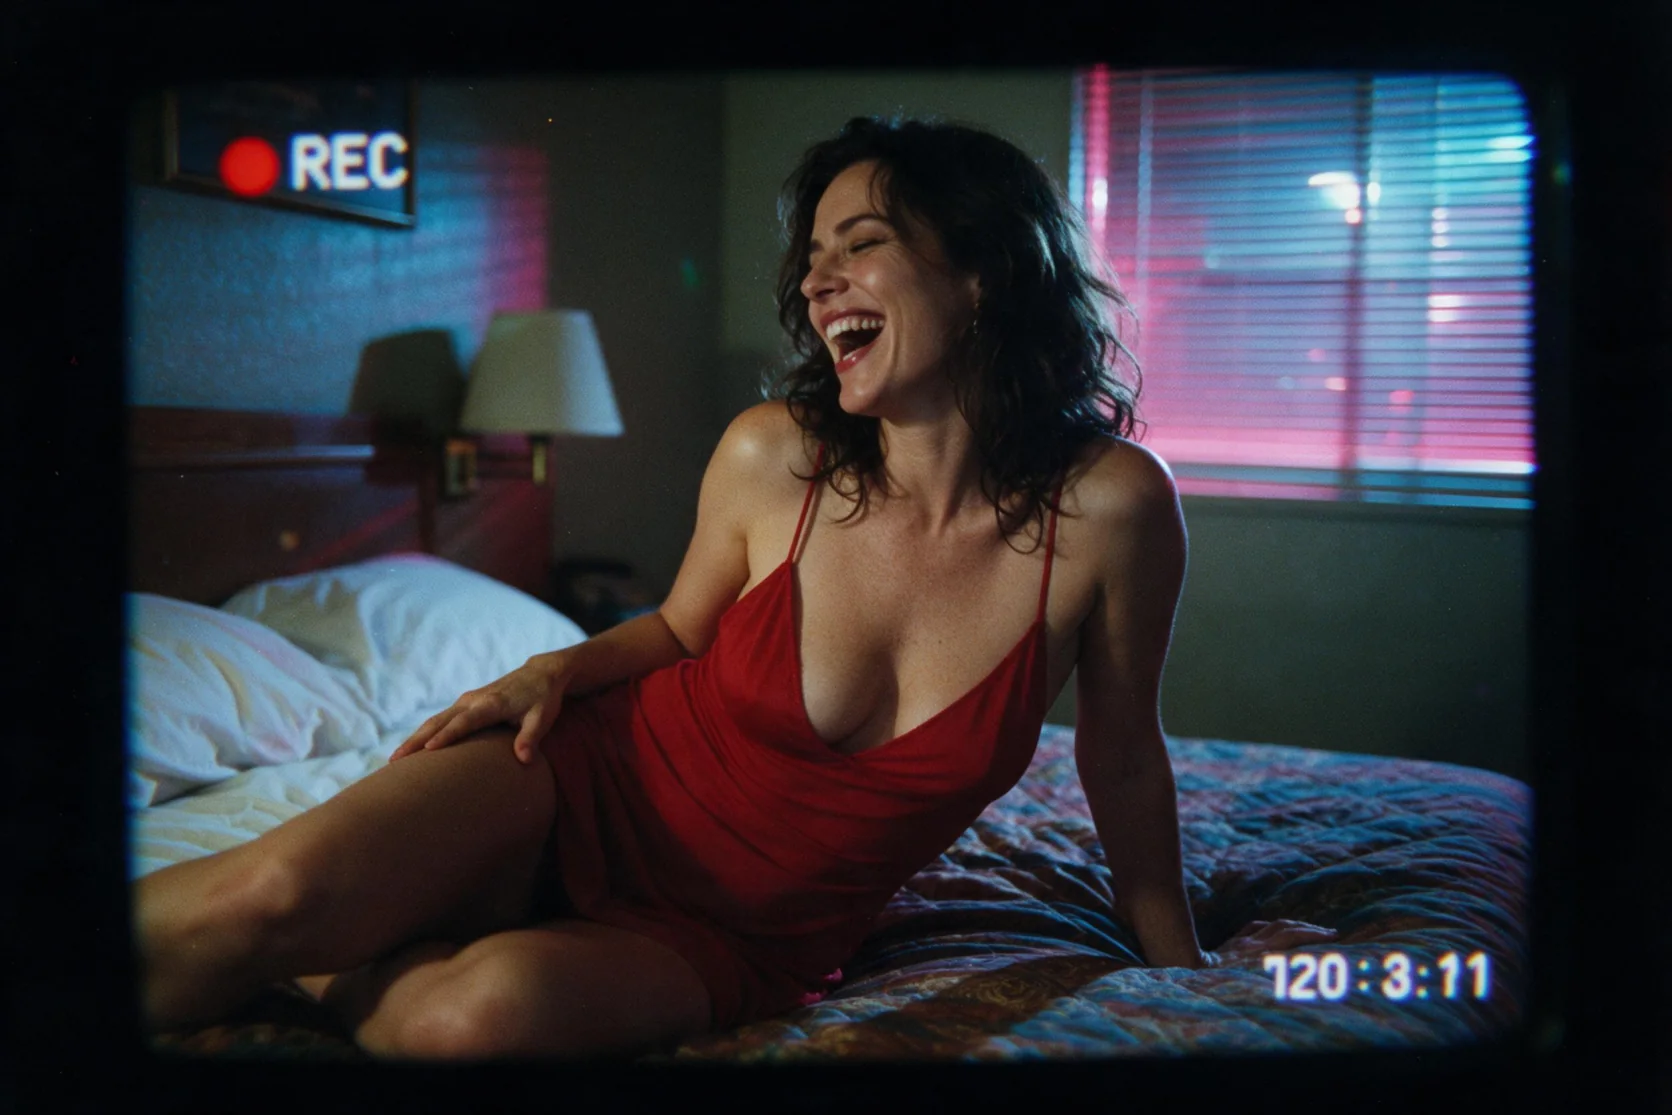
新しい 1k、16:9 のサンプルは、赤いスリップドレスの女性が夜のモーテルで踊る場面です。vh5tape と scale 1 の VHS LoRA によって、全体が柔らかな 1990 年代のホームビデオ風になりました。
テープ表現が独自の文字を伴うことも
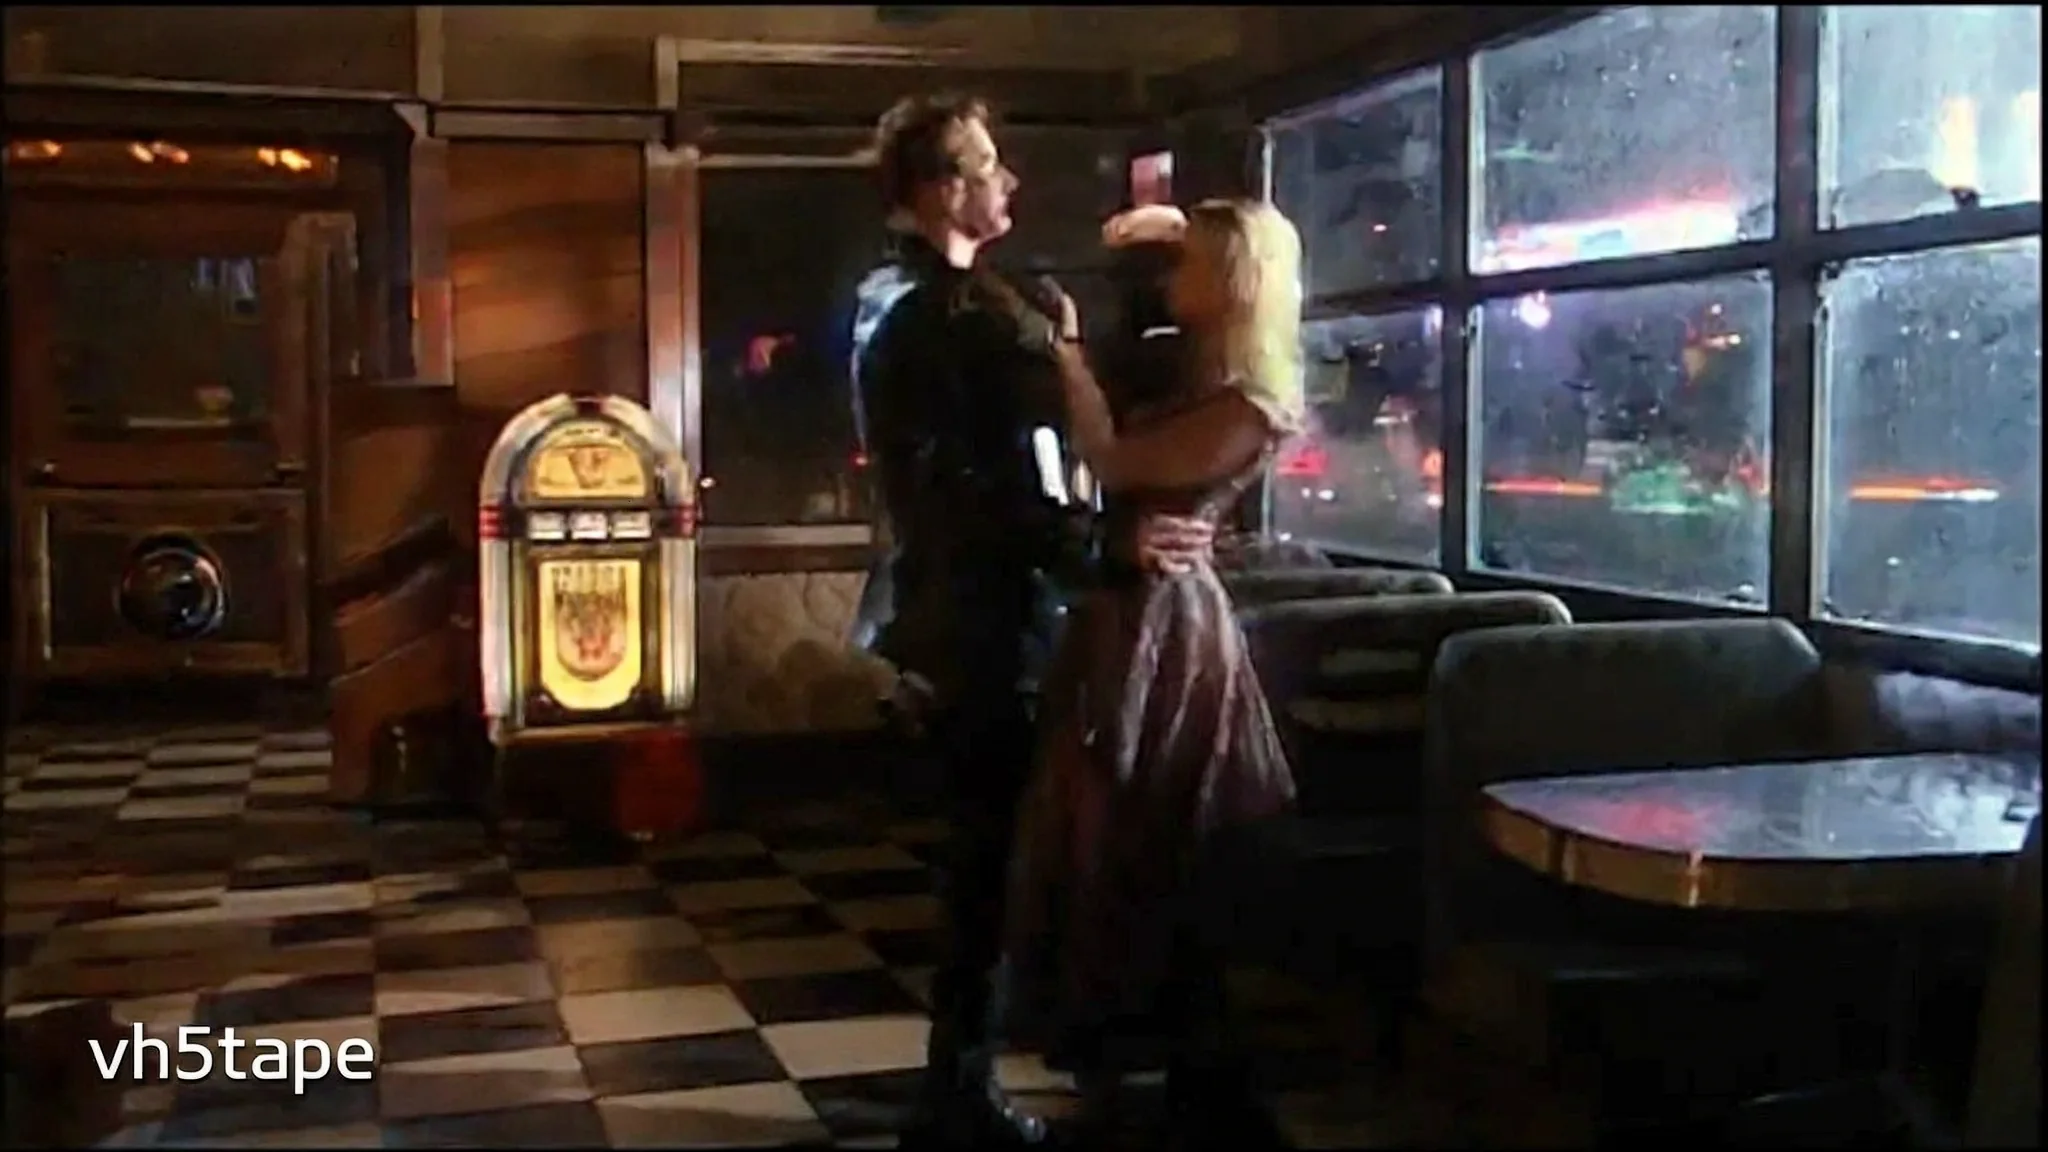
ダイナーのダンスには録画の粒子感と左下の vh5tape がありました。出力を選ぶ前に意図したスタイルだけでなく文字も確認すべき、目に見えるアーティファクトです。
柔らかな録画表現のレースゲーム
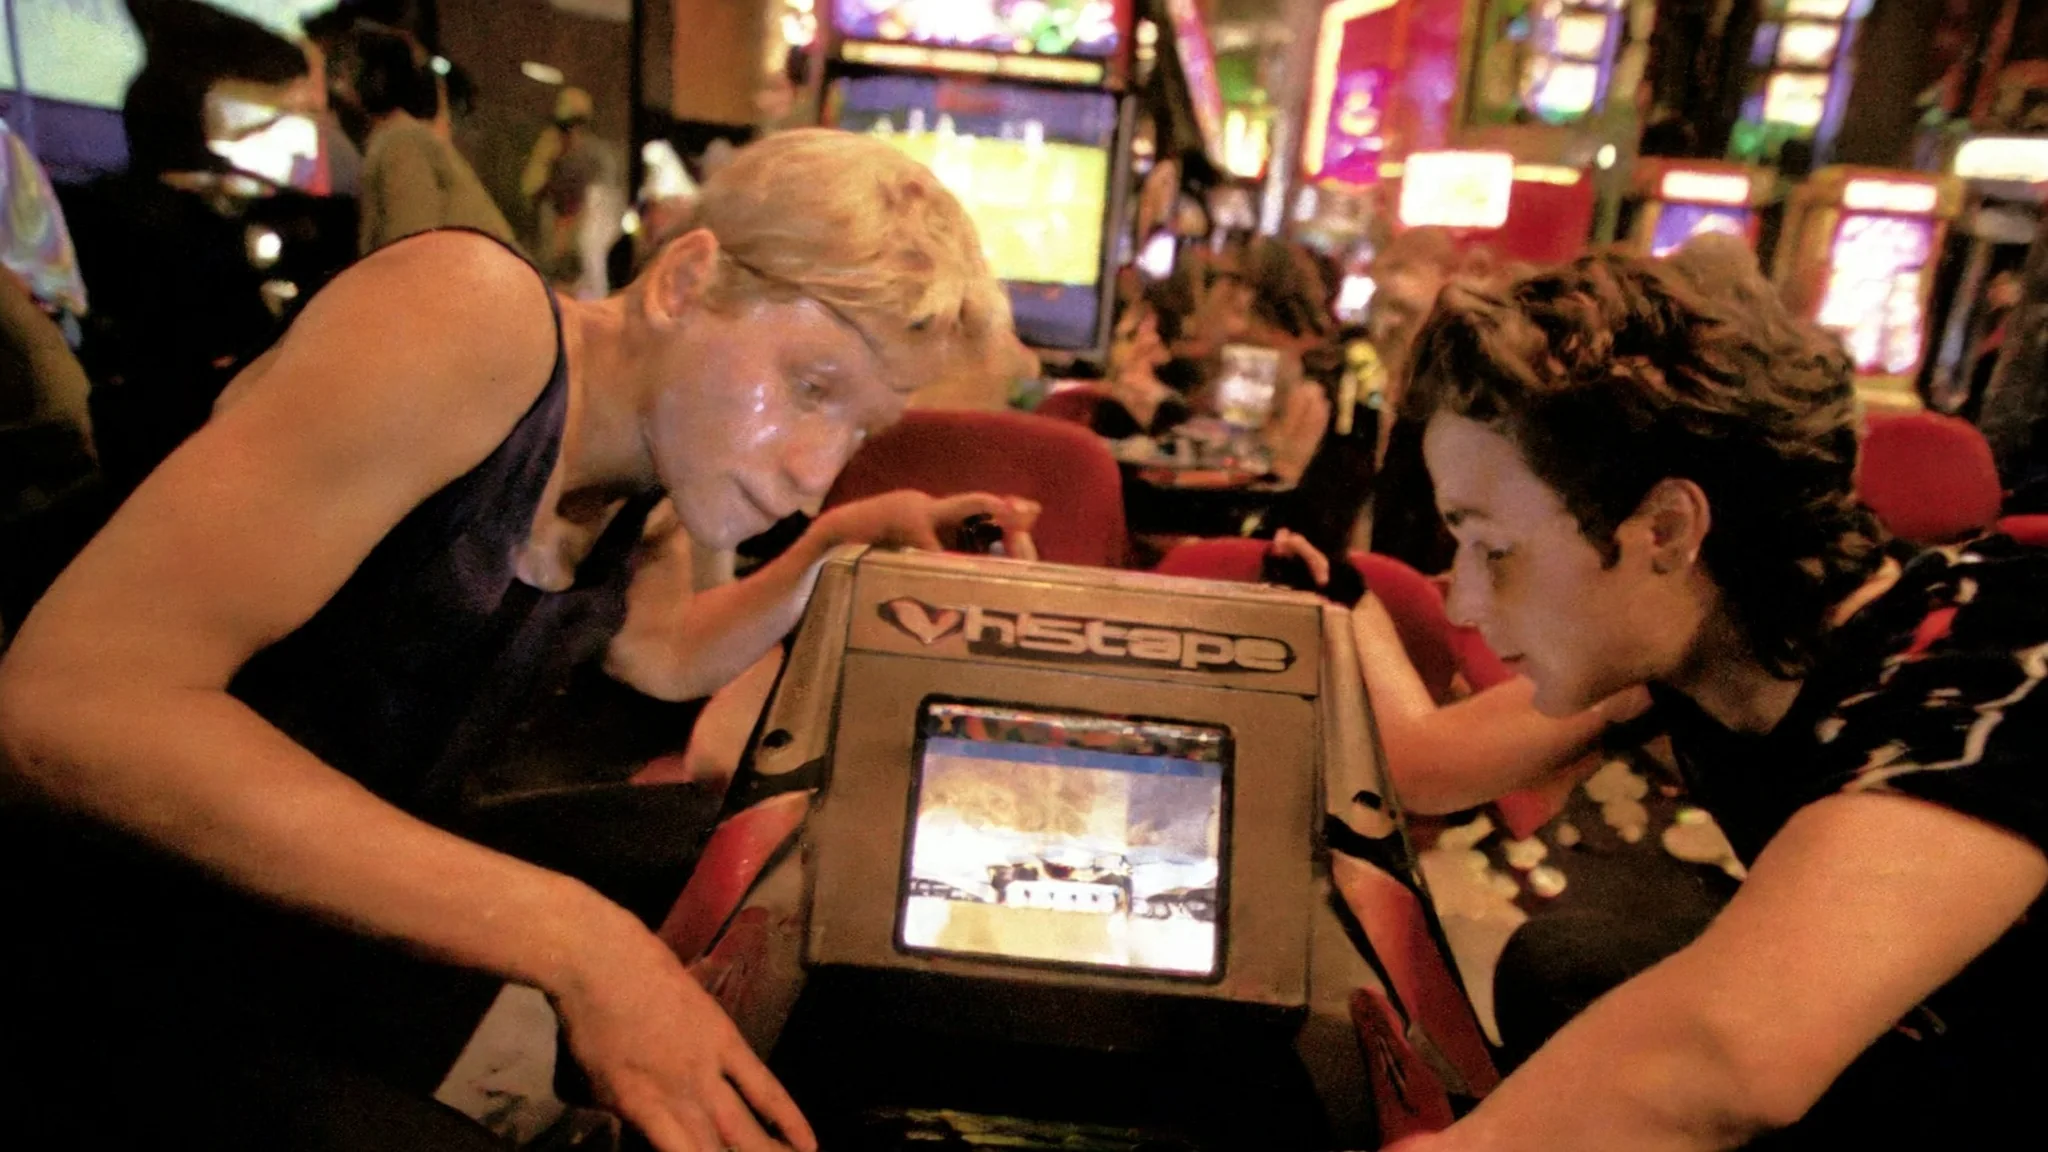
アーケードの例はネオンの中の 2 人のプレイヤーに VHS を適用しています。人物や周囲をアダプターがどう変えるか、別の場面でも評価できます。
港を違う描画表現に
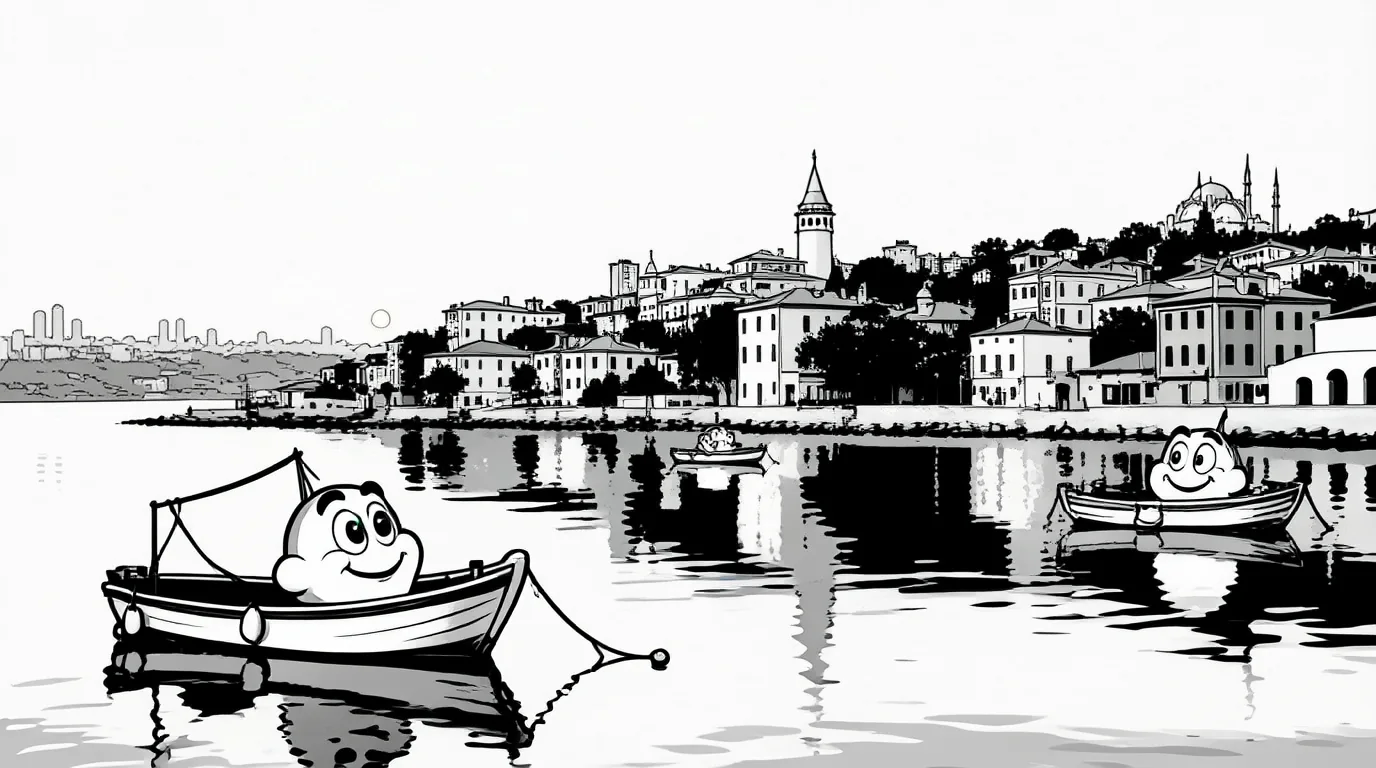
Studio1939 style の編集は、港を白黒のラバーホース風の船で描き直しました。この例では街並みの配置を認識できました。
リクエストパラメーター
| パラメーター | 必須 | 説明 |
|---|---|---|
prompt | はい | LoRA トリガーワードから始まる 5,000 文字以内の編集指示が必須です。入力画像は で指定します。 1 文字以上 · 5000 文字以内 |
image_urls | はい | 必須の編集対象を先頭に、1〜9 個の画像 URL を指定します。それ以降は参照画像となり、最初の画像の編集料金に 1 枚ずつ少額が加算されます。 1 件以上 · 9 件以内 |
aspect_ratio | いいえ | 編集の比率は 1:1、1:2、2:1、1:3、3:1、2:3、3:2、3:4、4:3、4:5、5:4、9:16、16:9、9:21、21:9 です。未設定なら最初の画像に従います。 |
resolution | いいえ | スタイル付き編集では 1k(既定)・1.5k・2k・3k・4k を選びます。出力のサイズ段階が大きくなるほど料金も上がります。 |
loras | いいえ | 編集には最大 3 個の {path, scale} を指定でき、添付なしでも使えます。Hugging Face の /resolve/main/ など、.safetensors 本体の直接 URL を指定してください。 デフォルト値: |
output_format | いいえ | 編集結果は既定で jpeg です。同じ段階の料金で png または webp にも変更できます。 |
seed | いいえ | 編集表現を比較するとき、乱数の生成元を任意で固定できます。固定の既定値や数値範囲の記載はありません。 |
料金
スタイル付き編集の料金は、公開ウェイト版のサイズ段階の料金と画像ごとの固定 LoRA 加算額です。ファイルが 0 個・1 個・3 個でも加算額は一定です。2 枚目以降の入力はそれぞれ有料で、読み込みエラーなどで失敗した場合は課金されません。
| 仕様 | 料金 |
|---|---|
| $0.042 / 枚 |
| $0.06 / 枚 |
| $0.078 / 枚 |
| $0.15 / 枚 |
| $0.222 / 枚 |
ユースケース
ネオンのモーテルの場面研究
赤いドレスのモーテル例は scale 1 の VHS LoRA で、夜のダンスを柔らかなカムコーダー風静止画にしました。テープ時代のムードボード用に、画面全体の表現を参考にできます。
既存写真のスタイルを変更
1930 年代カートゥーンの LoRA はポーズを残し、写真をラバーホース風にしました。港の関連例では街並みの配置が保たれています。
大きなサイズに進む前の比較
seed と場面説明を固定して LoRA を切り替えます。VHS の比較は質感と構図が変わったため、大きな解像度を選ぶ前に両方を評価します。
ポートレートの場所を見直す
単一画像の服装・場所変更はテストで顔を保ちました。LoRA の表現は別に比較し、人物と周囲への影響を確かめます。
元画像と場面参照を合わせる
2 枚の合成はテストで成功しました。スタイル付きの合成を計画するなら、元画像を場面参照より先に置き、指示で各画像を指定します。
プロンプトガイドと実践のヒント
生成または編集を選択
生成は文章の場面から始め、編集は修正する写真を参照より先に渡します。編集の入力は最大 9 枚です。
取得できる LoRA を添付
path は .safetensors 本体に向け、必要に応じて Hugging Face の /resolve/main/ を使います。scale 1 から始め、ファイルごとに 0–4 を設定できます。1 回に最大 3 ファイルです。
場面と表現を説明
選んだ LoRA のトリガーを先頭に置き、服装、動作、光、周囲の詳しい英語を続けます。編集では元を <Picture 1>、後の参照を各番号で指定します。
比較して画面を点検
比率、解像度、形式を選び、seed を固定して LoRA の有無を比較します。スタイル、構図、不要な文字を確認してください。seed を固定しても出力の一致を確約するものではありません。
LoRA のウェイトで元画像を描き直す
写真などの既存画像から始める場合は、この MiniMax H3-Image Open Weights LoRA を使います。元画像、任意の参照、指示、最大 3 つのウェイトを組み合わせ、1930 年代カートゥーンのように検証した表現を加えながら場面を変更できます。
順序が重要で、<Picture 1> が編集する画像です。その後の参照が人物、物、場所を供給します。prompt で役割を決め、変更と保持を明確にしてください。人物は使用権のある成人の写真を使い、なりすましをしません。
編集パラメータ
| パラメータ | 対応値と役割 |
|---|---|
image_urls | 元画像と最大 8 枚の参照で、1–9 枚です |
prompt | 必須、最大 5,000 文字で、<Picture N> により指定します |
loras | 最大 3 つの {path, scale} で、各ファイルに直接取得できる .safetensors URL を使います |
loras[].scale | 個別に 0–4、既定値 1 です |
aspect_ratio | 1:1, 1:2, 2:1, 1:3, 3:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 9:21, 21:9。省略時は元画像に従います |
resolution | 1k, 1.5k, 2k, 3k, 4k。開始値は 1k です |
output_format | png、webp を選ばなければ jpeg です |
seed | 変更 1 つの比較に使う任意の乱数源です |
比率と段階は役割が違います。比率未指定では元の形に従い、段階でサイズと価格を選びます。公開ウェイト版の 4k、16:9 は 5472 x 3072 でした。名称だけで幅は一定になりません。
元画像の役割を中心に指示する
トリガーから始め、描き直すものと残すものを指定します。港なら Studio1939 style の後で、<Picture 1> を白黒のラバーホース風にし、笑顔の船や丸い輪郭を描き、街並みの配置を維持する、と書けます。句だけに頼らず、対応ファイルを loras に渡します。
補助画像を加える
場所変更なら、<Picture 1> の 40 代女性を <Picture 2> のラウンジへ置き、紺のドレスで暖かなランプの横に立たせ、顔を認識できるよう保つ、と両方を名指しします。対応ウェイトを添付すれば VHS トリガーも先頭に置けます。これは提案で、その場面を検証済みとするものではありません。
変更と保持の目標は分けます。
- 人物や物をどの写真から取るか指定します。
- 新しい衣服、周囲、光を説明します。
- 顔、ポーズ、配置のうち認識できる状態を残すものを示します。
- 結果を元画像と照合します。
編集からの根拠
H3 動画用のカートゥーン LoRA がこの画像チェックポイントでも機能しました。写真のポーズを保って 1930 年代のラバーホース風になり、港の例でも街並みの配置を残しつつ港や船を白黒に描き直しました。
別の H3-Image 編集では服装・場所を変えて顔を保ち、2 枚の合成でも被写体を別の場面に置けました。参照編集を試す根拠ですが、アダプターがすべての人物や配置を維持する証拠ではありません。VHS の有無でも構図が変わったため、固定 seed は比較の補助です。
ファイル、アーティファクト、対処
Hugging Face の /resolve/main/ は .safetensors 本体で終わる URL にします。各項目は独自の scale を持ち、1 から始めます。混合を評価する前に 1 ファイルを確認し、scale の調整中は prompt、元画像順、seed を固定します。
壊れたリンクは Failed to load LoRA となり、画像も課金もありませんでした。意図するファイルが取得できるか確かめ、リンクを修正して再試行します。失敗時に無加工画像へ黙って置き換わることはありません。VHS のダイナーには隅に vh5tape が出たため、編集でも学習由来の文字を確認します。
料金と別のエンドポイント
完成編集は解像度段階の料金に固定の LoRA 加算を足します。最初の元画像以降の参照にも料金がかかります。0、1、3 個の LoRA で加算額は同じで、jpeg から png や webp に変えても価格は変わりません。モデルページ に現行価格があり、失敗は無料です。
アダプターなしで seed と 5 段階を使うなら Open Weights を選びます。10–16 枚が必要なら MiniMax H3-Image が最大 16 枚に対応しますが、比率の動作と 3 段階メニューが異なり seed はありません。元画像なしなら同ファミリーの text-to-image、旧 H3 Image LoRA は動画モデルによる単一フレームとして別に評価します。
コンテンツの記録にも限界があります。拒否なく返りましたが、標準テストの Very strong 編集は毎回控えめでした。返却されたことが全指示に従ったことを意味しません。
API クイックスタート
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "minimax/h3-image-open-lora/edit",
  "input": {
    "image_urls": [
      "https://example.com/reference.png"
    ],
    "output_format": "jpeg",
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette",
    "resolution": "1k"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
認証、完全なスキーマ、ポーリング、エラー処理は API リファレンスを参照してください。