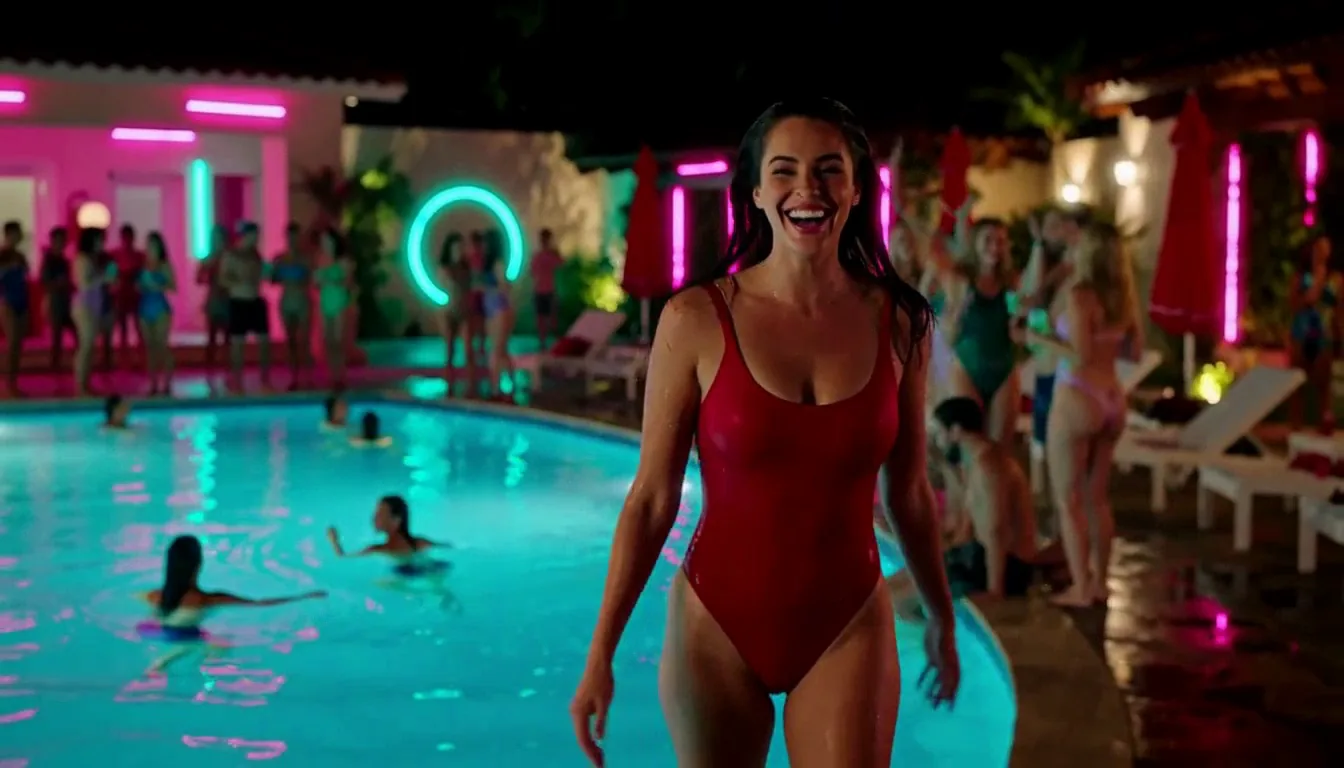
はじめに
文章の説明、ウェイト本体の直接 URL、各スケールで表現を指定します。任意の seed を使うと、追加したファイルの効果を検討できます。
| 項目 | 値 |
|---|---|
| 入力 | テキスト |
| 出力 | 画像 |
| 対応する処理 | text-to-image の生成と image-to-image の編集による静止画です。 |
| 基になるモデル | LoRA を添付できる MiniMax H3-Image の公開ウェイトです。 |
| LoRA の添付上限 | 直接取得する .safetensors の URL を最大 3 つ使えます。 |
| LoRA の強さ | ファイルごとに 0–4、既定値は 1 です。 |
| プロンプトの長さ | 必須で、最大 5,000 文字です。 |
| 解像度の選択肢 | 1k、1.5k、2k、3k、4k。既定値は 1k です。 |
| 画面の形 | 15 種類の比率で、文章からの生成の既定は 1:1 です。 |
| 編集用画像 | 1–9 枚で、元画像に続けて最大 8 枚を参照にします。 |
| 参照の書き方 | アップロード順に <Picture 1>、<Picture 2> 以降を使います。 |
| 出力のエンコード | 既定の jpeg のほか png、webp を選べます。 |
| 比較用設定 | 任意の seed が変更比較を助けますが、出力一致は約束しません。 |
| 出力寸法の検証値 | 1.5k・9:16 は 1152 x 2048、4k・16:9 は 5472 x 3072 でした。 |
主な機能とハイライト
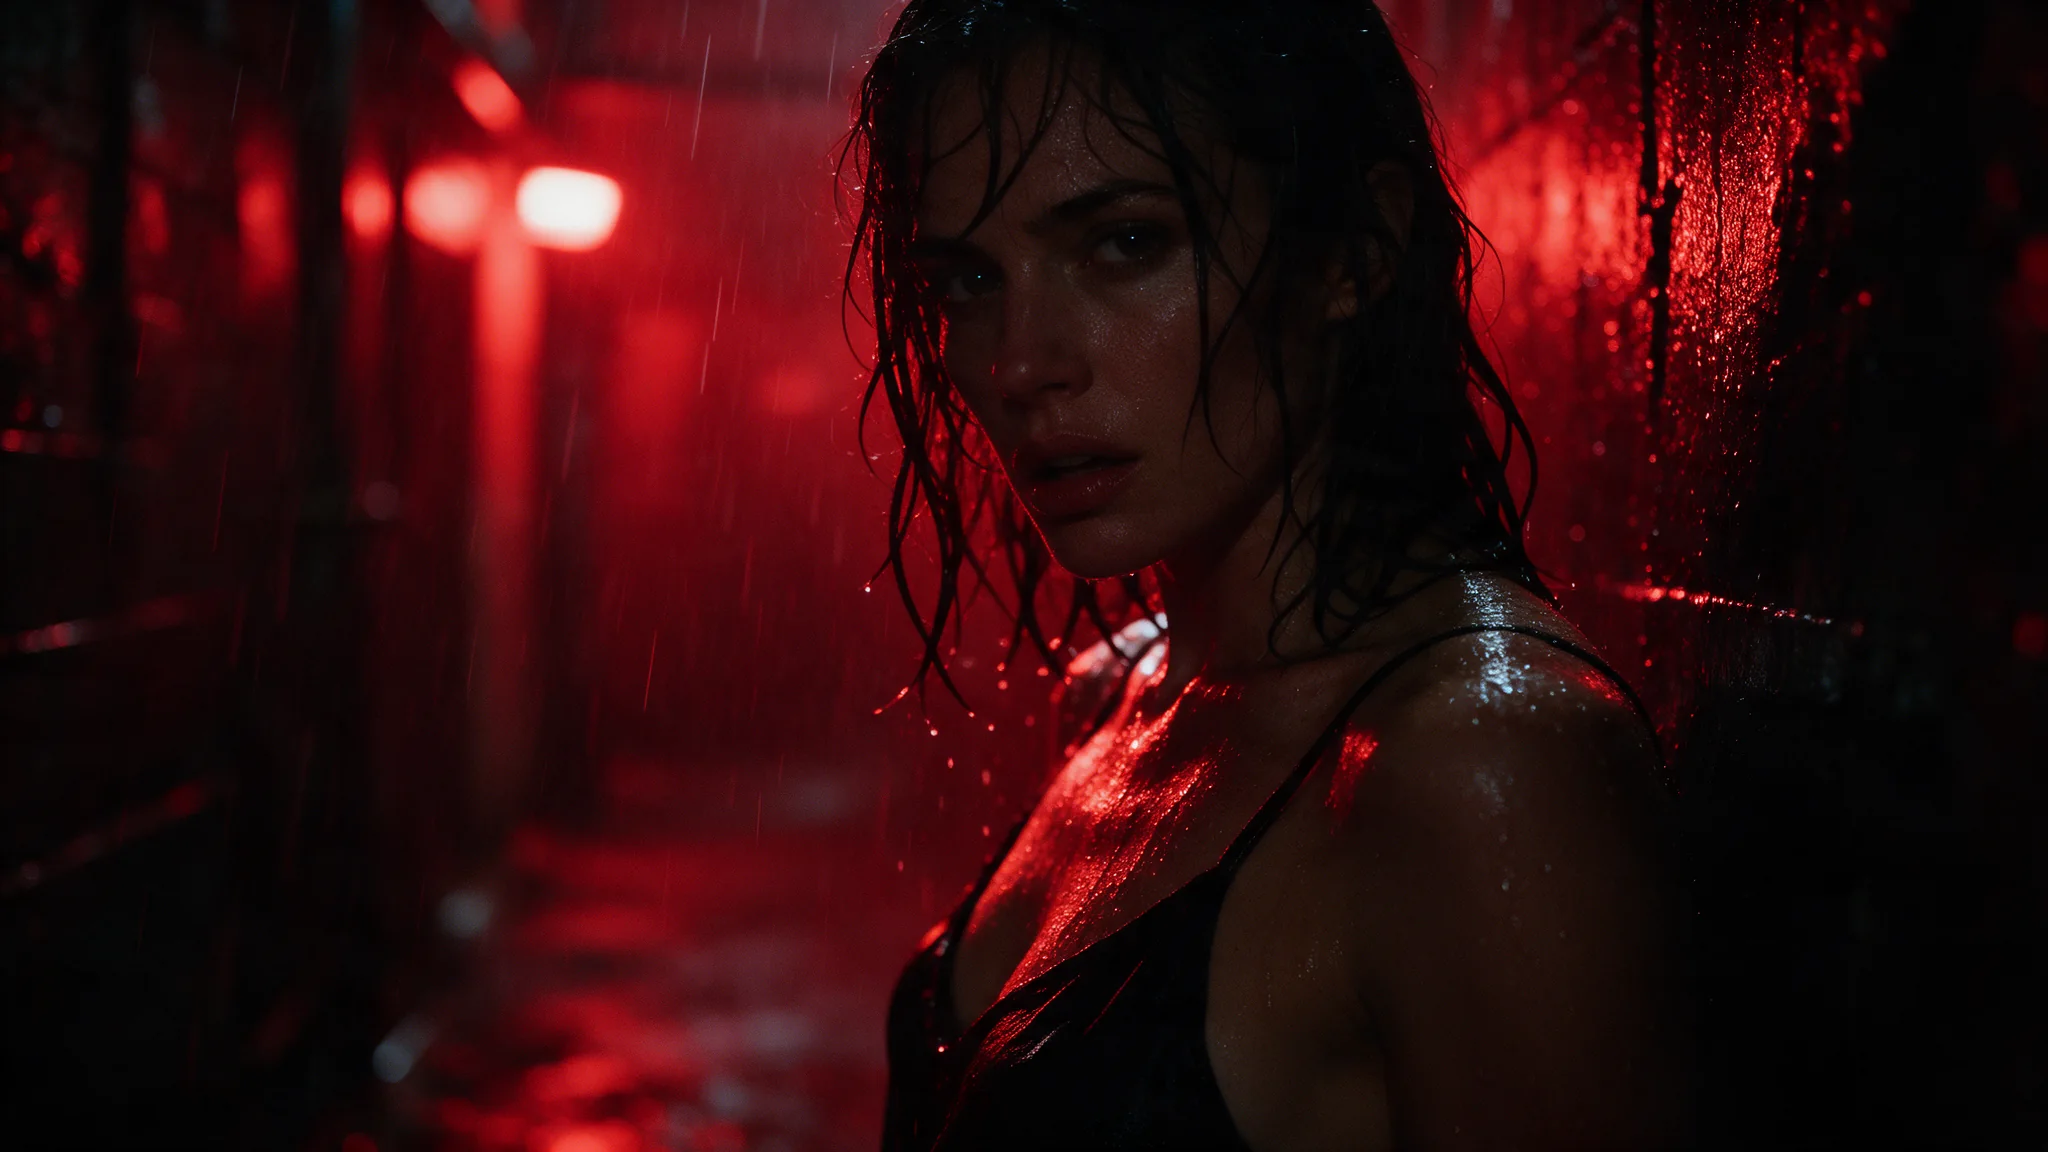
ネオンの光をカムコーダー風に
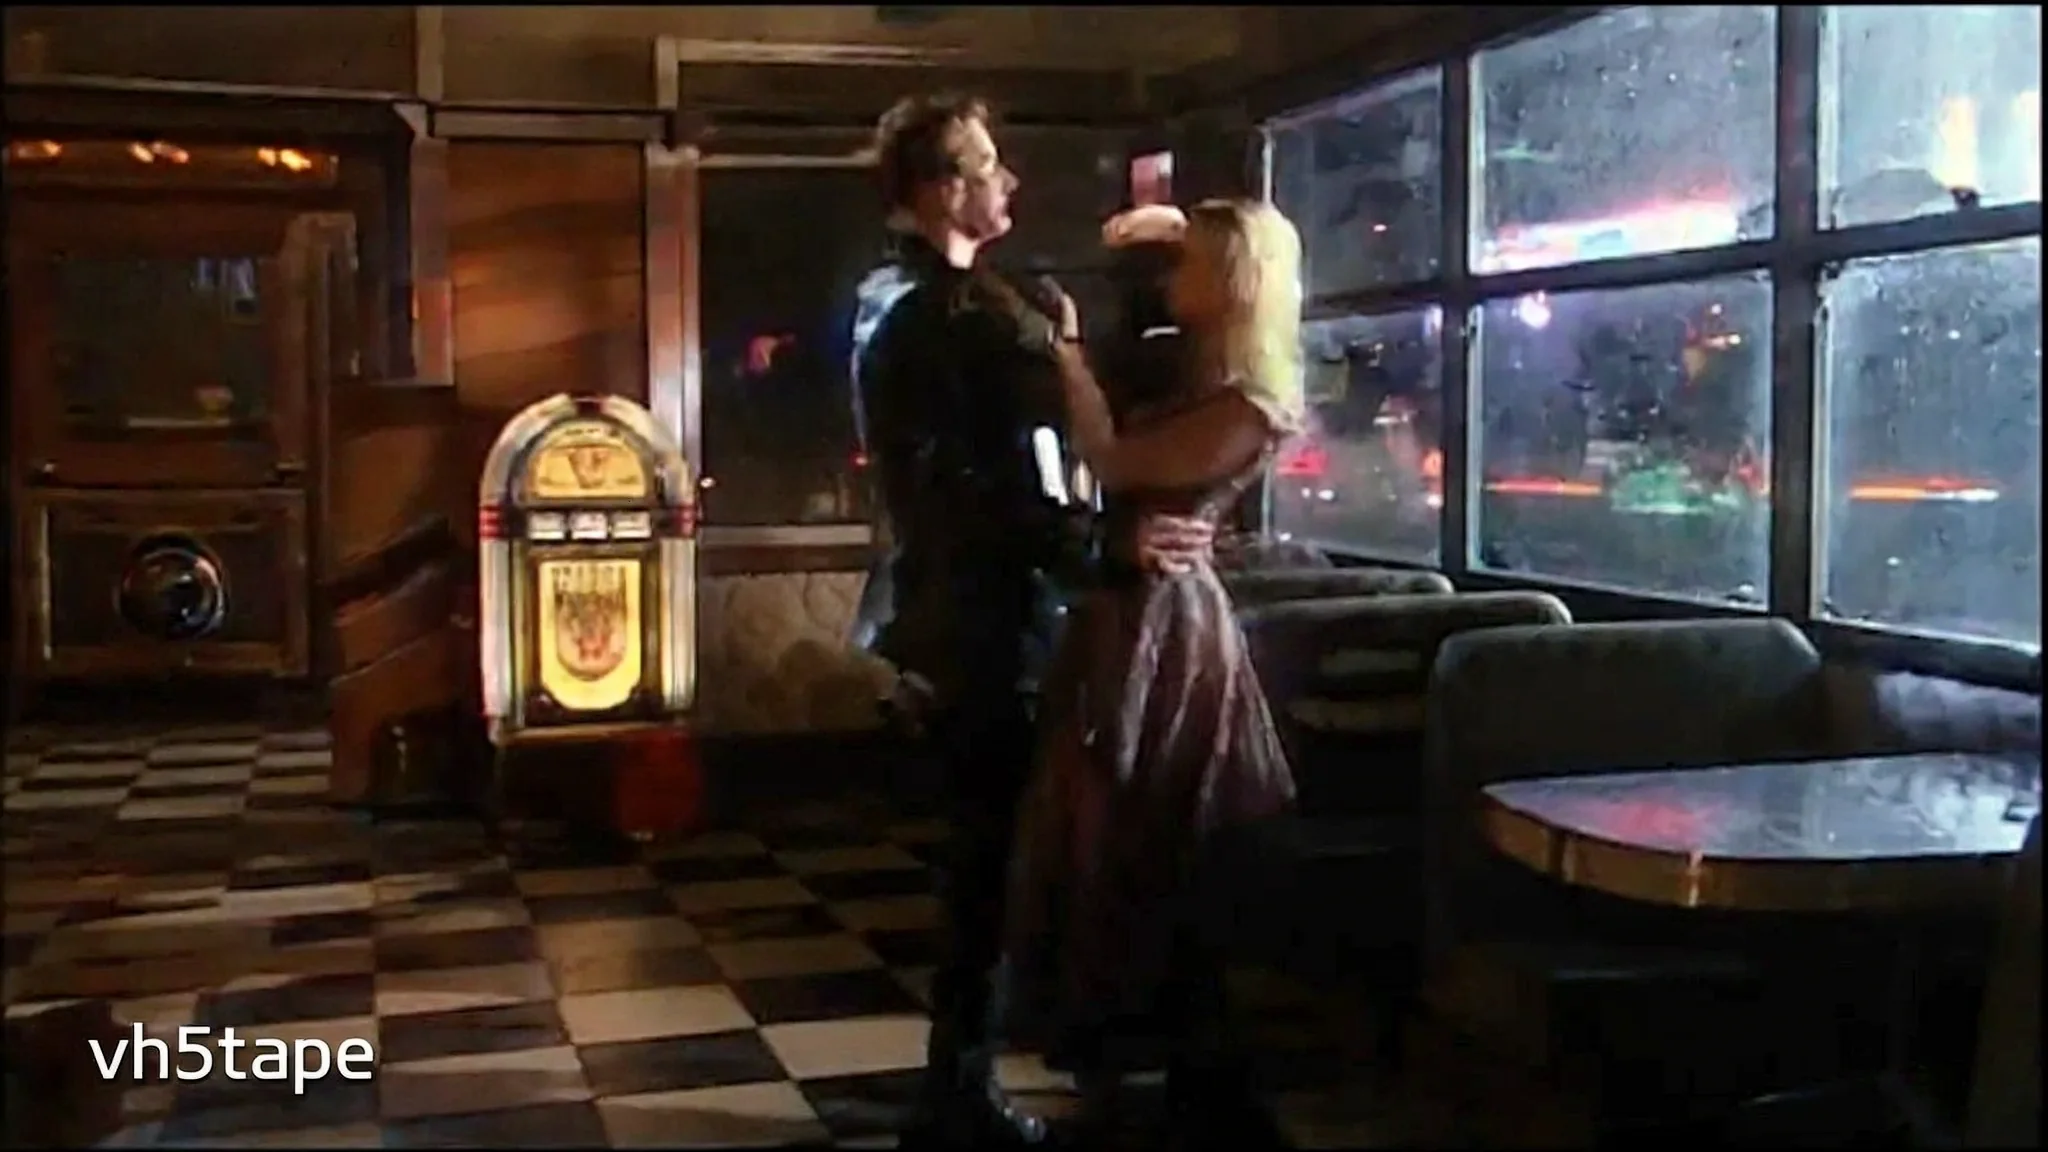
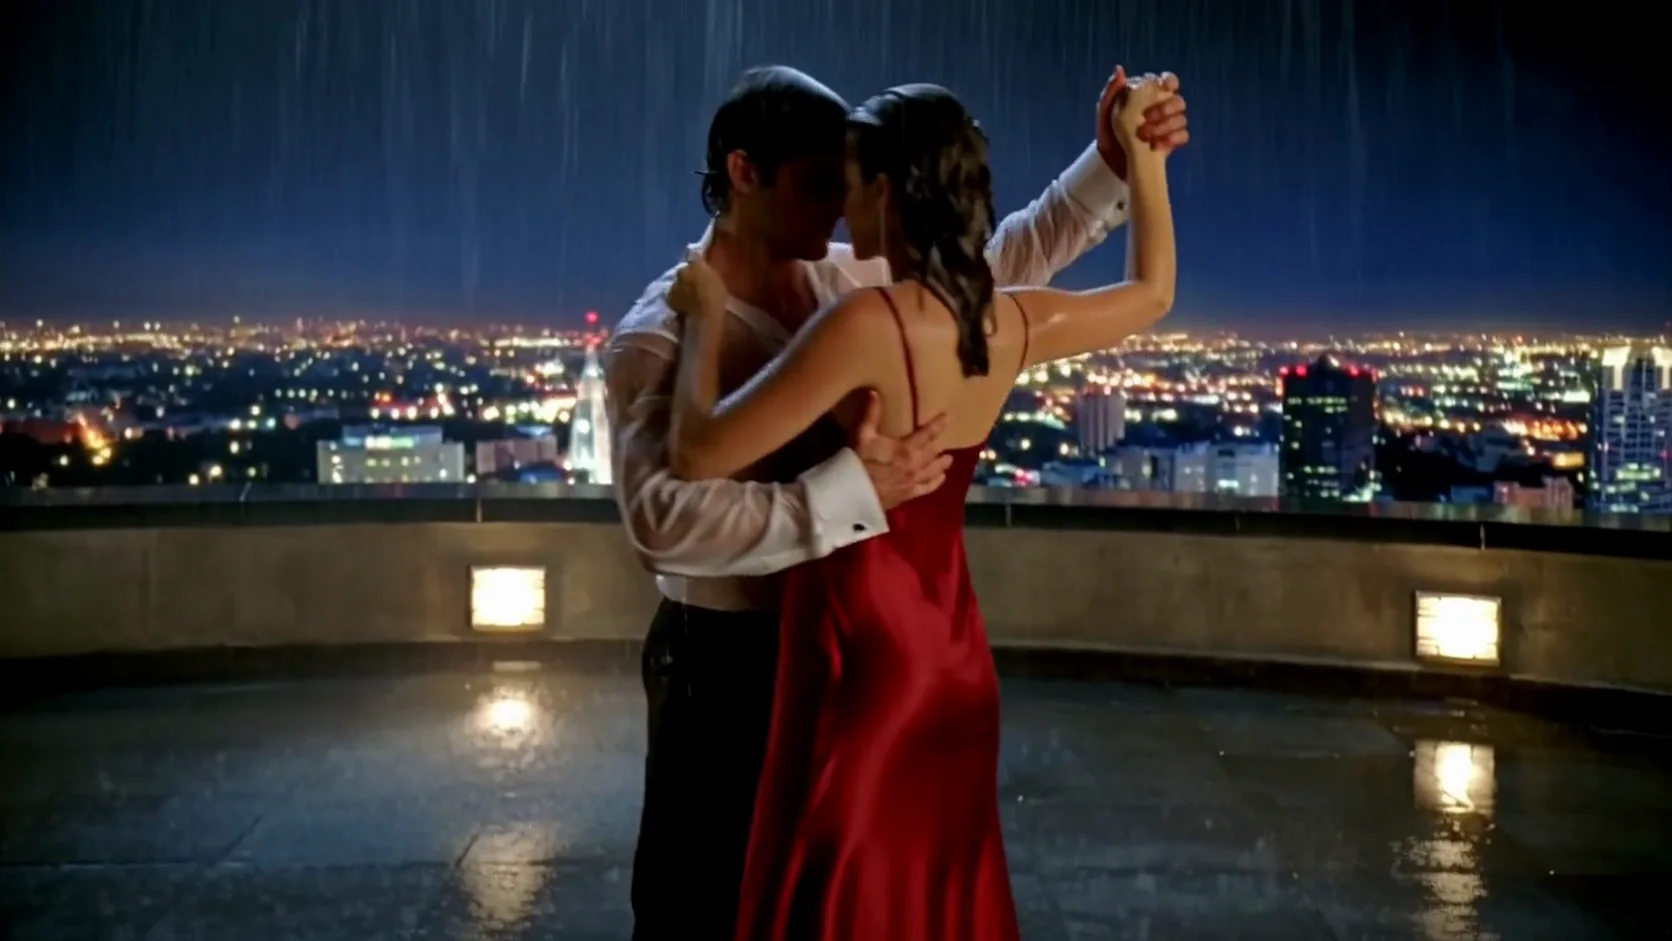
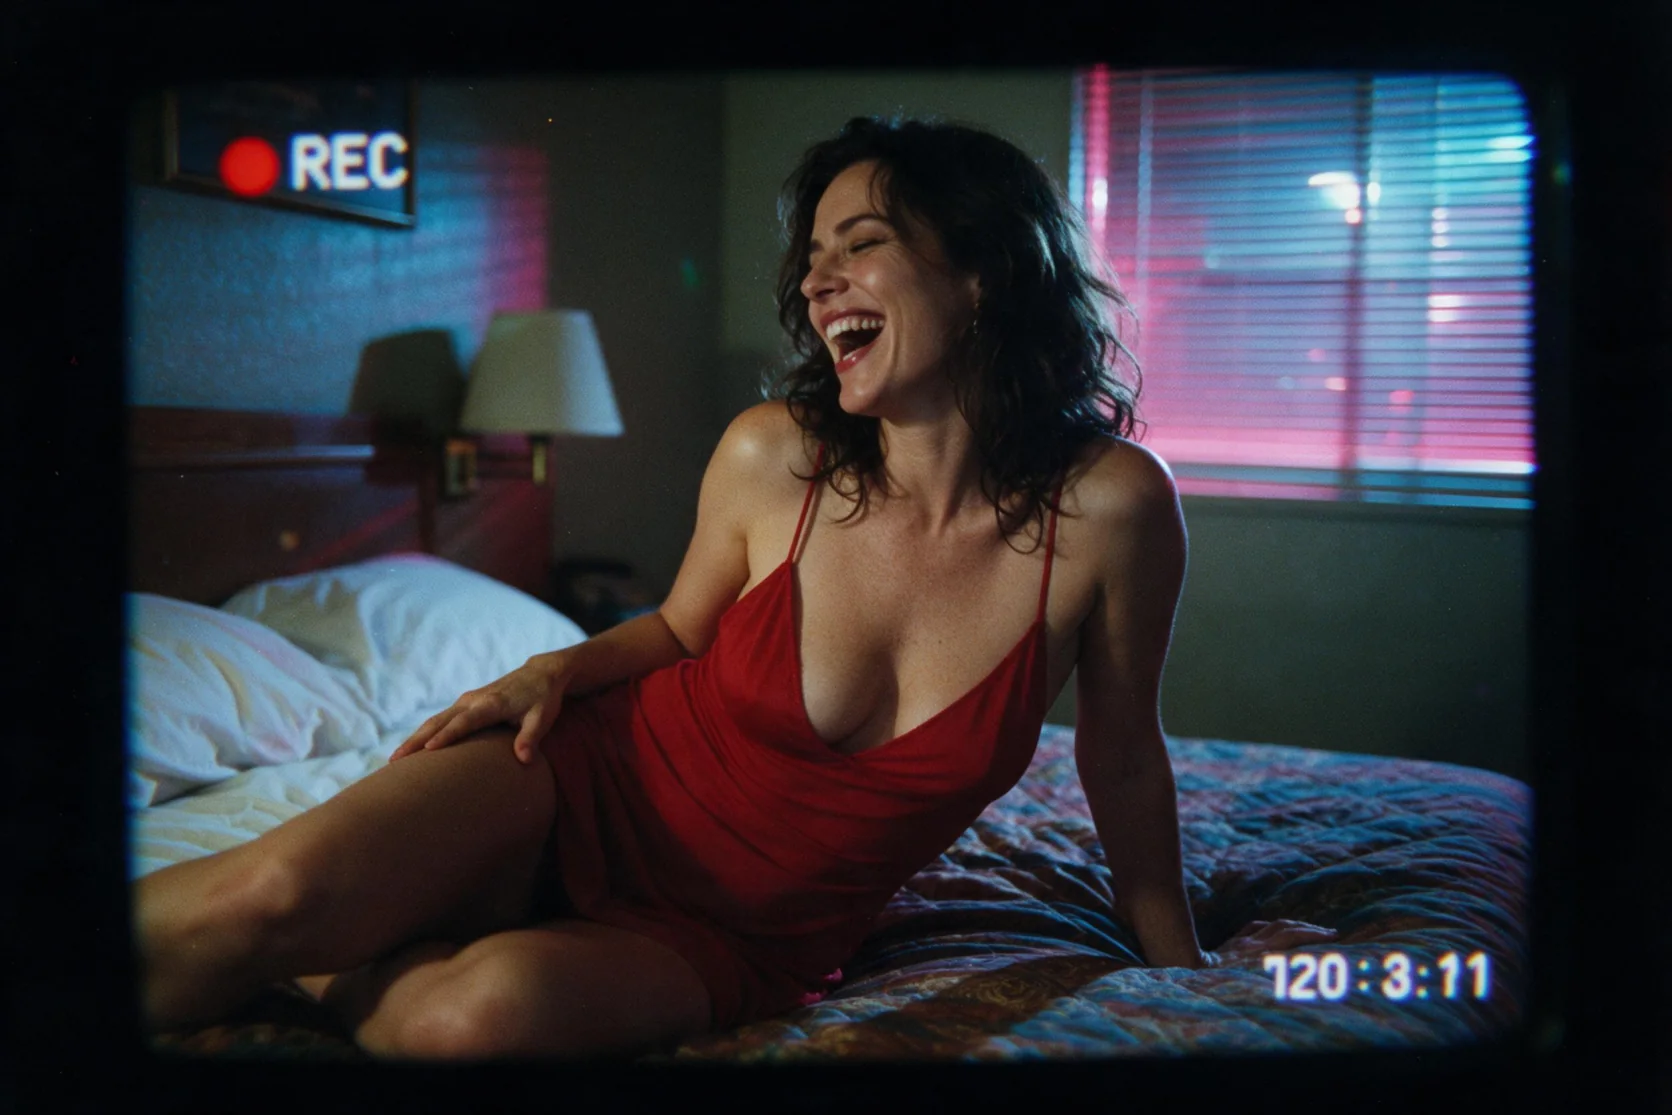
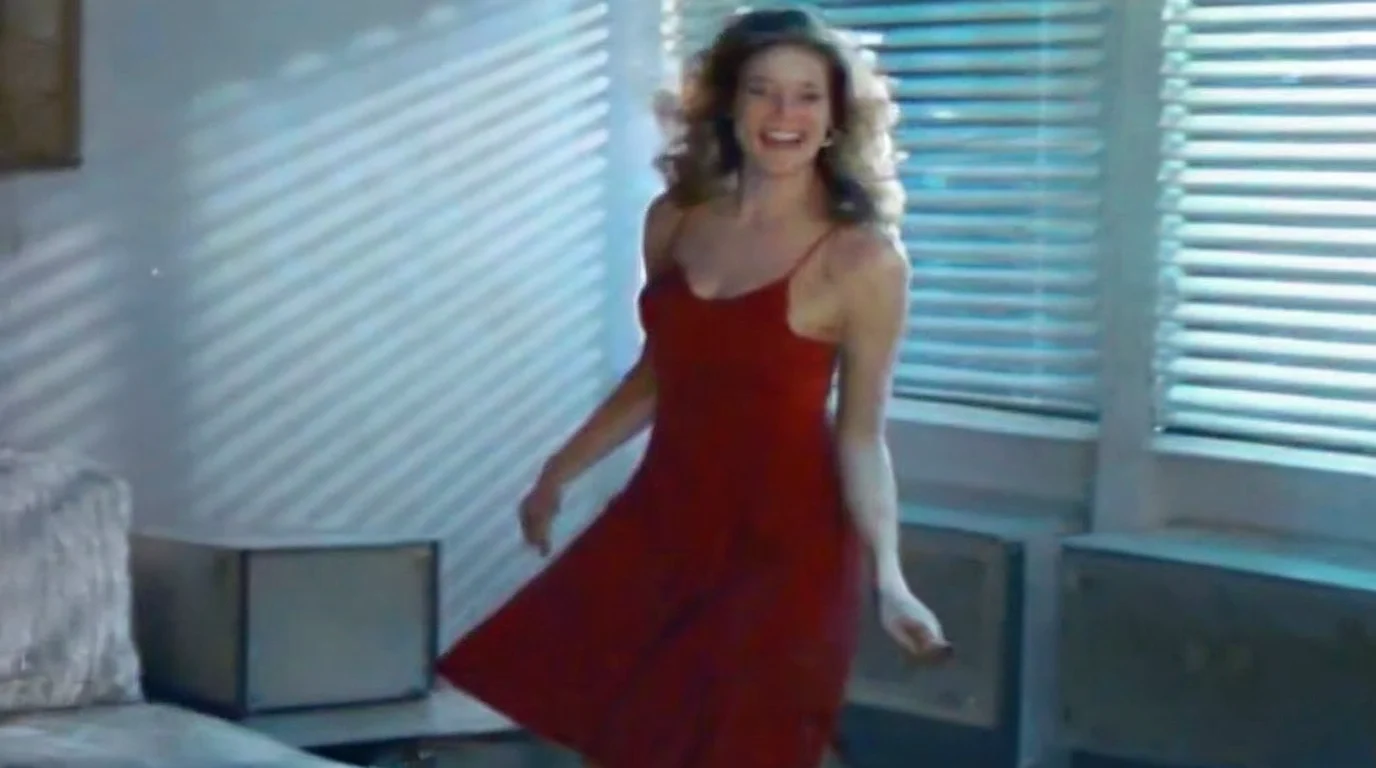
新しい 1k、16:9 のサンプルは、赤いスリップドレスの女性が夜のモーテルで踊る場面です。vh5tape と scale 1 の VHS LoRA によって、全体が柔らかな 1990 年代のホームビデオ風になりました。
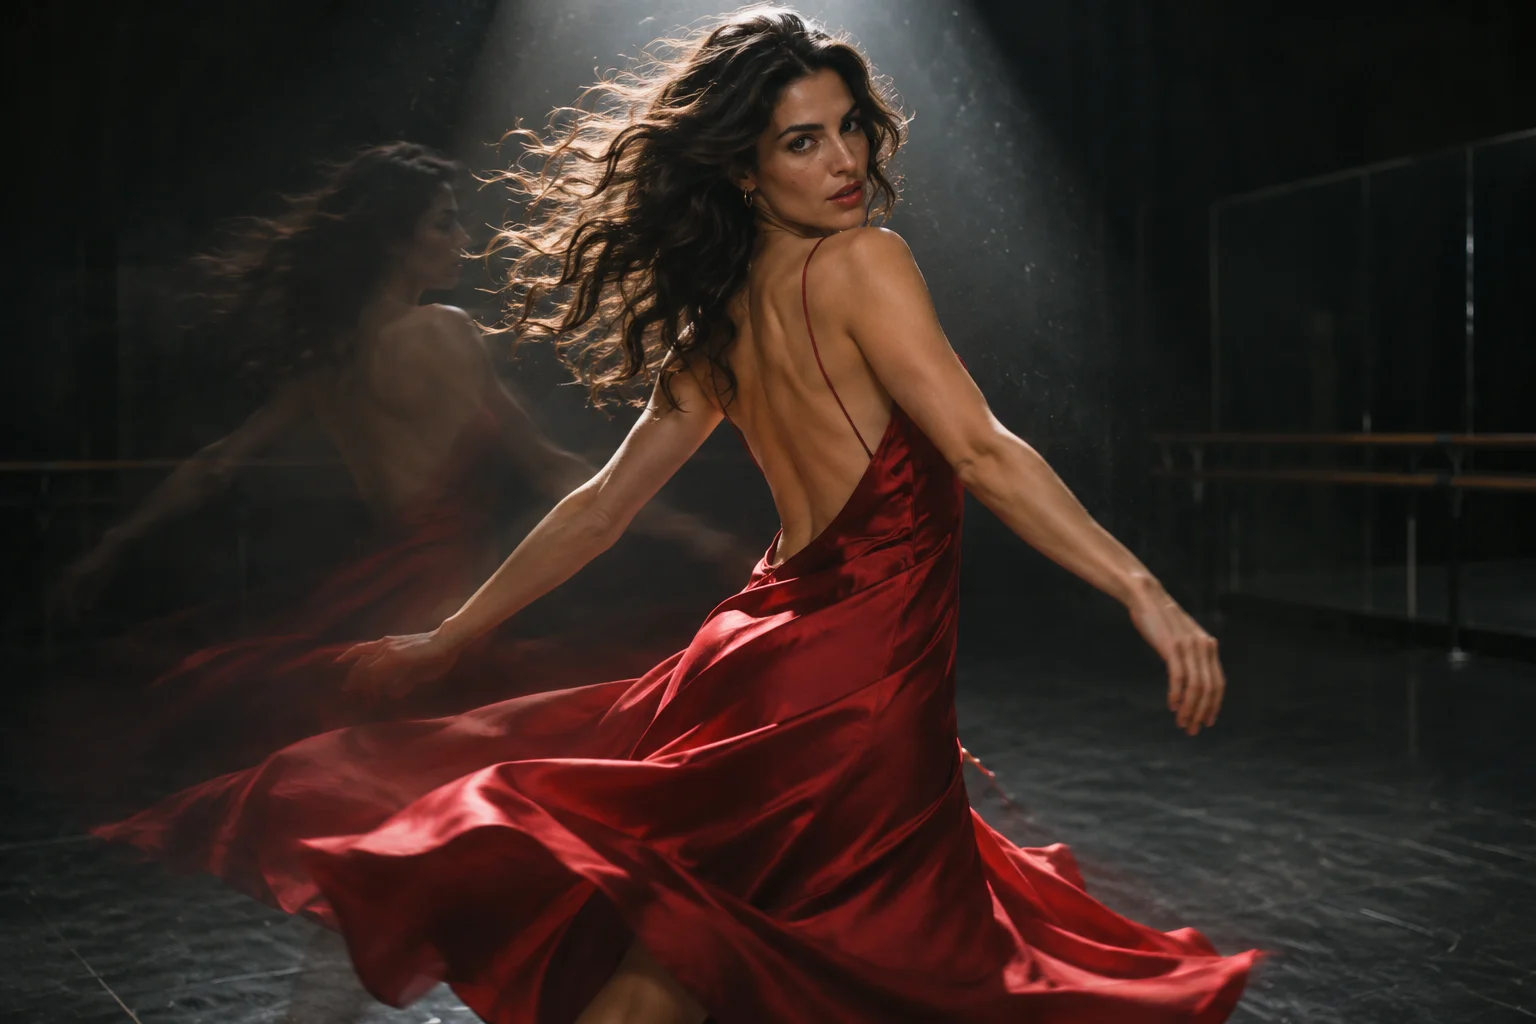
テープ表現が独自の文字を伴うことも
ダイナーのダンスには録画の粒子感と左下の vh5tape がありました。出力を選ぶ前に意図したスタイルだけでなく文字も確認すべき、目に見えるアーティファクトです。
柔らかな録画表現のレースゲーム
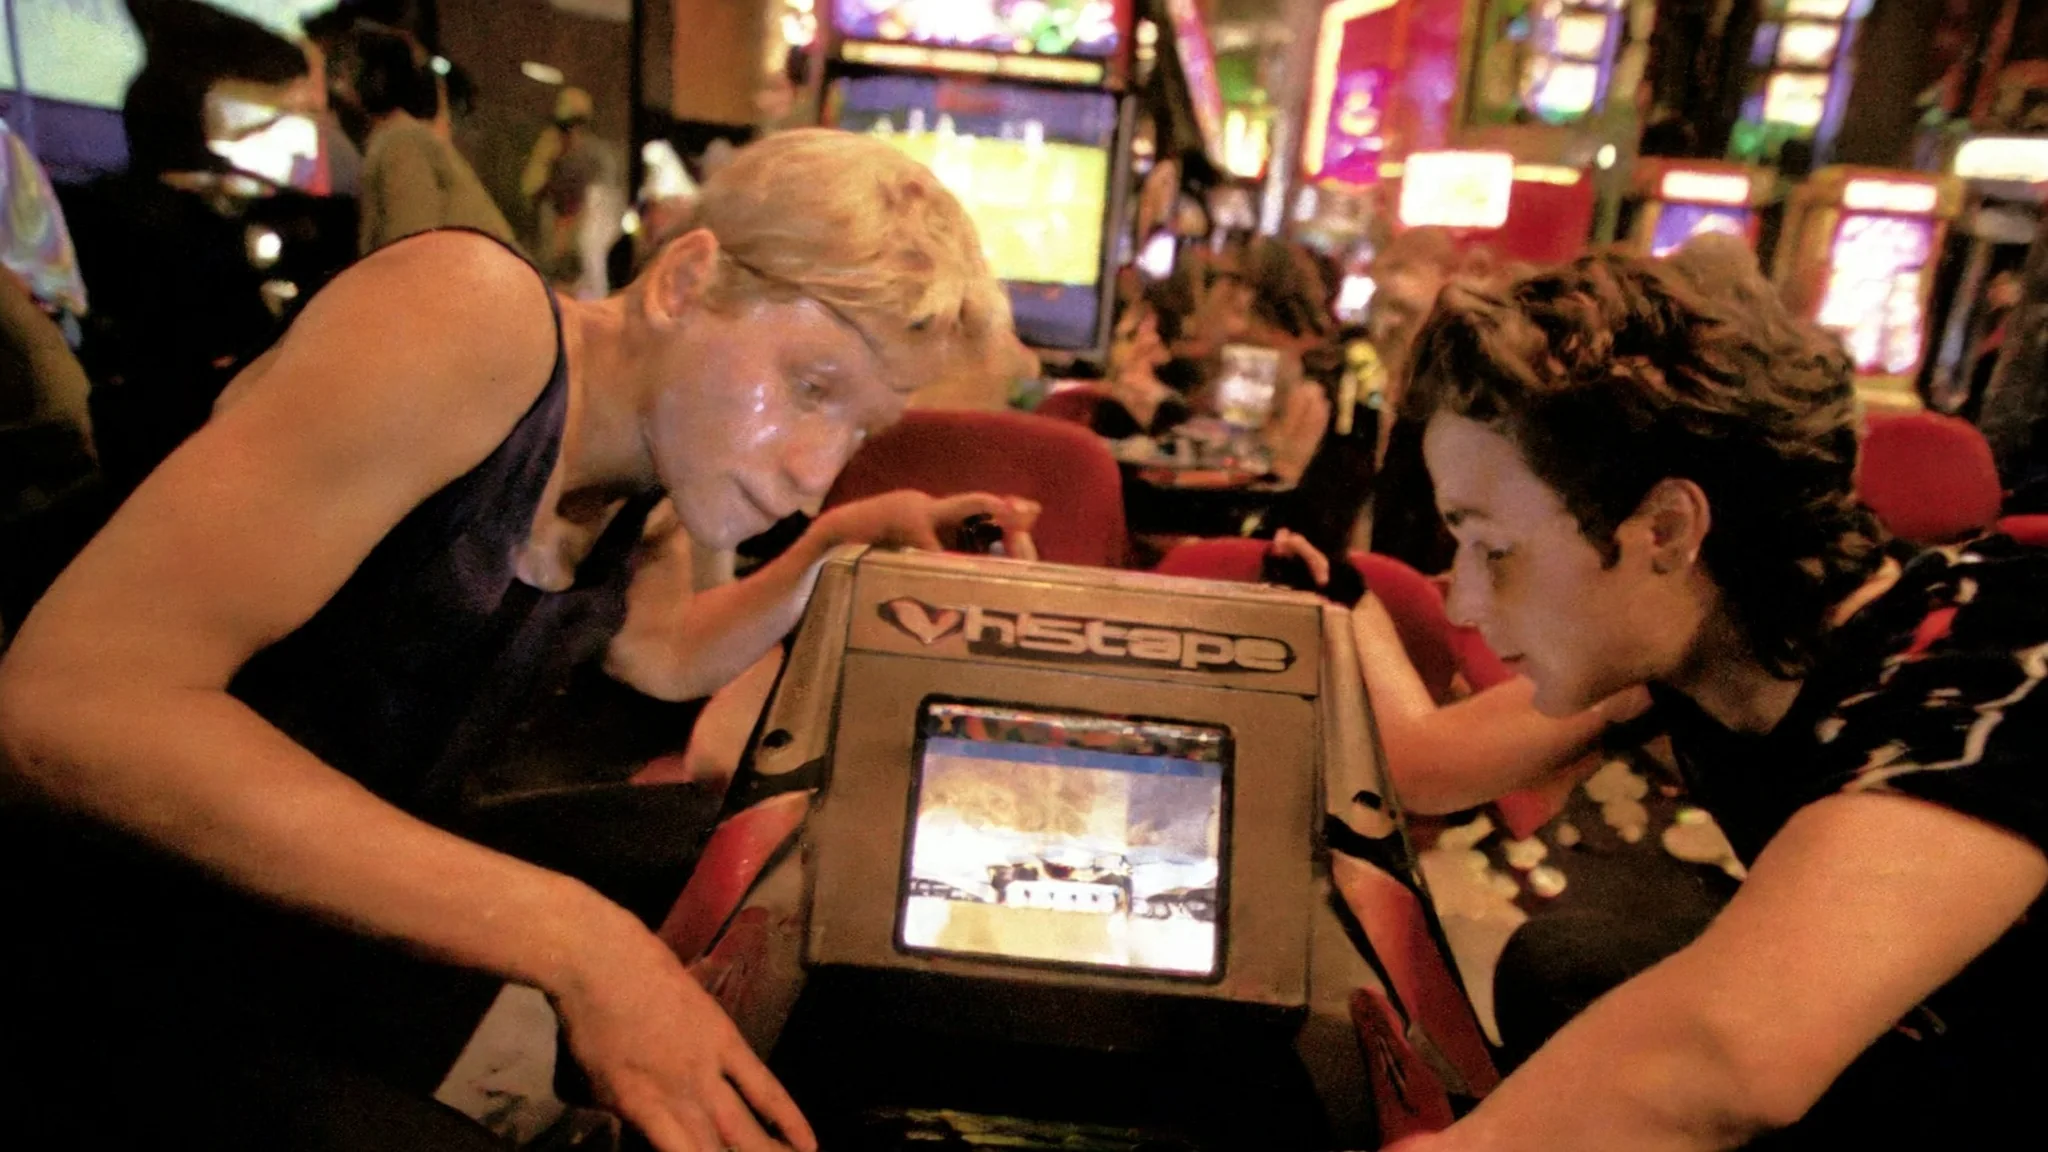
アーケードの例はネオンの中の 2 人のプレイヤーに VHS を適用しています。人物や周囲をアダプターがどう変えるか、別の場面でも評価できます。
港を違う描画表現に
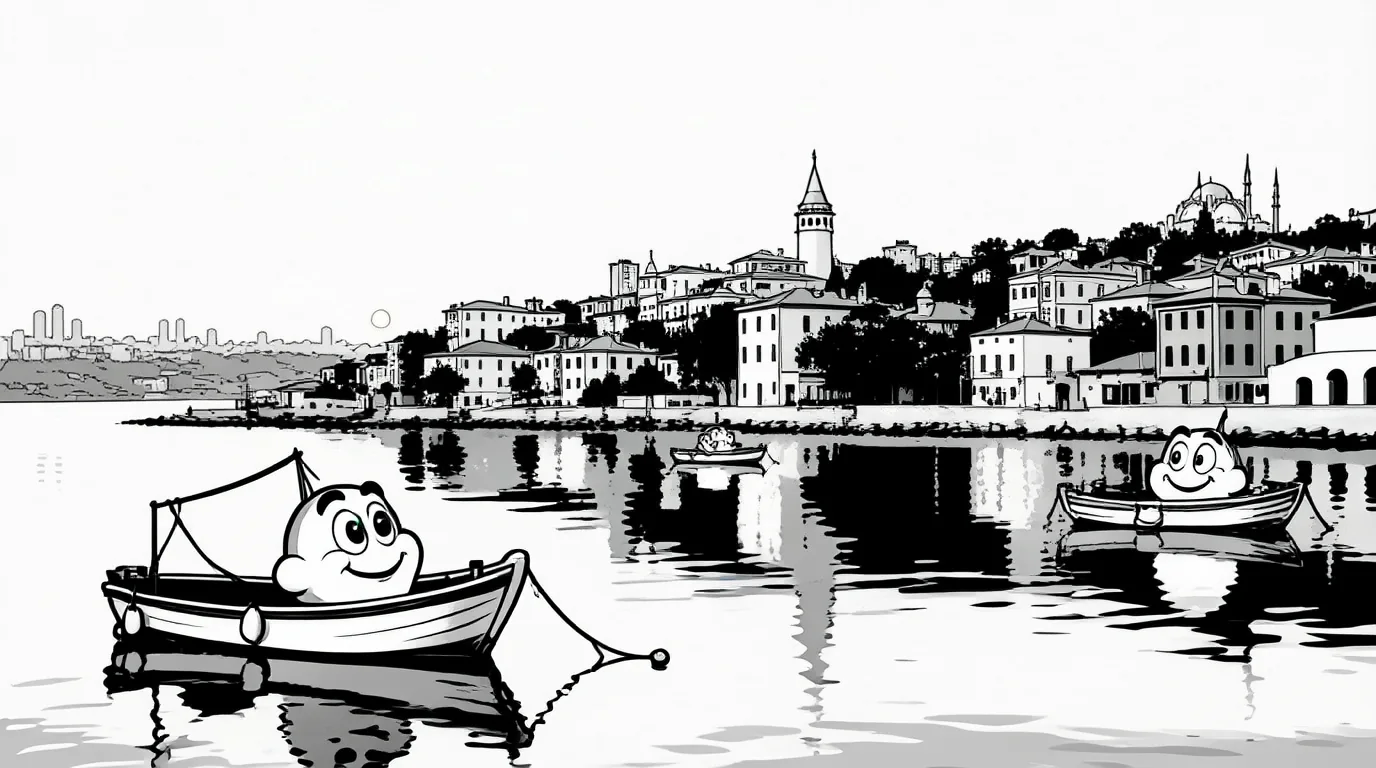
Studio1939 style の編集は、港を白黒のラバーホース風の船で描き直しました。この例では街並みの配置を認識できました。
リクエストパラメーター
| パラメーター | 必須 | 説明 |
|---|---|---|
prompt | はい | 最大 5,000 文字の文章が必須です。ウェイトのトリガーワードを先頭に、続いてシーンを書いてください。 1 文字以上 · 5000 文字以内 |
aspect_ratio | いいえ | 選択肢は 1:1、1:2、2:1、1:3、3:1、2:3、3:2、3:4、4:3、4:5、5:4、9:16、16:9、9:21、21:9 です。生成時の既定比率は 1:1 で、比率を変えても料金には影響しません。 |
resolution | いいえ | スタイル付き生成の既定は 1k です。より料金の高い段階として 1.5k・2k・3k・4k を選べます。 |
loras | いいえ | 任意で最大 3 個の {path, scale} を指定します。Hugging Face の /resolve/main/ リンクなど、.safetensors 本体の直接 URL を使ってください。 デフォルト値: |
output_format | いいえ | png か webp を選ばなければ、静止画は jpeg にエンコードされます。エンコードによる料金差はありません。 |
seed | いいえ | LoRA の適用あり・なしを比べるときに seed を任意で設定します。固定の既定値や数値の制限は記載されていません。 |
料金
完了した静止画には、公開ウェイト版の選択サイズ料金と固定の LoRA 加算額がかかります。添付が 0 個でも加算され、1 個と 3 個でも加算額は同じです。失敗したリクエストの料金はかかりません。
| 仕様 | 料金 |
|---|---|
| $0.042 / 枚 |
| $0.054 / 枚 |
| $0.066 / 枚 |
| $0.114 / 枚 |
| $0.162 / 枚 |
ユースケース
ネオンのモーテルの場面研究
赤いドレスのモーテル例は scale 1 の VHS LoRA で、夜のダンスを柔らかなカムコーダー風静止画にしました。テープ時代のムードボード用に、画面全体の表現を参考にできます。
既存写真のスタイルを変更
1930 年代カートゥーンの LoRA はポーズを残し、写真をラバーホース風にしました。港の関連例では街並みの配置が保たれています。
大きなサイズに進む前の比較
seed と場面説明を固定して LoRA を切り替えます。VHS の比較は質感と構図が変わったため、大きな解像度を選ぶ前に両方を評価します。
ポートレートの場所を見直す
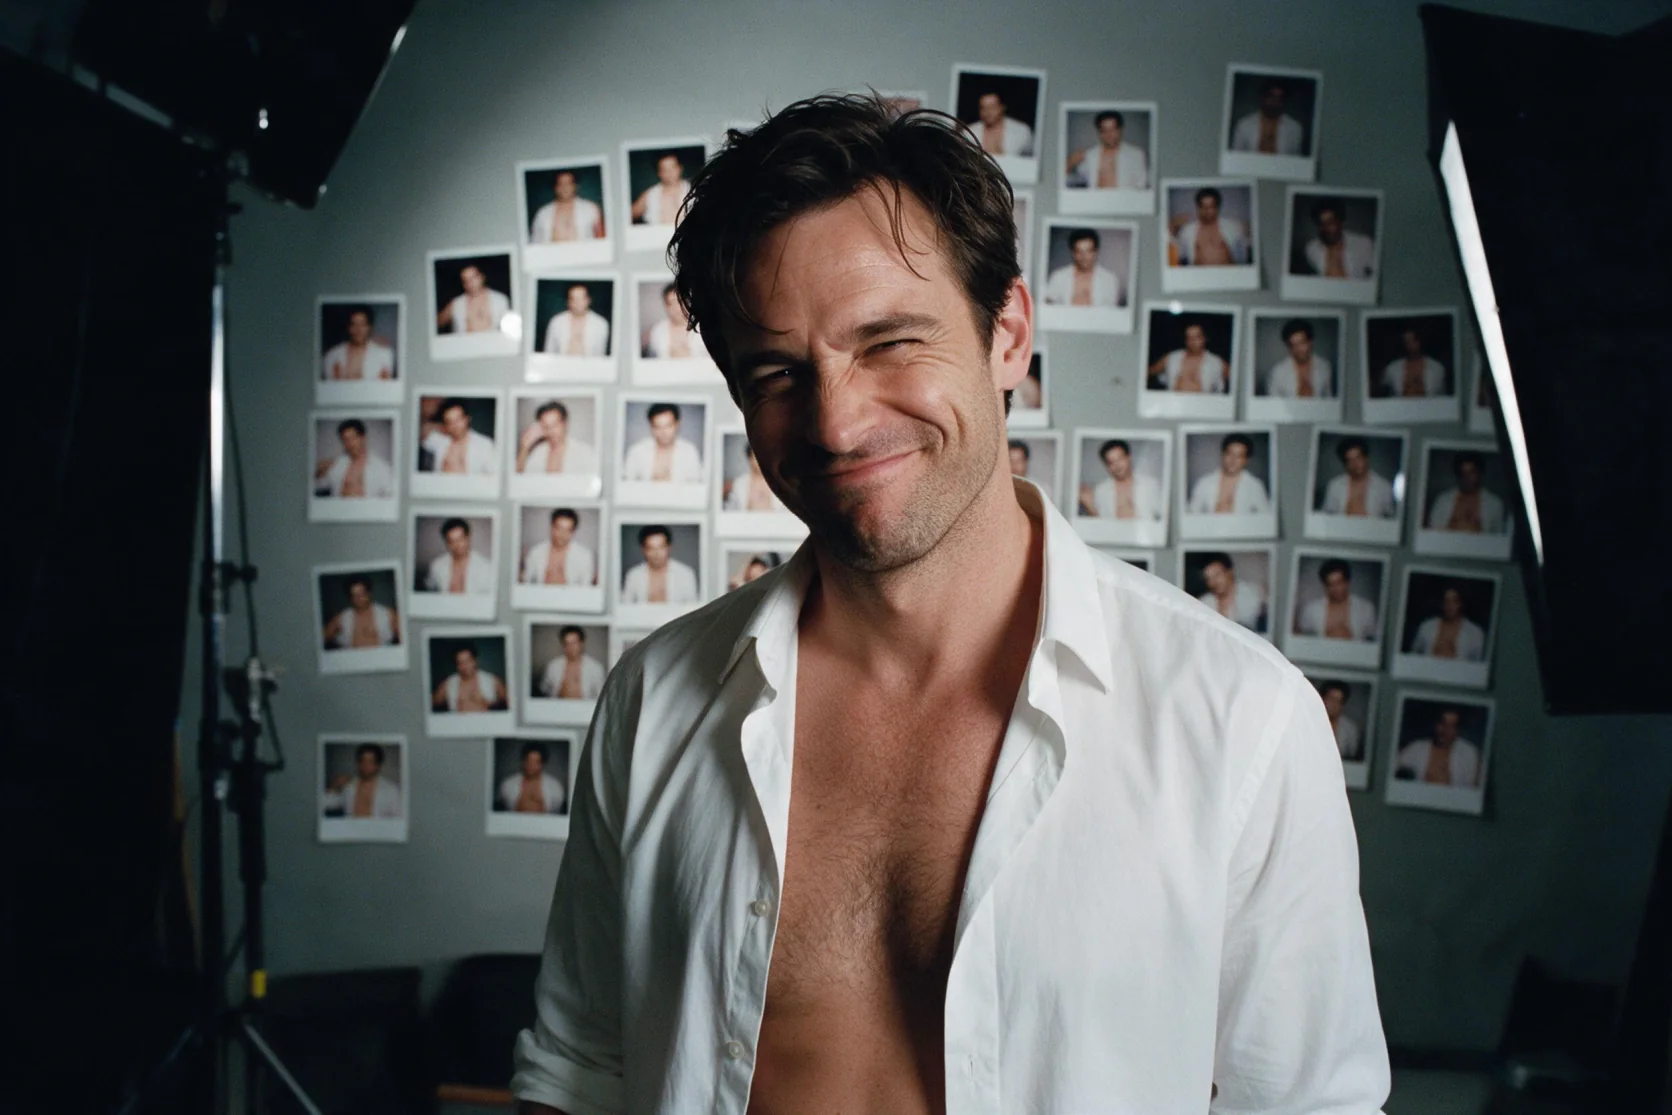
単一画像の服装・場所変更はテストで顔を保ちました。LoRA の表現は別に比較し、人物と周囲への影響を確かめます。
元画像と場面参照を合わせる
2 枚の合成はテストで成功しました。スタイル付きの合成を計画するなら、元画像を場面参照より先に置き、指示で各画像を指定します。
プロンプトガイドと実践のヒント
生成または編集を選択
生成は文章の場面から始め、編集は修正する写真を参照より先に渡します。編集の入力は最大 9 枚です。
取得できる LoRA を添付
path は .safetensors 本体に向け、必要に応じて Hugging Face の /resolve/main/ を使います。scale 1 から始め、ファイルごとに 0–4 を設定できます。1 回に最大 3 ファイルです。
場面と表現を説明
選んだ LoRA のトリガーを先頭に置き、服装、動作、光、周囲の詳しい英語を続けます。編集では元を <Picture 1>、後の参照を各番号で指定します。
比較して画面を点検
比率、解像度、形式を選び、seed を固定して LoRA の有無を比較します。スタイル、構図、不要な文字を確認してください。seed を固定しても出力の一致を確約するものではありません。
ウェイトの表現を加えて静止画を生成
MiniMax H3-Image Open Weights LoRA は文章から画像を作り、最大 3 つの LoRA ウェイトを受け付けます。モーテルやダイナーの VHS のように、アダプターによる見た目が必要な依頼に適しています。静止画を返し、動画や音楽は生成しません。
検証したアダプターは H3 動画モデル用でしたが、この画像チェックポイントにも効果がありました。そのファイルでの根拠で、すべての H3 アダプターの互換性の約束ではありません。既知のファイルと、服装、光、周囲を見やすい場面から始めます。
リクエストの操作
| パラメータ | 値と挙動 |
|---|---|
prompt | 必須、最大 5,000 文字。アダプターのトリガーを場面説明の前に置きます |
loras | path、scale の最大 3 項目で、直接取得できる .safetensors の URL を使います |
loras[].scale | ファイルごとに 0–4、既定は 1 です |
aspect_ratio | 1:1, 1:2, 2:1, 1:3, 3:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 9:21, 21:9。既定は 1:1 です |
resolution | 既定 1k、ほかに 1.5k、2k、3k、4k です |
output_format | 既定 jpeg、または png、webp です |
seed | 任意の比較設定で、同一結果は保証しません |
Hugging Face のリンクは /resolve/main/ とウェイトのファイル名へ向けます。リポジトリの概要では path に必要な本体を指定できません。トリガーは prompt、URL と scale は LoRA 項目に入れます。トリガーを書くだけでは添付できません。
表現を適用できる場面を書く
被写体、動作、衣服、場所、光をつながった英語で記述します。VHS なら vh5tape を先頭にし、30 代後半の女性が赤いスリップドレスでモーテルのブラインドの横で踊り、カメラへ笑い、マゼンタのネオンと暖かなベッドのランプ、1990 年代ホームビデオ風と説明できます。比率や解像度は本文に詰め込まず設定で選びます。
調整を 1 点ずつ比較
- 説明、画面、seed、ファイルリンクをまとめて残します。
- 添付ありと、その添付を外したリクエストを生成します。
- scale を変える前に質感、構図、表情、文字を確認します。
- 説明全体を書き換えず、次の比較では設定を 1 つ変えます。
seed の固定は変更の比較に役立ちますが、場面を凍結しません。VHS の比較ではテープの見た目と構図が変わりました。複数添付も、各々が独立した不変のレイヤーになると考えず、組み合わせた結果を評価します。
サンプルが示す範囲
新しいモーテル例は VHS の scale 1、vh5tape、seed 11、1k、16:9 です。赤いスリップドレスの女性のダンスが、全体に柔らかなカムコーダー風で返りました。アーケードは同じ表現を見る別の場面です。
ダイナーでは隅に vh5tape が現れました。アダプターが学習時の単語や透かしを持ち込む場合があります。出力を選ぶ前に端や背景の看板も確認します。H3-Image の短い看板やラベルは読めましたが、長文やすべてのアダプターでの文字を保証する観察ではありません。
料金と失敗したリクエスト
完成画像ごとに課金します。解像度段階が基本額を決め、大きいほど高くなり、この LoRA 版は Open Weights に固定額を加算します。添付が 0、1、3 個でも加算額は共通です。jpeg、png、webp で価格は変わりません。現行料金は モデルページ で確認します。
ファイル欠落のテストは Failed to load LoRA で止まり、代替画像はなく課金もされませんでした。失敗は課金対象外なので、次の試行前にダウンロードリンクを直してください。
境界と関連モデル
未知のアダプターは評価が必要です。観察したスタイル変更は、後の場面の人物、配置、きれいな文字を保証しません。コンテンツの試行は拒否がなかったものの一部が控えめで、標準の文章生成テストは LoRA なしのため、アダプターの挙動を示しません。
ウェイトなしで 5 段階と seed を使うなら Open Weights です。MiniMax H3-Image ではサイズが 3 段階、編集入力が最大 16 枚となり、seed の指定はできません。既存写真にはこのファミリーの image-to-image を使います。旧 H3 Image LoRA は動画モデルの単一フレーム生成で、この H3-Image チェックポイントとは異なります。P-H3-Image は別モデルで、同じ prompt でも同じ絵にはなりませんでした。
API クイックスタート
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "minimax/h3-image-open-lora/text-to-image",
  "input": {
    "aspect_ratio": "1:1",
    "output_format": "jpeg",
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette",
    "resolution": "1k"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
認証、完全なスキーマ、ポーリング、エラー処理は API リファレンスを参照してください。