はじめに
talking-avatar タスクに写真と録音を渡し、MP4 を作成します。任意のテキストで見える演技を指示し、resolution で出力グレードを、seed で比較用の条件を設定できます。
| 項目 | 値 |
|---|---|
| 入力 | 画像 音声 |
| 出力 | 動画 |
| モデルの選択 | ByteDance OmniHuman 1.5、talking-avatar |
| 必須の画像ファイル | JPEG / PNG / WebP、30 MB まで |
| 必須の音声ファイル | MP3 / WAV、15 MB まで、1〜60 秒 |
| プロンプト上限 | 2,000 文字、任意の映像演出 |
| 解像度の既定値と選択肢 | 既定値 1080p、720p も対応、単価共通 |
| seed の値 | 0〜2147483647、任意の比較補助 |
| 音声の課金 | 入力音声を整数秒へ切り上げ |
| 完了確認と形式 | タスク識別子、ポーリングまたはコールバック、MP4 |
| 保管期間 | 生成ファイルは 14 日後に削除 |
主な機能とハイライト
手のひらを上に向けてセリフを添えます
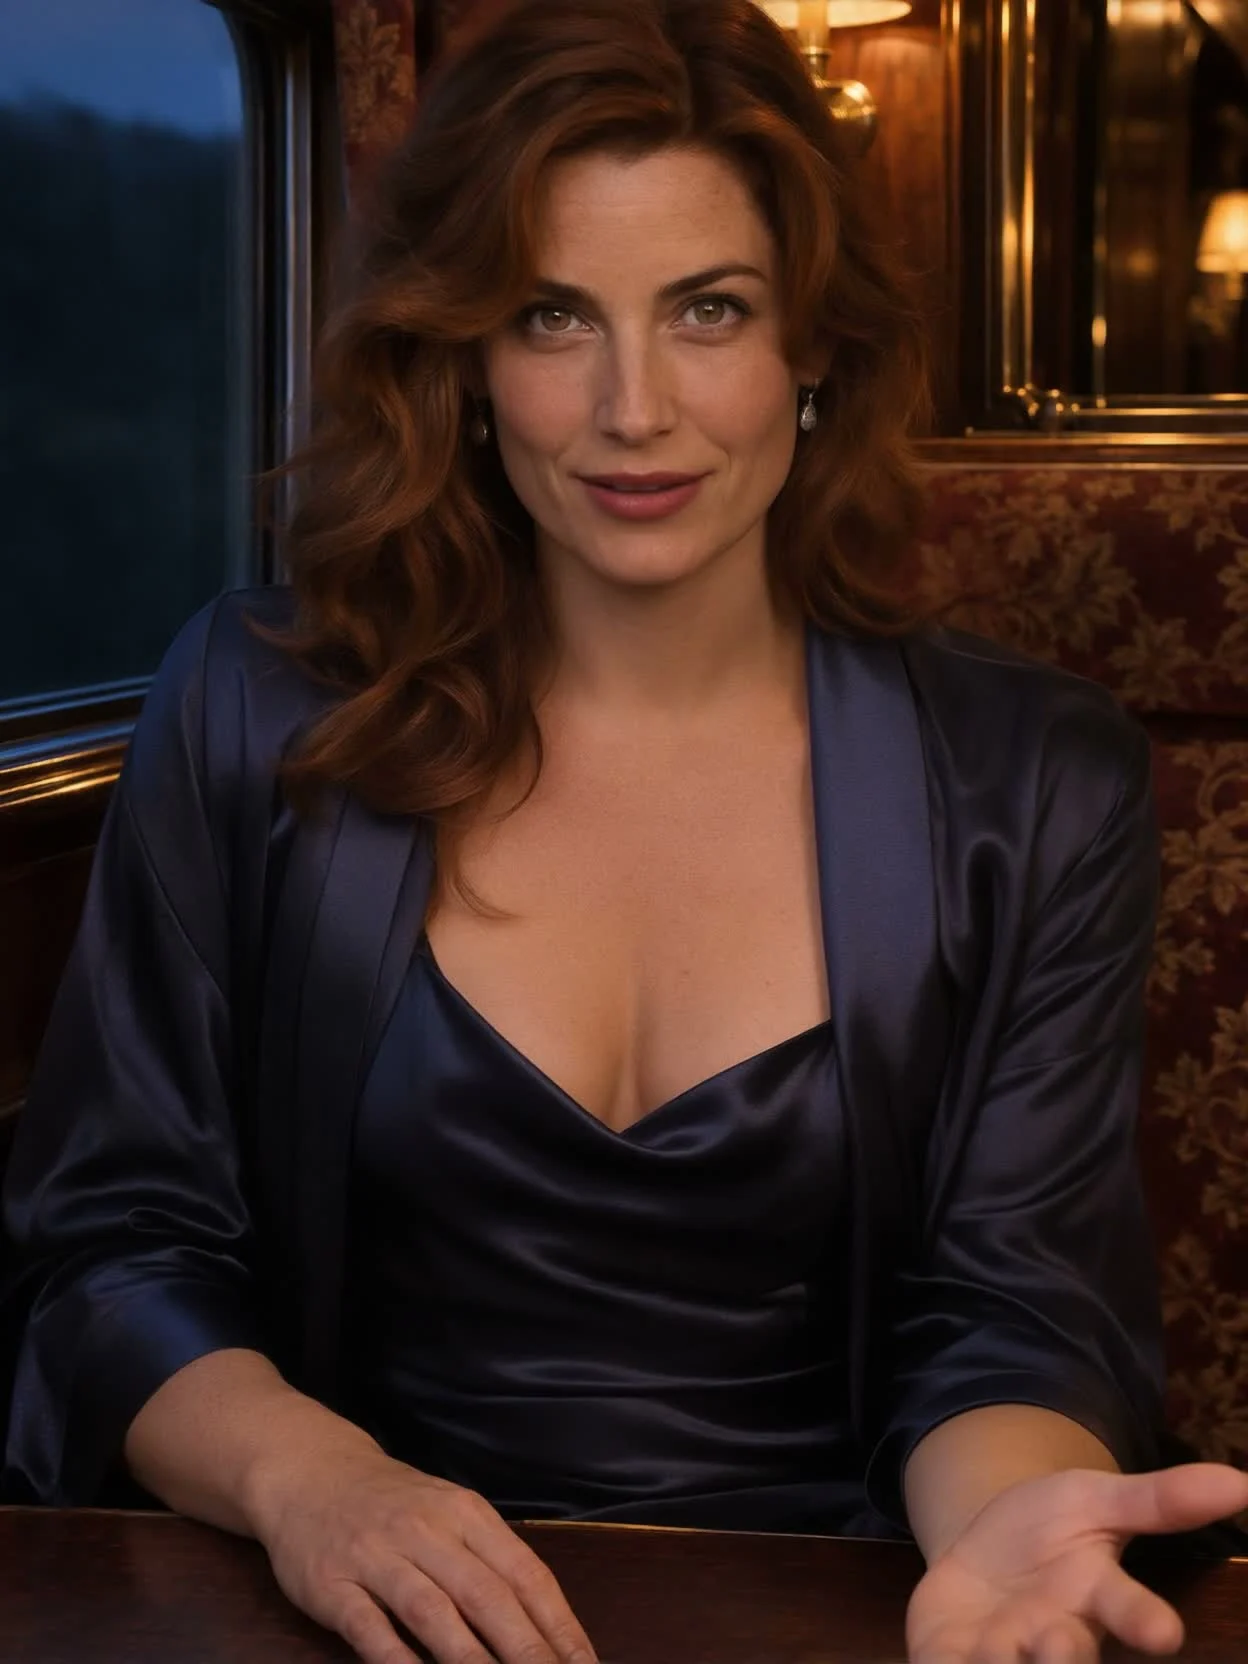
寝台列車のテストでは、静止した写真が話す演技へ変わり、片手を上向きに差し出して、うなずき、ほほえみました。1080p のリクエストに、6.35 秒の録音と動きの文章指示を組み合わせました。
ポートレートが 3:4 の動画になりました
1024×1536 の列車内の写真から、話者を腰上で捉えた 1248×1664、25 fps の動画ができました。カメラ固定を求めても構図が変わったため、編集に配置する前に結果を点検してください。
話す内容と見せ方を分けて用意します
実際の声とセリフは音声ファイルから来ます。ByteDance は、録音で演技を動かしながら、プロンプトで身振り、雰囲気、カメラを誘導できると説明しています。このエンドポイントは話者の声をクローンしません。
解像度は映像の選択です
既定の解像度は 1080p で、720p も使えます。どちらも同じ秒単価です。完成動画の実測尺ではなく、入力録音を切り上げて料金を求めます。
リクエストパラメーター
| パラメーター | 必須 | 説明 |
|---|---|---|
image_url | はい | talking-avatar に必須です。正面の顔が鮮明な、30 MB までの JPEG、PNG、WebP を使います。 1 文字以上 |
audio_url | はい | talking-avatar に必須の MP3 または WAV で、15 MB まで、1〜60 秒の発話や歌を渡します。既定値はありません。 1 文字以上 |
prompt | いいえ | talking-avatar の動作、表情、シーン、カメラを指示する任意のテキストで、上限は 2,000 文字です。既定の文章は指定されていません。 1 文字以上 · 2000 文字以内 |
resolution | いいえ | talking-avatar では 720p または 1080p を選びます。省略すると 1080p です。 |
seed | いいえ | talking-avatar の任意の整数で、0〜2147483647 を指定できます。既定値の指定はありません。 |
料金
$0.144 / 秒
1〜60 秒の入力音声を整数秒に切り上げて計算します。720p と 1080p は同じ単価です。画像の選択、プロンプト、seed による料金の変化はありません。
ユースケース
短い招待の演技を作る
手を動かす余白のある写真と、招待の録音を用意します。寝台列車の例では、指定した音声に合わせて手のひらを上げ、うなずき、ほほえむ様子を確認できます。
プレゼンターの説明を映像化
利用許可のあるプレゼンター写真に完成した説明音声を組み合わせ、小さなうなずきや手を開く身振りを指示します。顔を見やすくし、大切な言葉と動きの関係を確認してください。
写真の人物に歌ってもらう
同じ写真入力のタスクに、発話の代わりに歌の録音を渡せます。ByteDance は歌唱を対応用途に挙げていますが、ここで記録した試行はセリフの音声を使っています。
演技の指示を変えて比較
写真と録音をそろえたまま、表情や動作の指示を一つ変えます。比較の参考に seed を再利用できますが、同じフレームを期待せず、各動画を評価してください。
縦型の編集用に写真を準備
実測した 2 本は縦構図を保ちつつ、元画像とは異なるサイズになりました。レイアウトに組み込む前に、返された切り取り範囲と身振りの見える領域を確かめます。
プロンプトガイドと実践のヒント
両メディアを検証します
写真の形式と 30 MB の上限を確認し、MP3 または WAV 音声が 15 MB 以内、1〜60 秒かを確かめます。写る人物と入力の声を利用する権利も確認します。
写真タスクの入力を送ります
モデル名 bytedance/omnihuman-1.5/talking-avatar に
image_urlとaudio_urlを指定します。必要に応じて演技の指示や seed を加え、720p または既定の 1080p を選びます。音、身振り、構図を比べます
タスク識別子で完了を追い、MP4 を取得して元録音や求めた動作と照合します。保管期限の 14 日が過ぎる前に完成ファイルを保存してください。
写真を起点にした発話動画
ByteDance の OmniHuman 1.5 は、写真と録音済みの発話や歌から MP4 を作ります。ByteDance は、録音の感情と意味に応じて表情、身振り、体の動きが生まれると説明しています。任意の文章プロンプトで、見える動作、表情、シーン、カメラの挙動も指示できます。
写真入力の処理には bytedance/omnihuman-1.5/talking-avatar を使います。声と言葉を提供するのは録音です。声のクローンや、プロンプト内の台本の読み上げは行いません。動画を依頼する前に音声全体を完成させてください。
パラメータの役割
| フィールド | 必須と受け付ける値 | 既定値と課金への影響 |
|---|---|---|
image_url | 必須の写真です。JPEG、PNG、WebP、30 MB までで、正面の顔が明瞭なものを選びます | 既定の画像はありません。料金は音声で計測します |
audio_url | 必須の MP3 または WAV です。15 MB 以内、1〜60 秒で、発話も歌も使えます | 既定の録音はありません。尺を整数秒へ切り上げて課金します |
prompt | 任意で 2,000 文字までの動作、表情、シーン、カメラの指示です | 既定文は指定されていません。指示を追加しても単価は同じです |
resolution | 任意で 720p または 1080p を選びます | 省略時は 1080p で、どちらも同じ単価です |
seed | 比較に使う任意の整数で、0〜2147483647 です | 既定値の指定はなく、価格への影響もありません |
talking-avatar タスクのフィールドはこの 5 つです。上半身と手が写った写真なら、求める身振りを画像内で行う余地があります。これらの設定に縦横比の専用フィールドはありません。元と同じ切り取り範囲を想定せず、出力構図を確認します。
写真、録音、演出を用意します
演技が見える範囲を選びます
顔が見る側を向いた、鮮明な写真を選んでください。手のひらを上に向ける招待など、手の身振りが大切なら手も入れます。肖像と声の許可はそれぞれ確認します。映る人物は全員成人でなければならず、誰かになりすます結果を作ってはいけません。
写真は対応形式と容量上限に収めてください。うなずき、開いた手のひら、セリフ末尾のほほえみなど、評価したい動きがわかるよう写真に合う演出を考えます。動作とともに生成後の構図も見直します。
プロンプトを書く前に音を完成させます
MP3 または WAV を全編聞き、長さを測ります。受付は 60 秒までですが、ByteDance は品質のため 15 秒以下を勧めています。音声が予定する動画尺と課金数量を決めるので、使わない部分を除いてください。
演技の指示は prompt に書き、セリフは audio_url の録音に入れます。ByteDance が挙げる文章プロンプトの言語は、中国語、英語、日本語、韓国語、スペイン語、インドネシア語です。これはプロンプト言語の案内で、ここで測定した発話言語の一覧ではありません。
条件をそろえて比較するなら、seed を再利用して指示を一つだけ変え、他の入力は保ちます。seed は変更を比較する助けになりますが、繰り返しのリクエストで動画が一致する保証はありません。
録音に応じた料金
1〜60 秒の入力音声を、次の整数秒に切り上げて料金を求めます。既定の 1080p から 720p に変えても単価は下がりません。写真、任意のプロンプト、seed も音声秒数によるこの規則を変えません。現在の価格は OmniHuman 1.5 のモデルページで確認してください。
寝台列車の例は音声 6.35 秒なので、課金数量は 7 秒です。返された動画は 6.44 秒でしたが、料金にはレンダリング後の尺ではなく送信した録音を使いました。リクエストの照合では、この二つの計測を区別してください。
サンプルで確認した内容
sleeper-train-stay は、ネイビーのシルクを着た赤褐色の髪の女性の、列車内の写真 1024×1536 に短い招待を組み合わせた例です。1080p を指定し、カメラを固定したまま、ほほえみ、招く手の動き、開いた両手、うなずきを求めました。
テストでは、録音に口元を合わせて話しながら、片手のひらを上げ、うなずき、ほほえみました。結果は 1248×1664、25 fps、6.44 秒です。話者を腰上で捉えた 3:4 の構図に変わりました。観察記録は手を上げる動きとうなずきを確認していますが、すべての指示動作や構図の条件が正確に実現したことを示してはいません。
別の 720p の試行では、832×1248 の写真と 4.55 秒のセリフを組み合わせました。出力は縦構図を保った 832×1120、25 fps、4.52 秒でした。これらは測定した 2 本のサイズで、各解像度の名称が固定ピクセル数を約束するものではありません。
送信、取得、保存を行います
タスクは非同期で動きます。送信時にタスク識別子を受け取り、ポーリングかコールバックで完了情報を取得します。終了後に MP4 を取り出し、元録音と並べて手の動き、顔、構図、最後の瞬間を見てください。
生成ファイルの保管は 14 日で終わり、その後削除されます。採用する動画は期間内にダウンロードし、演技を再検討する場合に備えて入力設定も残します。
別の OmniHuman を検討するなら、OmniHuman 2.0を参照できます。InfiniteTalkと VEED Fabric 1.0も関連する写真アニメーションのページです。入力と制限を確認して選んでください。今回の OmniHuman 1.5 の試行は、これらとの画質や処理時間の順位付けではありません。
API クイックスタート
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "bytedance/omnihuman-1.5/talking-avatar",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "image_url": "https://example.com/reference.png",
    "resolution": "1080p"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
認証、完全なスキーマ、ポーリング、エラー処理は API リファレンスを参照してください。